
统计学习方法(李航)朴素贝叶斯python实现
本文实现了李航教授的《统计学习方法》一书中第4章朴素贝叶斯法中的算法,包括算法4.1(朴素贝叶斯算法)和在此基础上改进的贝叶斯估计。文末整理了在实现算法过程中遇到问题记录的笔记。
朴素贝叶斯法
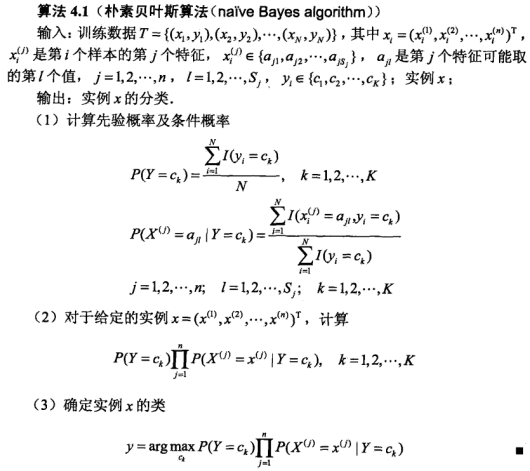
首先训练朴素贝叶斯模型,对应算法4.1(1),分别计算先验概率及条件概率,分别存在字典priorP和condP中(初始化函数中定义)。其中,计算一个向量各元素频率的操作反复出现,定义为count函数。
# 初始化函数定义了先验概率和条件概率字典,并训练模型

def __init__(self, data, label):

    self.priorP = {}

    self.condP = {}

    self.train(data, label)
count函数,输入一个向量,输出一个字典,包含各元素频率
# 给一个向量,返回字典,包含不同元素的频率。可以引用collections中的Counter函数来实现

# 这个函数可以改进,懒得弄了

def count(self, vec):

    np.array(vec)

    keys = np.unique(vec)

    p = {}

    for key in keys:

        n = np.sum(np.isin(vec, key) + 0)  # 加0可以使布尔向量变为0-1向量

        p[key] = n/len(vec)  # 计算频率

    return p
训练函数,关于condP的保存下面有详细说明
def train(self, data, label):

    m, n = np.shape(data)

    # 计算先验概率

    self.priorP = self.count(label)

    print("priorP:", self.priorP)

    # 计算条件概率

    classes = np.unique(label)

    for c in classes:

        subset = [data[i] for i in range(m) if label[i] == c]  # 取Y=ck的子集

        for j in range(n):  # 遍历每一个特征,分别求条件概率

            self.condP[str(c)+" "+str(j)] = self.count([x[j] for x in subset])

    print("condP:", self.condP)
对于条件概率condP的保存,将每个特征关于Y=ck的条件概率都存为一个字典,再存入字典condP中,key设为 “ck j” ,其中 ck 为 Y 的类别,j 表示第 j 个特征。训练例4.1得到的模型如下, condp中的'-1 0' 项即表示Y=-1条件下,P(x0=1)=0.5, P(x0=2)=0.333, P(x0=3)=0.166. 为了显示方便,只给出了小数点后3位。
priorP: {-1: 0.4, 1: 0.6}

condP: {'-1 0': {1: 0.5, 2: 0.333, 3: 0.166},

        '-1 1': {'L': 0.166, 'M': 0.333, 'S': 0.5},

        '1 0': {1: 0.222, 2: 0.333, 3: 0.444},

        '1 1': {'L': 0.444, 'M': 0.444, 'S': 0.111}}
训练之后,对给定X进行预测,结果保存在字典preP中
def predict(self, x):

    preP = {}

    for c in self.priorP.keys():

        preP[c] = self.priorP[c]

        for i, features in enumerate(x):

            preP[c] *= self.condP[str(c)+" "+str(i)][features]

    print("probability: ", preP)

    print("prediction: ", max(preP, key=preP.get))
结果:
probability:  {-1: 0.06666666666666667, 1: 0.02222222222222222}

prediction:  -1
贝叶斯分类
考虑到概率可能为0,在随机变量各个取值的频数上赋予一个正数lamda,lamda为0时即为极大似然估计;lamda取1时称为拉普拉斯平滑。
先验概率变为(a)

条件概率变为(b)

在之前的算法基础上改进,添加一个字典变量rangeOfFeature来保存每个特征的取值个数,定义在初始化函数中。
self.rangeOfFeature = {} # 保存每个特征的取值个数
公式(a)和(b)形式相同,将 K 或Sj 作为参数传入count函数,lamda缺省为0:
def count(self, vec, classNum, lamda=0):

    keys = set(vec)

    p = {}

    for key in keys:

        n = np.sum(np.isin(vec, key) + 0)

        p[key] = (n+lamda)/(len(vec)+classNum*lamda)

    return p
训练函数变为
def train(self, data, label, lamda=0):

    m, n = np.shape(data)

    # 计算rangeOfFeature

    for j in range(n):

        self.rangeOfFeature[j] = len(set([x[j] for x in data]))

    classes = set(label)

    # 计算先验概率

    self.priorP = self.count(label, len(classes), lamda)

    print("priorP:", self.priorP)

    # 计算条件概率

    for c in classes:

        subset = [data[i] for i in range(m) if label[i] == c]

        for j in range(n):

            self.condP[str(c)+" "+str(j)] = self.count([x[j] for x in subset], self.rangeOfFeature[j], lamda)

    print("condP:", self.condP)
其他不变,对之前的实例运行
bayes = Bayes(dataSet, labels, 1)

bayes.predict([2, "S"])
结果如下:
probability:  {1: 0.0326797385620915, -1: 0.06100217864923746}

prediction:  -1
笔记
贝叶斯定理

max(dict, key = dict.get)获得字典dict中value最大的值的键bool型列表转换为0-1
- 变量后加0
booldata.astype(int)类型转换
for i, value in enumerate(['A', 'B', 'C']):把list变成索引-元素对用enumerate函数,这样就可以在for循环中同时迭代索引和元素本身[a[j] for a in data]取data第 j 列np.isin(a,b)判断a中每个元素是否在b中,返回与a形状相同的bool数组np.unique(a)去重并排序
代码下载:3-Bayes.py
统计学习方法(李航)朴素贝叶斯python实现的更多相关文章
- 朴素贝叶斯python代码实现(西瓜书)
朴素贝叶斯python代码实现(西瓜书) 摘要: 朴素贝叶斯也是机器学习中一种非常常见的分类方法,对于二分类问题,并且数据集特征为离散型属性的时候, 使用起来非常的方便.原理简单,训练效率高,拟合效果 ...
- 机器学习:朴素贝叶斯--python
今天介绍机器学习中一种基于概率的常见的分类方法,朴素贝叶斯,之前介绍的KNN, decision tree 等方法是一种 hard decision,因为这些分类器的输出只有0 或者 1,朴素贝叶斯方 ...
- 朴素贝叶斯python小样本实例
朴素贝叶斯优点:在数据较少的情况下仍然有效,可以处理多类别问题缺点:对于输入数据的准备方式较为敏感适用数据类型:标称型数据朴素贝叶斯决策理论的核心思想:选择具有最高概率的决策朴素贝叶斯的一般过程(1) ...
- 朴素贝叶斯python实现
概率论是非常多机器学习算法基础,朴素贝叶斯分类器之所以称为朴素,是由于整个形式化过程中仅仅做最原始.简单的如果. (这个如果:问题中有非常多特征,我们简单如果一个个特征是独立的.该如果称做条件独立性, ...
- 朴素贝叶斯算法--python实现
朴素贝叶斯算法要理解一下基础: [朴素:特征条件独立 贝叶斯:基于贝叶斯定理] 1朴素贝叶斯的概念[联合概率分布.先验概率.条件概率**.全概率公式][条件独立性假设.] 极大似然估计 ...
- 统计学习方法与Python实现(三)——朴素贝叶斯法
统计学习方法与Python实现(三)——朴素贝叶斯法 iwehdio的博客园:https://www.cnblogs.com/iwehdio/ 1.定义 朴素贝叶斯法是基于贝叶斯定理与特征条件独立假设 ...
- 统计学习方法——第四章朴素贝叶斯及c++实现
1.名词解释 贝叶斯定理,自己看书,没啥说的,翻译成人话就是,条件A下的bi出现的概率等于A和bi一起出现的概率除以A出现的概率. 记忆方式就是变后验概率为先验概率,或者说,将条件与结果转换. 先验概 ...
- 【机器学习速成宝典】模型篇05朴素贝叶斯【Naive Bayes】(Python版)
目录 先验概率与后验概率 条件概率公式.全概率公式.贝叶斯公式 什么是朴素贝叶斯(Naive Bayes) 拉普拉斯平滑(Laplace Smoothing) 应用:遇到连续变量怎么办?(多项式分布, ...
- 统计学习1:朴素贝叶斯模型(Numpy实现)
模型 生成模型介绍 我们定义样本空间为\(\mathcal{X} \subseteq \mathbb{R}^n\),输出空间为\(\mathcal{Y} = \{c_1, c_2, ..., c_K\ ...
随机推荐
- CTO的职责,以及Goolge内部流程
我先做一下自我介绍,我是 2007 年加入的 Google,在 Moutain View 总部任 Google SRE,今年年初回国加入 Coding. 在 Google 我参与了两个 Project ...
- 浅谈网络爬虫爬js动态加载网页(一)
由于别的项目组在做舆情的预言项目,我手头正好没有什么项目,突然心血来潮想研究一下爬虫.分析的简单原型.网上查查这方面的资料还真是多,眼睛都看花了.搜了搜对于我这种新手来说,想做一个简单的爬虫程序,所以 ...
- Hadoop集群(第3期)机器信息分布表
1.分布式环境搭建 采用4台安装Linux环境的机器来构建一个小规模的分布式集群. 图1 集群的架构 其中有一台机器是Master节点,即名称节点,另外三台是Slaver节点,即数据节点.这四台机器彼 ...
- Dev C++ 工程没有调试信息 解决办法
Dev C++ 工程没有调试信息 解决方法DevC++4.9.9.2中,按 F8 开始调试.提示信息为:工程没有调试信息,您想打开工程的调试选项并重新生成吗?选择是后,再按F8,仍旧是这个信息.什么原 ...
- 解码mmo游戏服务器三:大地图同步(aoi)
问题引入:aoi(area of interest).在大地图中,玩家只需要关心自己周围的对象变化,而不需要关心距离较远的对象的变化.所以大地图中的数据不需要全部广播,只要同步玩家自己视野范围的消息即 ...
- 11 CSS的三种引入方式和基本选择器
<!-- 整体说明: 1.CSS的三种引入方式 (1)行内样式 (2)内接样式 (3)外接样式 2.CSS的基本选择器 (1)id选择器 (引用方式:#id) (2)标签选择器(引用方式:标签名 ...
- 【前端工具】页面加载获取url param
例如跳转进入一个页面: https://mp.csdn.net/postedit/74766644?name=catalina&flag=1 函数: function getParam(par ...
- idea创建类报错
创建类报错: 在idea.exe.vmoptions 或 idea64.exe.vmoptions中加入配置 -Djdk.util.zip.ensureTrailingSlash=false jar包 ...
- composer使用本地仓库
{ "repositories": { "sms": { "type": "path", "url" ...
- 安装R和Rstudio后,Rstudio出现空白和fatal error问题
解决方法: 1.一定要以管理员方式启动Rstudio 2.只能安装一个R版本,之前安装的其他版本需要卸载干净 3.R和Rstudio需要安装在同一目录下