
spark-2.1.1 yarn(高可用)搭建
一、概述
spark分布式搭建方式大致分为三种:standalone、yarn、mesos。三种分类的区别这里就不一一介绍了,不明白可自行了解。standalone是官方提供的一种集群方式,企业一般不使用。yarn集群方式在企业中应用是比较广泛的,这里也是介绍yarn的集群安装方式。mesos安装适合于超大型集群。
集群节点分配:
hadoop01:Zookeeper、NameNode(active)、ResourceManager(active)
hadoop02:Zookeeper、NameNode(standby)
hadoop03:Zookeeper、 ResourceManager(standby)
hadoop04: DataNode、 NodeManager、 JournalNode、 spark
hadoop05: DataNode、 NodeManager、 JournalNode、 spark
hadoop06: DataNode、 NodeManager、 JournalNode、 spark
二、安装
说明一下:
①选spark的时候要注意与hadoop版本对应。因为hadoop用的是2.7的,所以spark选的是spark-2.1.1-bin-hadoop2.7
②因为spark基于yarn来管理,spark只能安装在NodeManager节点上。
③spark安装放在/home/software目录下。
1、hadoop基于yarn(ha)的搭建,这里介绍步骤了。在我的上一个教程里有详细介绍。
2、安装scala,并配置好环境变量。
3、在NodeManager节点上解压spark文件。
tar -xvf spark-2.1.1-bin-hadoop2.7
3、修改spark-2.1.1-bin-hadoop2.7/conf/spark-env.sh,在文件尾部加上以下内容,其中HADOOP_CONF_DIR是必填项
export JAVA_HOME=/home/jack/jdk1.8.0_144
export SCALA_HOME=/home/jack/scala-2.12.3
export HADOOP_HOME=/home/software/hadoop-2.7.4
export HADOOP_CONF_DIR=/home/software/hadoop-2.7.4/etc/hadoop
export SPARK_MASTER_PORT=7077
export SPARK_EXECUTOR_CORES=2
export SPARK_EXECUTOR_MEMORY=1024m
export SPARK_EXECUTOR_INSTANCES=1
4、修改spark-2.1.1-bin-hadoop2.7/conf/slave文件,添加以下内容:
hadoop04
hadoop05
hadoop06
5、在hdfs上传spark的jar包,并修改/home/software/spark-2.1.1-bin-hadoop2.7/conf/spark-defaults.conf(可不做)
①hadoop fs -mkdir /spark_jars
②hadoop fs -put /home/software/spark-2.1.1-bin-hadoop2.7/jars/* /spark_jars
③修改/home/software/spark-2.1.1-bin-hadoop2.7/conf/spark-defaults.conf,添加以下内容:
spark.yarn.jars=hdfs://hadoop01:9000/spark_jars/*
6、完成以上操作就完成了spark基于yarn的安装。下面是验证部分:
在安装有spark的节点上执行以下命令:
spark-submit --class org.apache.spark.examples.SparkPi \
--master yarn \
--deploy-mode cluster \
--driver-memory 1g \
--executor-memory 1g \
--executor-cores 1 \
--num-executors 3 \
/home/software/spark-2.1.1-bin-hadoop2.7/examples/jars/spark-examples_2.11-2.1.1.jar \
10
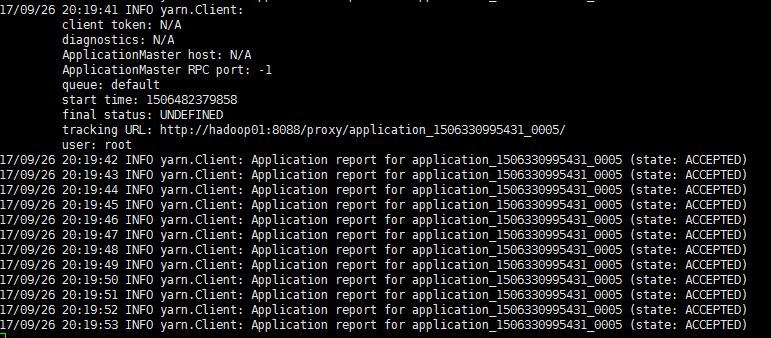
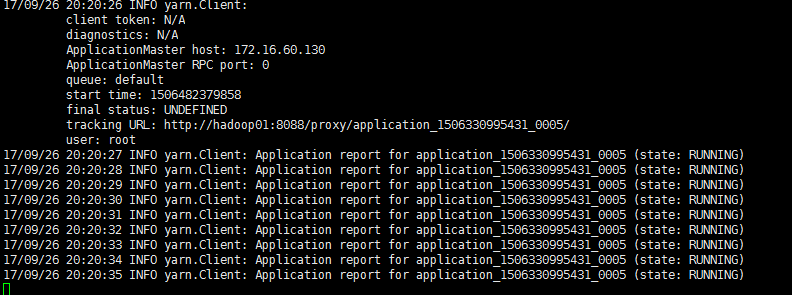
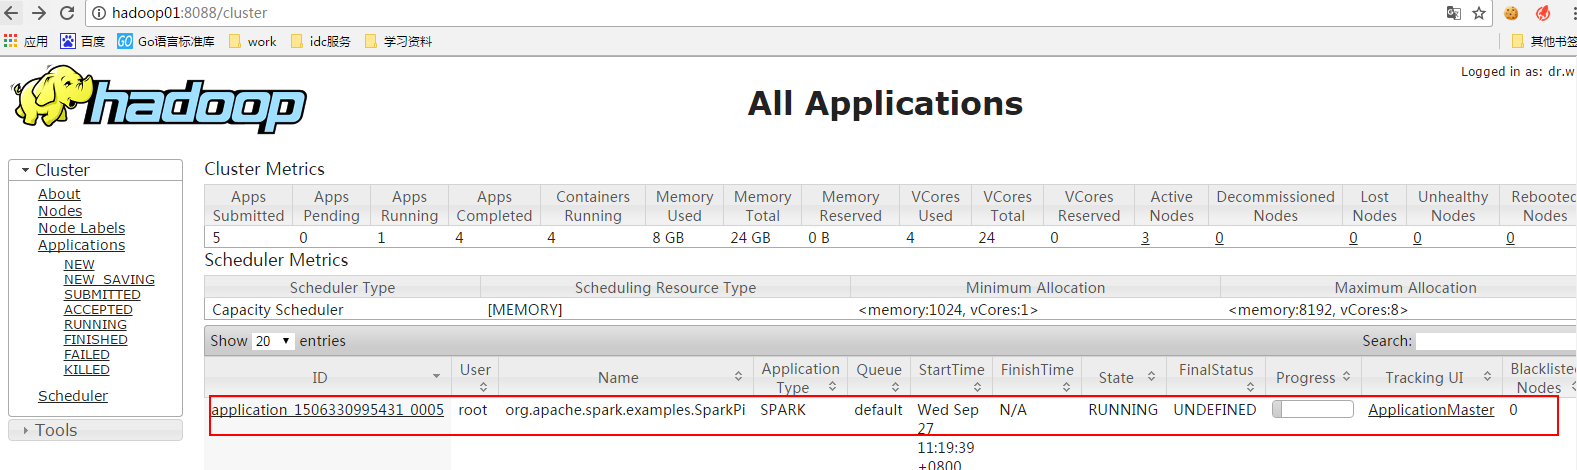
能看以上三张图就说明安装成功了!
备注:如果执行spark-shell --master yarn --deploy-mode client失败,报rpc连接失败,解决方法如下:
在hadoop的配置文件yarn-site.xml中加入:
<property>
<name>yarn.nodemanager.pmem-check-enabled</name>
<value>false</value>
</property>
<property>
<name>yarn.nodemanager.vmem-check-enabled</name>
<value>false</value>
</property>
报错的原因是:内存资源给的过小,yarn直接kill掉进程,则报rpc连接失败、ClosedChannelException等错误。
spark-2.1.1 yarn(高可用)搭建的更多相关文章
- hadoop2.6.0高可靠及yarn 高可靠搭建
以前用hadoop2.2.0只搭建了hadoop的高可用,但在hadoop2.2.0中始终没有完成YARN HA的搭建,直接下载了hadoop最新稳定版本2.6.0完成了YARN HA及HADOOP ...
- hadoop 集群HA高可用搭建以及问题解决方案
hadoop 集群HA高可用搭建 目录大纲 1. hadoop HA原理 2. hadoop HA特点 3. Zookeeper 配置 4. 安装Hadoop集群 5. Hadoop HA配置 搭建环 ...
- hadoop+zookeeper集群高可用搭建
hadoop+zookeeper集群高可用搭建 Senerity 发布于 2 ...
- 七、Hadoop3.3.1 HA 高可用集群QJM (基于Zookeeper,NameNode高可用+Yarn高可用)
目录 前文 Hadoop3.3.1 HA 高可用集群的搭建 QJM 的 NameNode HA Hadoop HA模式搭建(高可用) 1.集群规划 2.Zookeeper集群搭建: 3.修改Hadoo ...
- 10-Flink集群的高可用(搭建篇补充)
戳更多文章: 1-Flink入门 2-本地环境搭建&构建第一个Flink应用 3-DataSet API 4-DataSteam API 5-集群部署 6-分布式缓存 7-重启策略 8-Fli ...
- Hadoop入门学习笔记-第三天(Yarn高可用集群配置及计算案例)
什么是mapreduce 首先让我们来重温一下 hadoop 的四大组件:HDFS:分布式存储系统MapReduce:分布式计算系统YARN: hadoop 的资源调度系统Common: 以上三大组件 ...
- Qingcloud_MySQL Plus(Xenon) 高可用搭建实验
实验:Xenon on 5.7.30 Xenon (MySQL Plus) 是青云Qingcloud的一个开源项目,号称金融级别强一致性的高可用解决方案,项目地址为 https://github.co ...
- Spring Cloud(Dalston.SR5)--Eureka 注册中心高可用搭建
高可用集群 在微服务架构这样的分布式环境中,我们需要充分考虑发生故障的情况,所以在生产环境中必须对各个组件进行高可用部署,对与微服务和服务注册中心都需要高可用部署,Eureka 高可用实际上就是将自己 ...
- kudu集群高可用搭建
首先咱得有KUDU安装包 这里就不提供直接下载地址了(因为有5G,我 的服务器网卡只有4M,你们下的很慢) 这里使用的是CDH版本 官方下载地址http://archive.cloudera.com/ ...
随机推荐
- HTTP学习记录:二、请求方法
学习资源主要为:@小坦克HTTP相关博客 最基础的是4种,GET.POST.PUT.DELETE对应着对资源的查.改.增.删.最常用的是GET和POST. GET一般用于获取/查询资源信息: POST ...
- Jmeter 后置处理器--jp@gc - JSON/YAML Path Extractor & JSON Extractor
后置处理器--jp@gc - JSON/YAML Path Extractor 1.需要下载插件,地址: 解压后把对应jar包放置对应的lib和lib/ext目录下,重启Jmeter: 2.在需要提取 ...
- mysql5.6修改密码并授权所有远程用户可登陆
1.my.ini文件,删除最后一行的"skip-grant-tables 2.执行"use mysql;",使用mysql数据库; 3.执行:update mysql.u ...
- 记:第一次更新服务器CUDA和GPU驱动
因有需求需要改动centos7中的CUDA(更新到10)和GUP 的driver(更新到410)的版本. 事先需要查看原版本的信息,使用nvidia-smi可以查看driver的版本信息(最新的也显示 ...
- 粉丝福利:收藏已久的Java架构资料免费送(仅限3天)
有段时间没跟各位粉丝分享编程资源福利了,看了下自己的百度网盘,就剩下这个我认为是比较好的Java架构师学习资料了,相信这套资料可以对你进阶高级工程师有帮助. Java架构师技术进阶路线图 架构技术进阶 ...
- HNUSTOJ-1253 Babelfish(字典树)
1253: Problem C: Babelfish 时间限制: 1 Sec 内存限制: 128 MB提交: 14 解决: 3[提交][状态][讨论版] 题目描述 Problem C: Babel ...
- 剑指offer-删除链表中重复的结点-链表-python ***
题目描述 在一个排序的链表中,存在重复的结点,请删除该链表中重复的结点,重复的结点不保留,返回链表头指针. 例如,链表1->2->3->3->4->4->5 处理后 ...
- Filter&Listener笔记
## 今日内容 1. Filter:过滤器 2. Listener:监听器 # Filter:过滤器 1. 概念: * 生活中的过滤器:净水器,空气净化器,土匪 ...
- 伟大的GIL
GIL 首先需要明确的一点是GIL并不是Python的特性,它是在实现Python解析器(CPython)时所引入的一个概念.就好比C++是一套语言(语法)标准,但是可以用不同的编译器来编译成可执行代 ...
- rest_framework框架的版本
REST_FRAMEWORK = { 'DEFAULT_RENDERER_CLASSES':['rest_framework.renderers.JSONRenderer','rest_framewo ...