
使用selenium+BeautifulSoup 抓取京东商城手机信息
1.准备工作:
- chromedriver 传送门:国内:http://npm.taobao.org/mirrors/chromedriver/ vpn:
- selenium
- BeautifulSoup4(美味汤)
pip3 install selenium
pip3 install BeautifulSoup4
chromedriver 的安装请自行百度。我们直奔主题。
起飞前请确保准备工作以就绪...
2.分析网页:
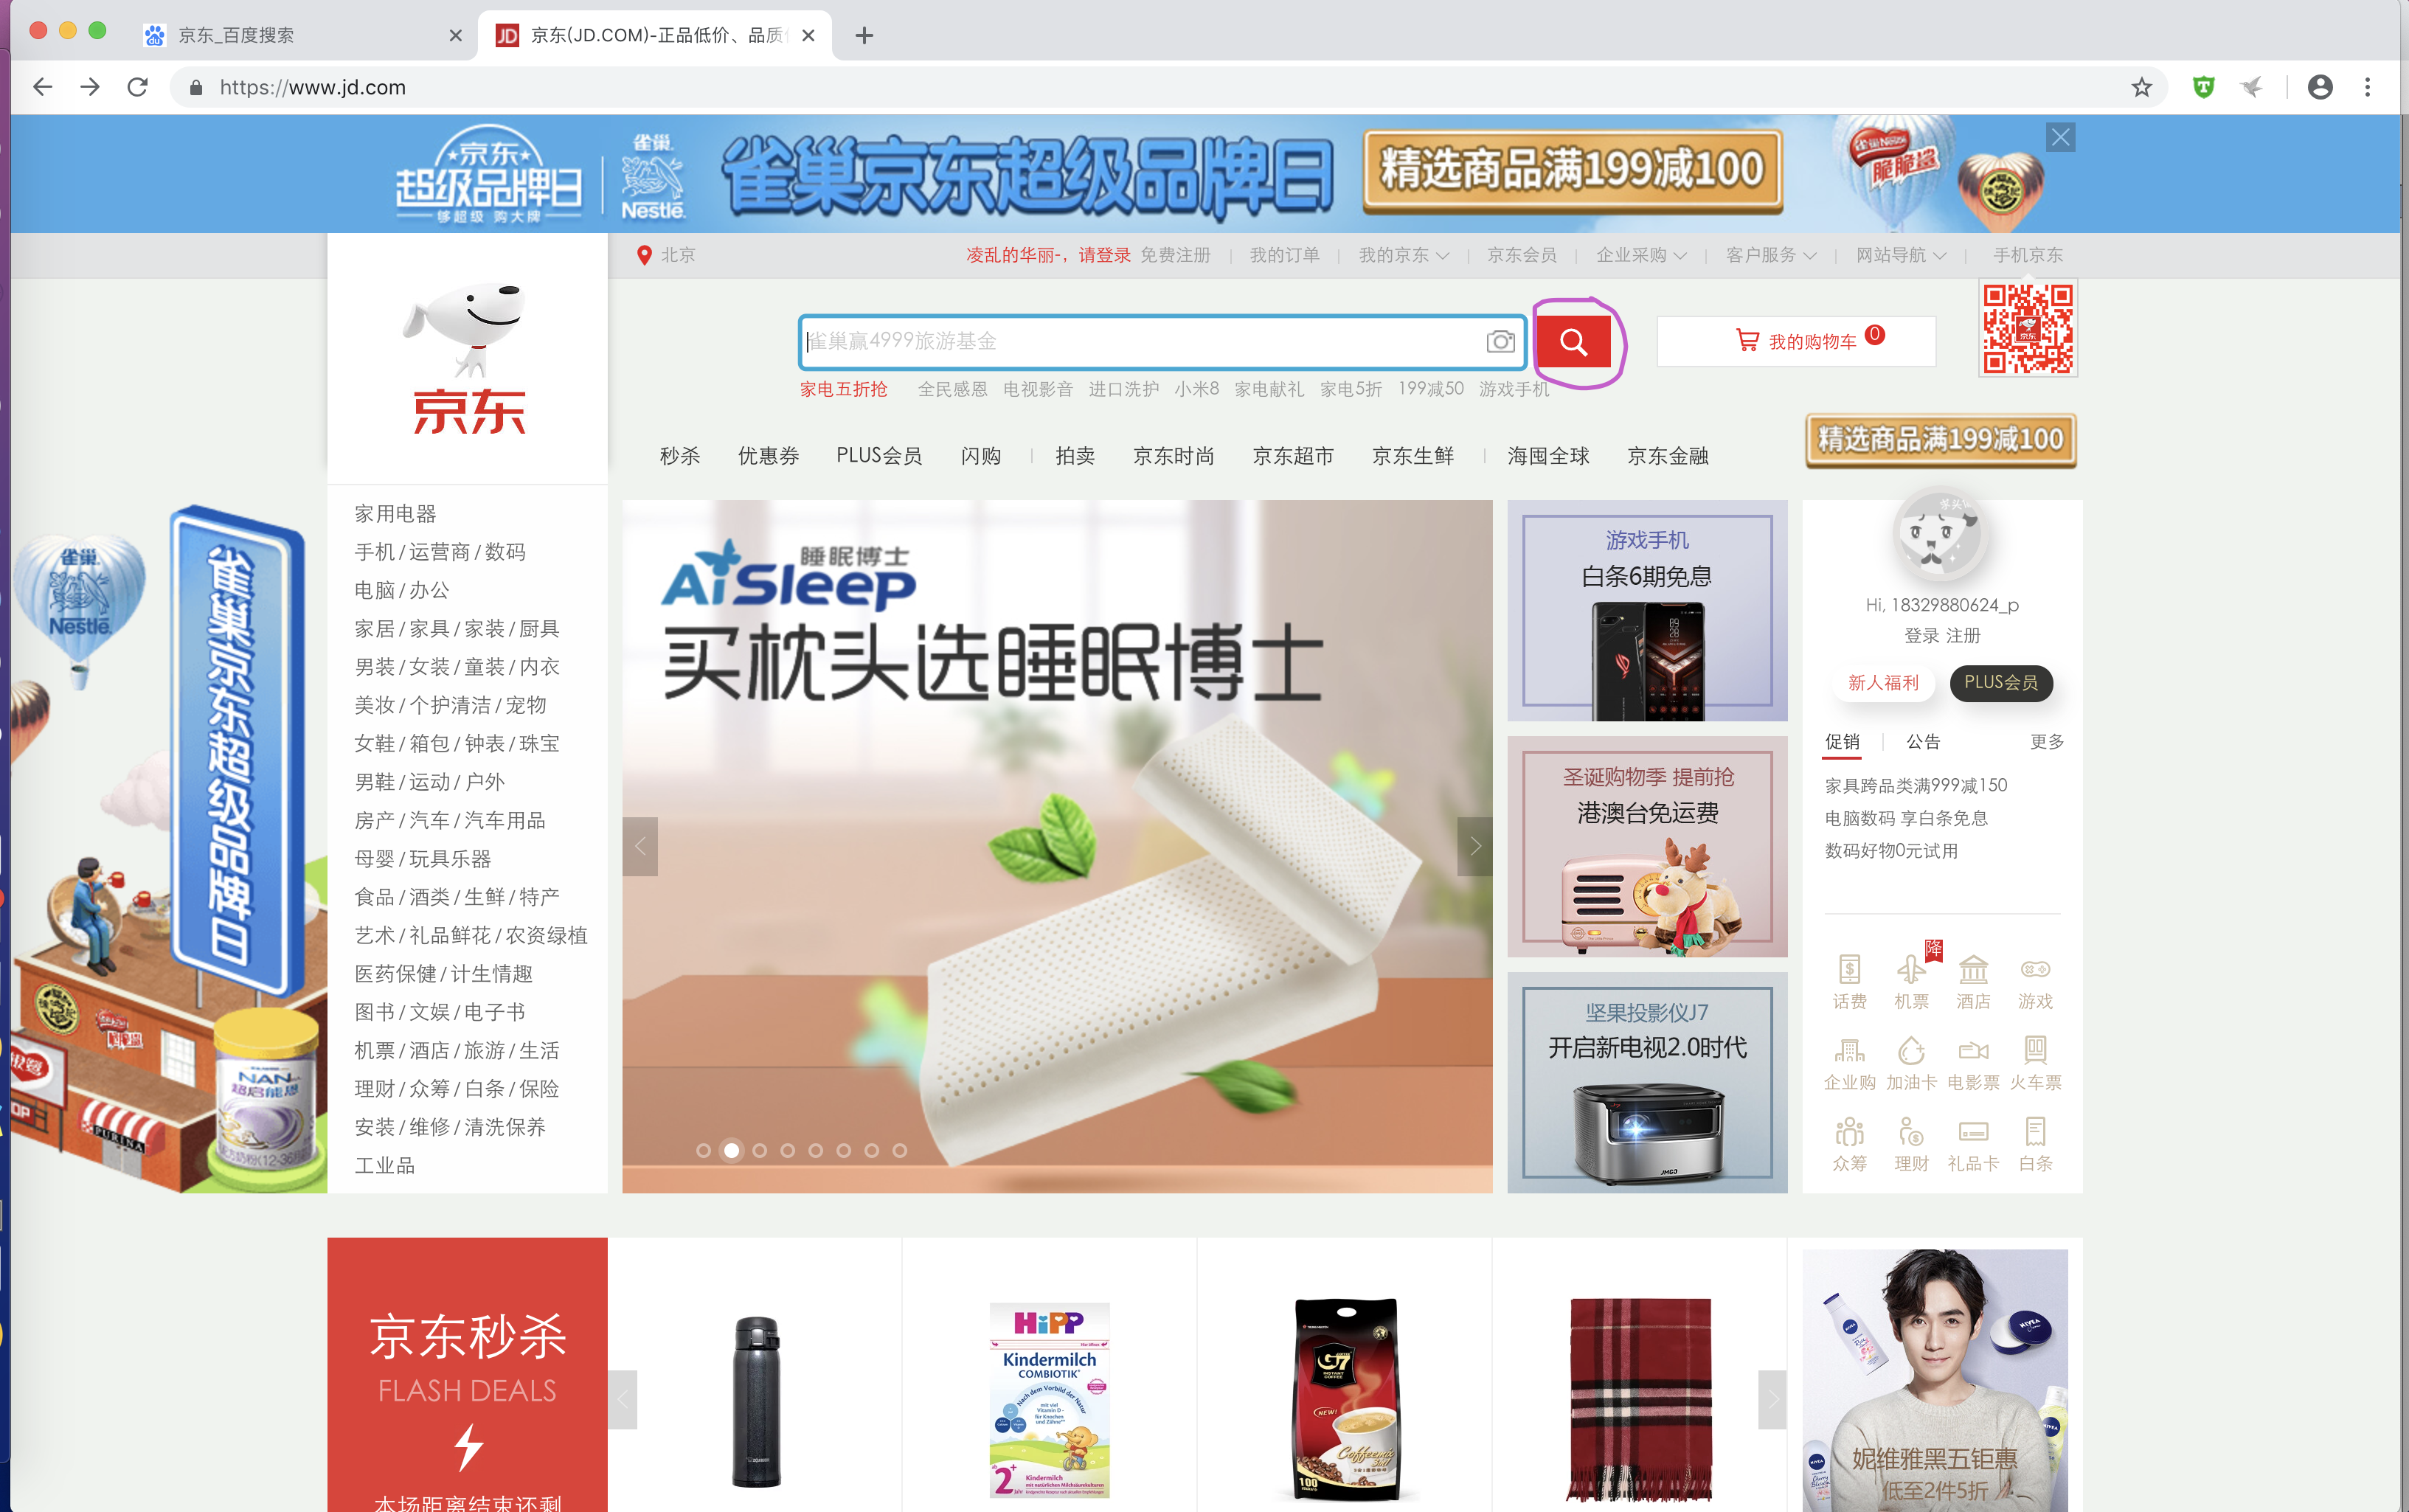
目标网址:https://www.jd.com/


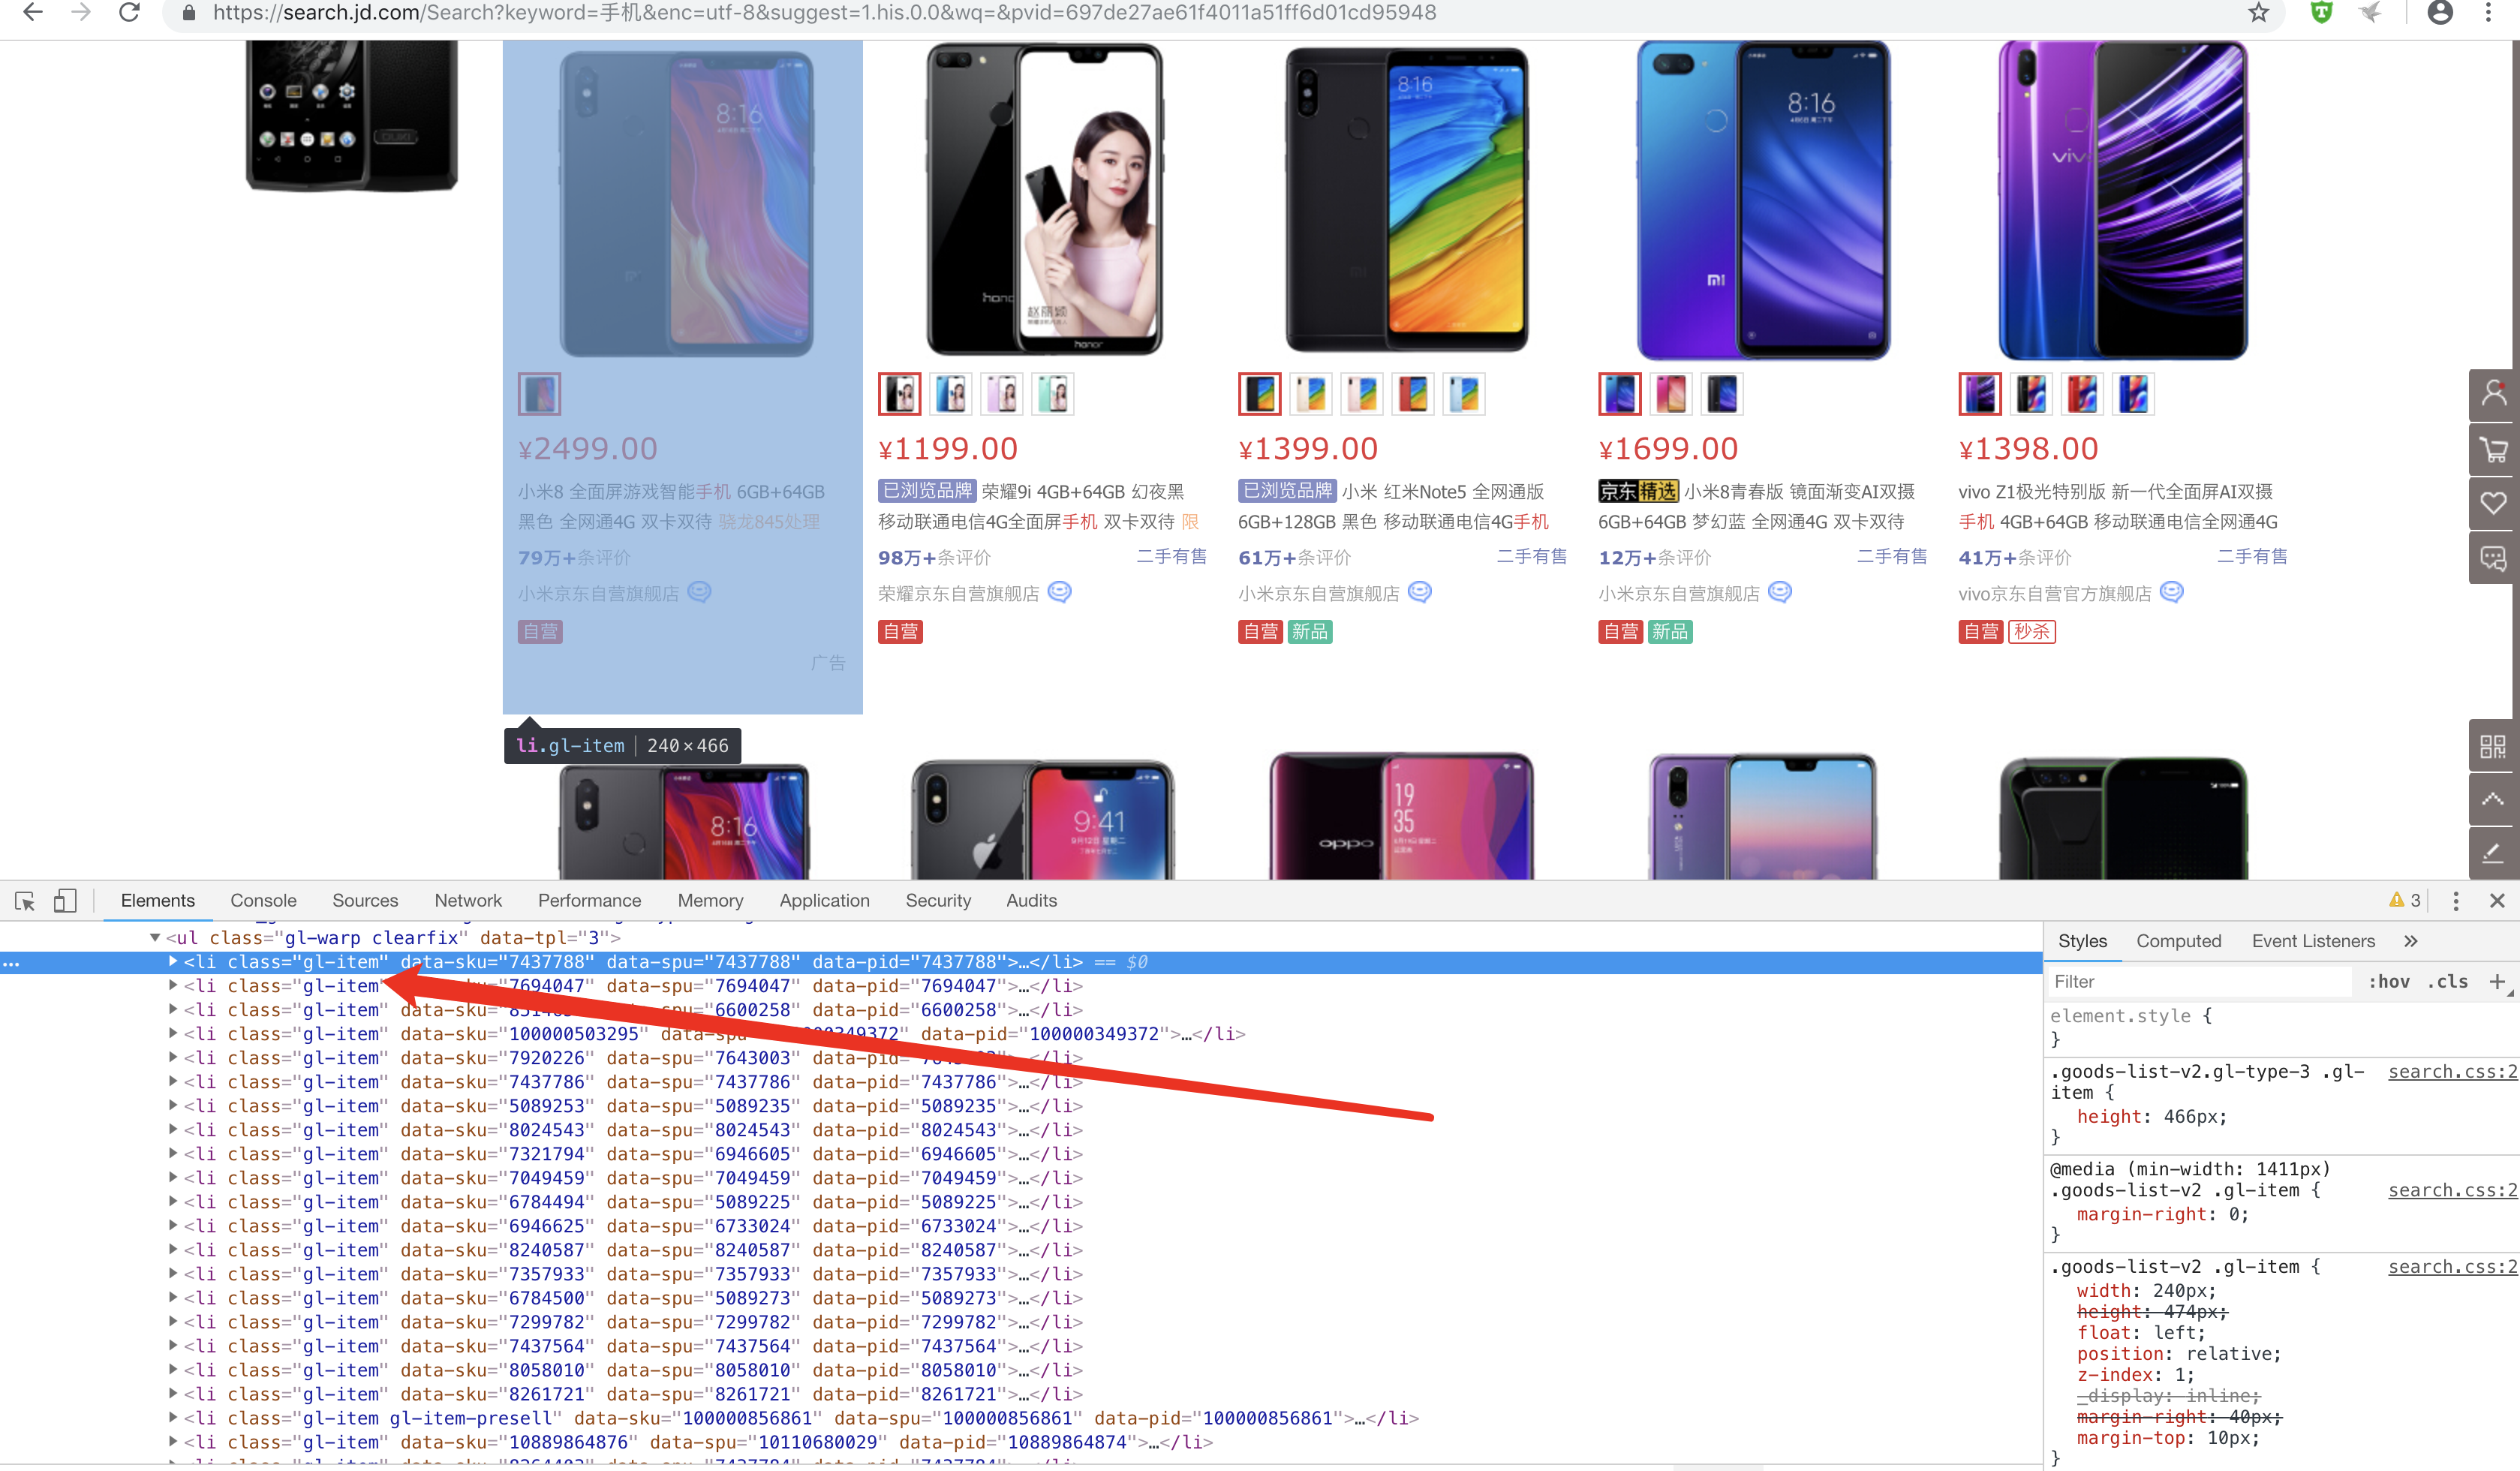
所有item均保存在class="gl-item"里面
需求:
- 使用selenium 驱动浏览器自动侦测到input输入框,输入框中输入“手机”,点击搜索按钮.
- 使用seleinum抓取发挥页面的总页码,并模拟手动翻页
- 使用BeautifulSoup分析页面,抓取手机信息
从入口首页进入查询状态
 # 定义入口查询界面

 def search():

     browser.get('https://www.jd.com/')

     try:

         # 查找搜索框及搜索按钮,输入信息并点击按钮

         input = wait.until(EC.presence_of_all_elements_located((By.CSS_SELECTOR, "#key")))

         submit = wait.until(EC.element_to_be_clickable((By.CSS_SELECTOR, "#search > div > div.form > button")))

         input[0].send_keys('手机')

         submit.click()

         # 获取总页数

         page = wait.until(EC.presence_of_all_elements_located((By.CSS_SELECTOR, '#J_bottomPage > span.p-skip > em:nth-child(1) > b')))

         return page[0].text

     # 如果异常,递归调用本函数

     except TimeoutException:

         search()
查询结束后模拟翻页
 # 翻页

 def next_page(page_number):

     try:

         # 滑动到网页底部,加载出所有商品信息

         browser.execute_script("window.scrollTo(0, document.body.scrollHeight);")

         time.sleep(4)

         html = browser.page_source

         # 当网页到达100页时,下一页按钮失效,所以选择结束程序

         while page_number == 101:

             exit()

         # 查找下一页按钮,并点击按钮

         button = wait.until(EC.element_to_be_clickable((By.CSS_SELECTOR, '#J_bottomPage > span.p-num > a.pn-next > em')))

         button.click()

         # 判断是否加载到本页最后一款产品Item(每页显示60条商品信息)

         wait.until(EC.presence_of_all_elements_located((By.CSS_SELECTOR, "#J_goodsList > ul > li:nth-child(60)")))

         # 判断翻页成功

         wait.until(EC.text_to_be_present_in_element((By.CSS_SELECTOR, "#J_bottomPage > span.p-num > a.curr"), str(page_number)))

         return html

     except TimeoutException:

         return next_page(page_number)
解析页面上的a标签
# 解析每一页面上的a链接

def parse_html(html):

    """

    解析商品列表网页,获取商品的详情页

    """

    soup = BeautifulSoup(html, 'html.parser')

    items = soup.select('.gl-item')

    for item in items:

        a = item.select('.p-name.p-name-type-2 a')

        link = str(a[0].attrs['href'])

        if 'https:' in link:

            continue

        else:

            link = "https:"+link

        yield link
根据url 截取商品id 获取价格信息
# 获取手机价格,由于价格信息是请求另外一个地址https://p.3.cn/prices/mgets?skuIds=J_+product_id

def get_price(product_id):

    url = 'https://p.3.cn/prices/mgets?skuIds=J_' + product_id

    response = requests.get(url,heeders)

    result = ujson.loads(response.text)

    return result
进入item商品详情页
# 进入详情页

def detail_page(link):

    """

    进入item详情页

    :param link: item link

    :return: html

    """

    browser.get(link)

    try:

        browser.execute_script("window.scrollTo(0, document.body.scrollHeight);")

        time.sleep(3)

        html = browser.page_source

        return html

    except TimeoutException:

        detail_page(link)
 # 获取详情页的手机信息

 def get_detail(html,result):

     """

     获取详情页的数据

     :param html:

     :return:

     """

     dic ={}

     soup = BeautifulSoup(html, 'html.parser')

     item_list = soup.find_all('div', class_='Ptable-item')

     for item in item_list:

         contents1 = item.findAll('dt')

         contents2 = item.findAll('dd')

         for i in range(len(contents1)):

             dic[contents1[i].string] = contents2[i].string

     dic['price_jd '] = result[0]['p']

     dic['price_mk '] = result[0]['m']

     print(dic)
滴滴滴.. 基本上的思路就酱紫咯.. 传送门依旧打开直github: https://github.com/shinefairy/spider/
end~
使用selenium+BeautifulSoup 抓取京东商城手机信息的更多相关文章
- asp.net mvc 抓取京东商城分类
555 asp.net mvc 抓取京东商城分类 URL:http://www.jd.com/allSort.aspx 效果: //后台代码 public ActionResult Get ...
- 如何利用BeautifulSoup选择器抓取京东网商品信息
昨天小编利用Python正则表达式爬取了京东网商品信息,看过代码的小伙伴们基本上都坐不住了,辣么多的规则和辣么长的代码,悲伤辣么大,实在是受不鸟了.不过小伙伴们不用担心,今天小编利用美丽的汤来为大家演 ...
- 如何利用Xpath抓取京东网商品信息
前几小编分别利用Python正则表达式和BeautifulSoup爬取了京东网商品信息,今天小编利用Xpath来为大家演示一下如何实现京东商品信息的精准匹配~~ HTML文件其实就是由一组尖括号构成的 ...
- 如何利用CSS选择器抓取京东网商品信息
前几天小编分别利用Python正则表达式.BeautifulSoup.Xpath分别爬取了京东网商品信息,今天小编利用CSS选择器来为大家展示一下如何实现京东商品信息的精准匹配~~ CSS选择器 目前 ...
- Scrapy实战篇(四)爬取京东商城文胸信息
创建scrapy项目 scrapy startproject jingdong 填充 item.py文件 在这里定义想要存储的字段信息 import scrapy class JingdongItem ...
- Scrapy实战篇(五)爬取京东商城文胸信息
创建scrapy项目 scrapy startproject jingdong 填充 item.py文件 在这里定义想要存储的字段信息 import scrapy class JingdongItem ...
- php+phpquery简易爬虫抓取京东商品分类
这是一个简单的php加phpquery实现抓取京东商品分类页内容的简易爬虫.phpquery可以非常简单地帮助你抽取想要的html内容,phpquery和jquery非常类似,可以说是几乎一样:如果你 ...
- Scrapy实战篇(八)之Scrapy对接selenium爬取京东商城商品数据
本篇目标:我们以爬取京东商城商品数据为例,展示Scrapy框架对接selenium爬取京东商城商品数据. 背景: 京东商城页面为js动态加载页面,直接使用request请求,无法得到我们想要的商品数据 ...
- Python脚本抓取京东手机的配置信息
以下代码是使用python抓取京东小米8手机的配置信息 首先找到小米8商品的链接:https://item.jd.com/7437788.html 然后找到其配置信息的标签,我们找到其配置信息的标签为 ...
随机推荐
- 找不到/lib/modules/../build文件夹
:解决了make: *** /lib/modules/3.2.0-4-amd64/build: 没有那个文件或目录的问题,更新一下软件列表,然后sudo apt-get install linux-h ...
- input复制文本
input.value = this.$t('title') document.body.appendChild(input) input.select() input.setSelectionRan ...
- android handler 调用原理
1,调度原理 andriod提供了Handler 和 Looper 来满足线程间的通信.Handler先进先出原则.Looper类用来管理特定线程内对象之间的消息交换(MessageExchange) ...
- [BZOJ3932][CQOI2015]任务查询系统(差分+主席树)
题面 分析 对于一个区间修改(s,e,v),我们可以将它差分,这样就变成了单点修改s和e+1(s插入,t+1删除) 我们用主席树维护差分数组的前缀和,第i棵主席树维护区间[1,i]之间的所有差分值 那 ...
- luoguP1003 铺地毯 题解(NOIP2011)
luoguP1003 铺地毯 题目 #include<cstdio> #include<cstdlib> #include<cstring> #include&l ...
- opencv2——图像上的算术运算4
1.图像算术运算 参数含义: src1:第一张图像 src2:第二张图像 dst:destination,目标图像,需要提前分配空间,可省略 mask:掩膜 scale:缩放比,常量 dtype:数据 ...
- 【Linux】php7.2.8 + xdebug + composer + php代码覆盖率 + jenkins配置 (实操记录,亲测可用)
[一.linux安装php 7.2.8] 1.wget http://nginx.org/download/nginx-1.9.9.tar.gz # nginx可不安 ...
- 自己做的html5手机站点
这个站点採用html5+css3+jquerymobile 仅仅开发了前台的功能,前台的界面比較美观,后端不方便放上,各位有空能够自己开发这个站点的界面有參考各个菜谱站点的页面的样式,可是又不一样,是 ...
- 最小生成树,Prim算法实现
最小生成树 所谓最小生成树,就是一个图的极小连通子图,它包含原图的所有顶点,并且所有边的权值之和尽可能的小. 首先看看第一个例子,有下面这样一个带权图: 它的最小生成树是什么样子呢?下图绿色加粗的边可 ...
- Leetcode Lect2 Java 中的 Interface
什么是 Interface Java接口(Interface)是一系列方法的声明,是一些方法特征的集合,一个接口只有方法的特征没有方法的实现,因此这些方法可以在不同的地方被不同的类实现,而这些实现可以 ...