
zookeeper高可用集群搭建
前提:已经在master01配置好hadoop;在各个slave节点配置好hadoop和zookeeper;
(该文是将zookeeper配置在各slave节点上的,其实也可以配置在各master上,在哪配置就在哪启动zookeeper集群)
此文章基于上一篇文章:linux安装配置zookeeper-3.4.10
首先新增虚拟机master02;
一、虚拟机中操作(启动网卡)
sh /install/initNetwork.sh
ifup eth0
二、基础配置(主机名、IP配置、防火墙及selinux强制访问控制安全系统)
vi /etc/sysconfig/network (配置磁盘中主机名字)
vi /etc/hosts (配置映射,)
hostname 主机名 (修改内存中主机名)
然后,重新链接查看是否成功;
vi /etc/sysconfig/network-scripts/ifcfg-eth0
查看内容是否设置成功:cat /etc/sysconfig/network-scripts/ifcfg-eth0
DEVICE=eth0 (设置需要重启的设备的名字)

TYPE=Ethernet(以太网)

ONBOOT=yes (设置为yes)

NM_CONTROLLED=yes

BOOTPROTO=static (设置为静态)

IPADDR=192.168.238.130 (本机IP地址)

NETMASK=255.255.255.0 (子网掩码)

GATEWAY=192.168.238.2 (网关)(查询本机网关:route -n)

DNS1=192.168.238.2

DNS2=8.8.8.8    (谷歌IP地址)
vi /etc/sysconfig/selinux
修改:SELINUX=disabled
去掉注释查看selinux内容:
grep -Ev '^#|^$' /etc/sysconfig/selinux
永久关闭防火墙:
service iptables stop
chkconfig iptables off
三、时间同步
for node in master01 master02 slave01 slave02 slave03;do ssh $node "date -s '2017-12-20 21:32:30'";done
四、配置ssh免密登录(为hadoop用户配置免密码登录)
需要两个master免密登录自己和其它各个节点,无需反向
[hadoop@master01 ~]# ssh-keygen -t rsa 创建公匙
[hadoop@master01 ~]# ssh-copy-id master02 拷贝公匙
提升权限: 大数据学习交流群:217770236 让我我们一起学习大数据
chmod 777 /install /software
五、安装hadoop
所有安装了hadoop的节点执行下面的语句:
[hadoop@master01 ~]# rm -rf /software/hadoop-2.7.3/logs/* /software/hadoop-2.7.3/work/
然后[hadoop@master01 ~]# scp -r /software/hadoop-2.7.3/ master02:/software/
然后配置环境变量:
[root@master02 ~]$ vi /etc/profile
JAVA_HOME=/software/jdk1.7.0_79

HADOOP_HOME=/software/hadoop-2.7.3

PATH=$PATH:$JAVA_HOME/bin:$JAVA_HOME/lib:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

export PATH JAVA_HOME HADOOP_HOME
在master01下:
进入文件夹下:cd /software/hadoop-2.7.3/etc/hadoop/
1、修改core-site.xml配置文件
 <configuration>

 <property>

     <name>fs.defaultFS</name>

         <!--默认的nameservice节点名字-->

     <value>hdfs://ns1</value>

     </property>

     <!-- 配置ZK集群,多个ZK集群节点中间用英文逗号隔开, -->

 <property>

       <name>ha.zookeeper.quorum</name>

             <value>slave01:2181,slave02:2181,slave03:2181</value>

             </property>

   <property>

       <name>hadoop.tmp.dir</name>

       <value>/software/hadoop-2.7.3/work</value>

   </property>

 </configuration>
core-site.xml
2、修改hdfs-site.xml 配置文件:
 <configuration>

 <property>

        <name>dfs.replication</name>

        <value>3</value>

 </property>

 <!-- 注意:此配置文件的配置必须与core-site.xml配置相吻合 -->

 <property>

        <name>dfs.nameservices</name>

        <value>ns1</value>

 </property>

 <property>

        <name>dfs.ha.namenodes.ns1</name>

     <!-- 定义高可用nameservice节点集群ns1下的主从节点(就是高可用的那两个NN节点)-->

        <value>nn1,nn2</value>

 </property>

 <!--分别定义主从NN节点的RPC和HTTP通信,NN指代的是master,需修改-->

 <property>

     <name>dfs.namenode.rpc-address.ns1.nn1</name>

     <value>master01:9000</value>

 </property>

 <property>

     <name>dfs.namenode.http-address.ns1.nn1</name>

     <value>master01:50070</value>

 </property>

 <property>

     <name>dfs.namenode.rpc-address.ns1.nn2</name>

     <value>master02:9000</value>

 </property>

 <property>

     <name>dfs.namenode.http-address.ns1.nn2</name>

     <value>master02:50070</value>

 </property>

 <!-- 配置存放元数据的qjournal集群 -->

 <property>

     <name>dfs.namenode.shared.edits.dir</name>

     <!-- 存放在QJID标识的文件夹中 -->

     <value>qjournal://slave01:8485;slave02:8485;slave03:8485/QJID</value>

 </property>

 <!-- 配置qjournal集群节点在本地存放数据的位置 -->

 <property>

     <name>dfs.journalnode.edits.dir</name>

     <value>/software/hadoop-2.7.3/QJMetaData</value>

 </property>

 <!-- 开启NN节点宕机后自动切换 -->

 <property>

     <name>dfs.ha.automatic-failover.enabled</name>

     <value>true</value>

 </property>

 <!-- 配置故障转移代理类 -->

 <property>

     <name>dfs.client.failover.proxy.provider.ns1</name>

     <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>

 </property>

 <!-- 确认是否主master是否真的宕机了,ensure.sh脚本需要自己编写 -->

 <property>

     <name>dfs.ha.fencing.methods</name>

     <value>

         sshfence

         shell(/software/hadoop-2.7.3/ensure.sh)

     </value>

 </property>

 <!-- 配置公式密钥 -->

 <property>

     <name>dfs.ha.fencing.ssh.private-key-files</name>

     <value>/home/hadoop/.ssh/id_rsa</value>

 </property>

 <!-- 配置超时 -->

 <property>

     <name>dfs.ha.fencing.ssh.connect-timeout</name>

     <value>30000</value>

 </property>

 </configuration>
hdfs-site.xml的configuration
拷贝这两个配置到其它所有节点:
scp -r /software/hadoop-2.7.3/etc/hadoop/core-site.xml /software/hadoop-2.7.3/etc/hadoop/hdfs-site.xml master02:/software/hadoop-2.7.3/etc/hadoop/
3、Yarn之ResourceManager高可用集群配置:
修改yarn-site.xml配置文件:
 <configuration>

 <!-- Site specific YARN configuration properties -->

 <!--

   <property>

       <name>yarn.resourcemanager.hostname</name>

       <value>master01</value>

   </property>

 -->

 <property>

       <name>yarn.resourcemanager.ha.enabled</name>

       <value>true</value>

 </property>

 <property>

       <name>yarn.resourcemanager.cluster-id</name>

       <value>RMHA</value>

 </property>

 <property>

       <name>yarn.resourcemanager.ha.rm-ids</name>

       <value>rm1,rm2</value>

 </property>

 <property>

       <name>yarn.resourcemanager.hostname.rm1</name>

       <value>master01</value>

 </property>

 <property>

       <name>yarn.resourcemanager.hostname.rm2</name>

       <value>master02</value>

 </property>

 <property>

       <name>yarn.resourcemanager.zk-address</name>

       <value>slave01:2181,slave02:2181,slave03:2181</value>

 </property>

 <property>

       <name>yarn.nodemanager.aux-services</name>

       <value>mapreduce_shuffle</value>

 </property>

 </configuration>
yarn-site.xml的configuration
拷贝这一个配置到其它所有节点:
scp -r /software/hadoop-2.7.3/etc/hadoop/yarn-site.xml master02:/software/hadoop-2.7.3/etc/hadoop/
大数据学习交流QQ群:217770236 让我们一起学习大数据
六、查看zookeeper高可用集群是否搭建成功:
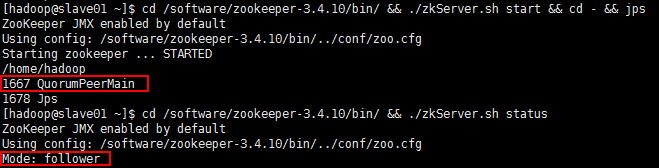
1、在slave节点启动zookeeper集群(小弟中选个leader和follower)
cd /software/zookeeper-3.4.10/bin/ && ./zkServer.sh start && cd - && jps
2、在slaver节点上启动Qjournal集群(控制存放元数据的)
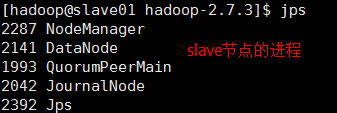
此步骤可以省略,因为在master上启动dfs集群时会自动拉起zk集群的Qjournal进程;
cd /software/hadoop-2.7.3/ && hadoop-daemon.sh start journalnode && jps

3、在master01上执行:
【格式化HDFS(只有第一次测试才执行)】cd /software/ && hdfs namenode -format
【拷贝work到master02对应节点下(只有第一次测试才执行)】scp -r /software/hadoop-2.7.3/work/ master02:/software/hadoop-2.7.3/
【格式化ZKFC客户端(只有第一次测试才执行)】cd /software/hadoop-2.7.3/ && hdfs zkfc -formatZK
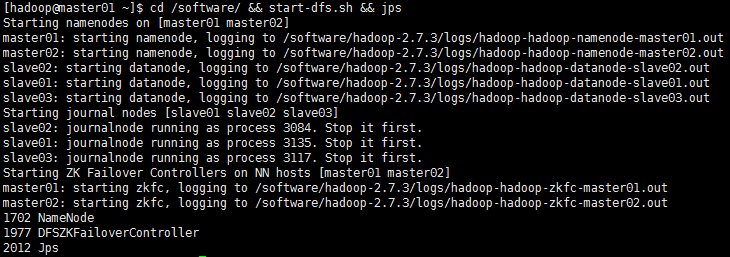
【启动HDFS集群】cd /software/ && start-dfs.sh && jps
【启动YARN集群】cd /software/ && start-yarn.sh && jps
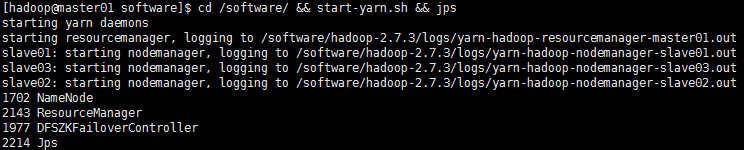
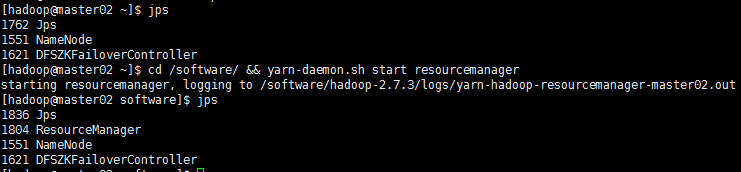
【YARN集群启动时,不会把另外一个备用主节点的YARN集群拉起来启动,所以在master02执行语句:】
cd /software/ && yarn-daemon.sh start resourcemanager && jps
【查看两个master谁是主节点:】
[hadoop@master01 software]$ hdfs haadmin -getServiceState nn1
active (主节点)
[hadoop@master01 software]$ hdfs haadmin -getServiceState nn2
standby (备用主节点)
【查看两个resourcemanager谁是主:】
[hadoop@master01 hadoop]$ yarn rmadmin -getServiceState rm1
active(主)
[hadoop@master01 hadoop]$ yarn rmadmin -getServiceState rm2
standby(备用)
【DFSZKFailoverController是Hadoop-2.7.0中HDFS NameNode HA实现的中心组件,它负责整体的故障转移控制等。它是一个守护进程,通过main()方法启动,继承自ZKFailoverController】

七、使用hdfs命令操作集群文件
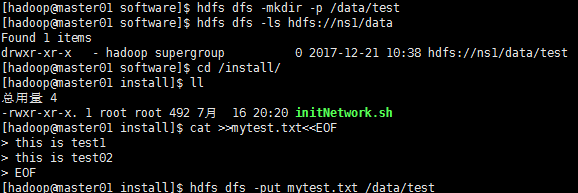
【在master01新建测试文件mytest.txt,并上传到hdfs集群目录;且现在集群的前缀是hdfs://nsa/这是在hdfs-site.xml中配置的】
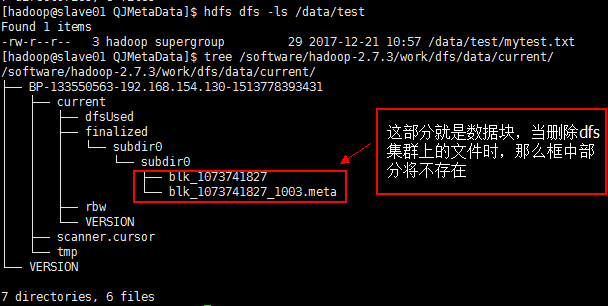
【在ZK集群slave节点中,可以看到】
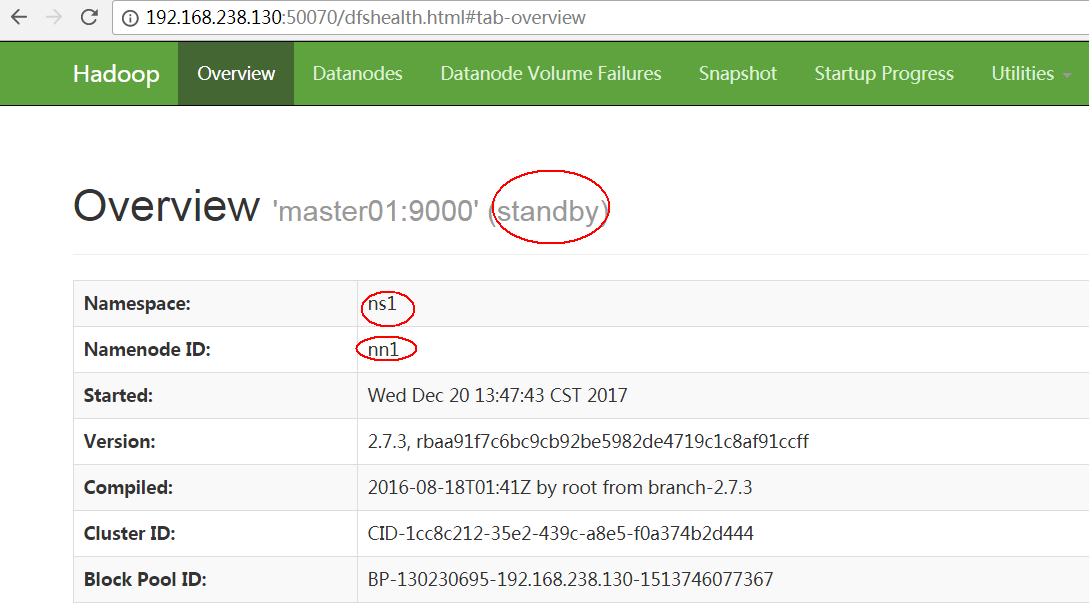
【浏览器查看该节点的状态(端口号是在hdfs-site.xml文件中配置的)】
http://master的IP地址:50070 http://master的IP地址:8088
【如果出问题了,那么执行下面的语句:】
cd /software/hadoop-2.7.3/ && rm -rf QJMetaData/ work/ logs/* && cd /software
八、关闭启动的集群:
【关闭YARN集群】cd /software/ && stop-yarn.sh
【YARN集群关闭时,同样不会把另外一个备用主节点的YARN集群拉起来关闭,所以在master02执行语句:】
cd /software/ && yarn-daemon.sh stop resourcemanager
【关闭HDFS集群】cd /software/ && stop-dfs.sh
【关闭slave节点的QuorumPeerMain进程】cd /software/zookeeper-3.4.10/bin/ && ./zkServer.sh stop && jps
强制转换结点的状态:
<!-- 开启NN节点宕机后自动切换 -->

<property>

  <name>dfs.ha.automatic-failover.enabled</name>

   <!-- 现将true改成false -->

  <value>true</value>

</property>
<!-- 强制修改节点的状态,此操作不可逆,一般不做该操作 -->
hdfs haadmin -transitionToActive --forceactive nn1
hdfs haadmin -transitionToStandby nn1
zookeeper高可用集群搭建的更多相关文章
- zookeeper 高可用集群搭建
前言 记录Zookeeper集群搭建的过程! 什么是 Zookeeper ? ZooKeeper是一个分布式的,开放源码的分布式应用程序协调服务,是Google的Chubby一个开源的实现,是Hado ...
- hadoop+yarn+hbase+storm+kafka+spark+zookeeper)高可用集群详细配置
配置 hadoop+yarn+hbase+storm+kafka+spark+zookeeper 高可用集群,同时安装相关组建:JDK,MySQL,Hive,Flume 文章目录 环境介绍 节点介绍 ...
- Hadoop HA高可用集群搭建(Hadoop+Zookeeper+HBase)
声明:作者原创,转载注明出处. 作者:帅气陈吃苹果 一.服务器环境 主机名 IP 用户名 密码 安装目录 master188 192.168.29.188 hadoop hadoop /home/ha ...
- zookeeper+activemq高可用集群搭建
一.准备工作: 准备三台机器:192.168.35.111192.168.35.112192.168.35.113 二.搭建zookeeper 三台机器上均要搭建zookeeper服务// 下载zoo ...
- hadoop高可用集群搭建小结
hadoop高可用集群搭建小结1.Zookeeper集群搭建2.格式化Zookeeper集群 (注:在Zookeeper集群建立hadoop-ha,amenode的元数据)3.开启Journalmno ...
- Spark高可用集群搭建
Spark高可用集群搭建 node1 node2 node3 1.node1修改spark-env.sh,注释掉hadoop(就不用开启Hadoop集群了),添加如下语句 export ...
- Hadoop 3.1.2(HA)+Zookeeper3.4.13+Hbase1.4.9(HA)+Hive2.3.4+Spark2.4.0(HA)高可用集群搭建
目录 目录 1.前言 1.1.什么是 Hadoop? 1.1.1.什么是 YARN? 1.2.什么是 Zookeeper? 1.3.什么是 Hbase? 1.4.什么是 Hive 1.5.什么是 Sp ...
- spring cloud 服务注册中心eureka高可用集群搭建
spring cloud 服务注册中心eureka高可用集群搭建 一,准备工作 eureka可以类比zookeeper,本文用三台机器搭建集群,也就是说要启动三个eureka注册中心 1 本文三台eu ...
- Hbase 完全分布式 高可用 集群搭建
1.准备 Hadoop 版本:2.7.7 ZooKeeper 版本:3.4.14 Hbase 版本:2.0.5 四台主机: s0, s1, s2, s3 搭建目标如下: HMaster:s0,s1(备 ...
随机推荐
- 2019浙大校赛--G--Postman(简单思维题)
一个思维水题 题目大意为,一个邮递员要投递N封信,一次从邮局来回只能投递K封.求最短的投递总距离.需注意,最后一次投递后无需返回邮局. 本题思路要点: 1.最后一次投递无需返回邮局,故最后一次投递所行 ...
- Python if __name__ == '__main__':
python属于脚本语言,只能逐行运行, if __name__ == '__main__':这句相当于main(),即首先执行这条语句.
- struts2 升级至2.3.32时访问页面报错 File "/struts-tags" not found
Apache struts是美国阿帕奇(Apache)软件基金会负责维护的一个开源项目,是一套用于创建企业级Java Web 应用的开源MVC框架,主要提供两个版本框架产品: struts 1和str ...
- C++输出格式
C++输出格式 C++中默认输出有效位数是6位,即 则输出: 221.111.11011199967 //6位有效数字,自动截取保存六位1.99967e+006 //六位以上且无法省略显示将会变为指数 ...
- node平台的安装与搭建
1.node.js 官网:https://nodejs.org/ (.org:是非盈利机构,他们的软件是不收费的,但是服务收费) 安装完以后的检测指令:node -v (在这里安装需要注意一 ...
- Codeforces831A Unimodal Array
A. Unimodal Array time limit per test 1 second memory limit per test 256 megabytes input standard in ...
- poj 3159
差分约束 我也忘了谁说的了,反正我记得有人说过,只要是差分约束问题都可以转换成图 至少目前看来都是这样的 我一开始spfa+queue超时 看别人博客才知道要用spfa+stack,感觉智商又下降了一 ...
- 《HTTP权威指南》1-HTTP概要
Http HyperText Transfer Protocol,超文本协议通过此协议,我们可以将遍布全世界的Web服务器上的信息块快速,便捷,可靠的搬移到我们自己桌面上的Web浏览器上.这些信息块指 ...
- ZKWeb网页框架2.1正式发布
2.1.0更新的内容有 更新引用类库 NHibernate 5.1.0 Npgsql 3.2.7 MySqlConnector 0.37.0 Dapper 1.50.4 Dommel 1.10.1 Z ...
- Java 使用 Jxl 实现 Excel 导入导出
开发过程中经常需要用到数据的导入导出功能,之前用的是POI,这次使用JXL,JXL相对于POI来说要轻量简洁许多,在数据量不大的情况下还是非常实用的.这里做一下使用JXL的学习记录.首先需要导入相应的 ...