
Lucene入门学习
技术原理:
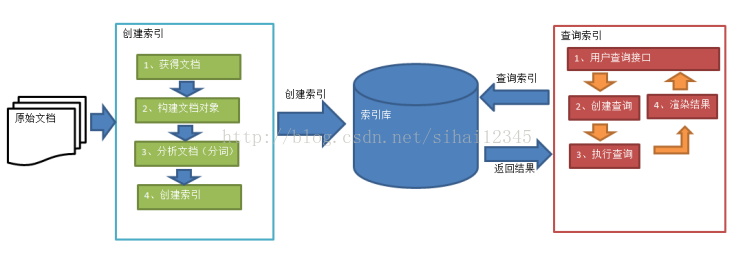
开发环境:
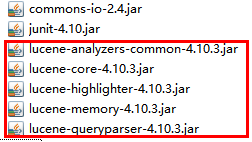
lucene包:分词包,核心包,高亮显示(highlight和memory),查询包。(下载请到官网去查看,如若下载其他版本,请看我的上篇文档,在luke里面)
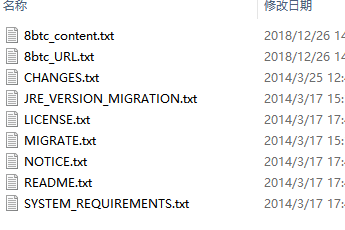
原文文档:
入门程序:
 package com.itheima.lucene;

 import java.io.File;

 import java.io.FileReader;

 import org.apache.lucene.analysis.Analyzer;

 import org.apache.lucene.analysis.standard.StandardAnalyzer;

 import org.apache.lucene.document.Document;

 import org.apache.lucene.document.Field;

 import org.apache.lucene.document.TextField;

 import org.apache.lucene.index.DirectoryReader;

 import org.apache.lucene.index.IndexWriter;

 import org.apache.lucene.index.IndexWriterConfig;

 import org.apache.lucene.queryparser.classic.QueryParser;

 import org.apache.lucene.search.IndexSearcher;

 import org.apache.lucene.search.Query;

 import org.apache.lucene.search.ScoreDoc;

 import org.apache.lucene.search.TopDocs;

 import org.apache.lucene.store.Directory;

 import org.apache.lucene.store.FSDirectory;

 import org.apache.lucene.util.Version;

 /**

  *

  * @author  *

  */

 public class Test1 {

 //创建索引

     public static void index() {

         IndexWriter indexWriter = null;

         try {

             // 1、创建Directory

             //JDK 1.7以后 open只能接收Path

             Directory directory = FSDirectory.open(new File("E:\\spider\\index"));

             // 2、创建IndexWriter

             Analyzer analyzer = new StandardAnalyzer();

             IndexWriterConfig config = new IndexWriterConfig(Version.LATEST, analyzer);

             indexWriter = new IndexWriter(directory, config);

             indexWriter.deleteAll();//清除以前的index

             //要搜索的File路径

             File dFile = new File("E:\\spider\\2018-12-26");

             File[] files = dFile.listFiles();

             for (File file : files) {

                 // 3、创建Document对象

                 Document document = new Document();

                 // 4、为Document添加Field

                 // 第三个参数是FieldType 但是定义在TextField中作为静态变量,看API也不好知道怎么写

                 document.add(new Field("content", new FileReader(file), TextField.TYPE_NOT_STORED));

                 document.add(new Field("filename", file.getName(), TextField.TYPE_STORED));

                 document.add(new Field("filepath", file.getAbsolutePath(), TextField.TYPE_STORED));

                 // 5、通过IndexWriter添加文档到索引中

                 indexWriter.addDocument(document);

             }

         } catch (Exception e) {

             e.printStackTrace();

         } finally {

             try {

                 if (indexWriter != null) {

                     indexWriter.close();

                 }

             } catch (Exception e) {

                 e.printStackTrace();

             }

         }

     }
     //搜索

     public static void search(String keyWord) {

         DirectoryReader directoryReader = null;

         try {

             // 1、创建Directory

             Directory directory = FSDirectory.open(new File("E:\\spider\\index"));

             // 2、创建IndexReader

             directoryReader = DirectoryReader.open(directory);

             // 3、根据IndexReader创建IndexSearch

             IndexSearcher indexSearcher = new IndexSearcher(directoryReader);

             // 4、创建搜索的Query

             Analyzer analyzer = new StandardAnalyzer();

             // 创建parser来确定要搜索文件的内容,第一个参数为搜索的域

             QueryParser queryParser = new QueryParser("content", analyzer);

             // 创建Query表示搜索域为content包含UIMA的文档

             Query query = queryParser.parse(keyWord);

             // 5、根据searcher搜索并且返回TopDocs

             TopDocs topDocs = indexSearcher.search(query, 10);

             System.out.println("查找到的文档总共有:"+topDocs.totalHits);

             // 6、根据TopDocs获取ScoreDoc对象

             ScoreDoc[] scoreDocs = topDocs.scoreDocs;

             for (ScoreDoc scoreDoc : scoreDocs) {

                 // 7、根据searcher和ScoreDoc对象获取具体的Document对象

                 Document document = indexSearcher.doc(scoreDoc.doc);

                 // 8、根据Document对象获取需要的值

                 System.out.println("文件名:"+document.get("filename") + " " +"文件路径:"+ document.get("filepath"));

                 System.out.println("-----------------------------------------");

             }

         } catch (Exception e) {

             e.printStackTrace();

         } finally {

             try {

                 if (directoryReader != null) {

                     directoryReader.close();

                 }

             } catch (Exception e) {

                 e.printStackTrace();

             }

         }

     }
     //主方法

         public static void main(String args[]) {

             index();

            search("java");//搜索带 java语汇单元的信息。(单词)

         }

 }
结果显示:

(学习路径还很长,不要捉急慢慢来)。
Lucene入门学习的更多相关文章
- Lucene入门学习二
接上篇:增删改查 增加:这里不做过多阐述. 删除:删除全部,根据条件删除 修该:先删除,后添加 查询(*):查询所有,精确查询,根据数值范围查询,组合查询,解析查询. package com.ithe ...
- Lucene.net入门学习
Lucene.net入门学习(结合盘古分词) Lucene简介 Lucene是apache软件基金会4 jakarta项目组的一个子项目,是一个开放源代码的全文检索引擎工具包,即它不是一个完整的全 ...
- Lucene.net入门学习系列(2)
Lucene.net入门学习系列(2) Lucene.net入门学习系列(1)-分词 Lucene.net入门学习系列(2)-创建索引 Lucene.net入门学习系列(3)-全文检索 在使用Luce ...
- Lucene.net入门学习系列(1)
Lucene.net入门学习系列(1) Lucene.net入门学习系列(1)-分词 Lucene.net入门学习系列(2)-创建索引 Lucene.net入门学习系列(3)-全文检索 这几天在公 ...
- Elasticsearch7.X 入门学习第五课笔记---- - Mapping设定介绍
原文:Elasticsearch7.X 入门学习第五课笔记---- - Mapping设定介绍 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本 ...
- Elasticsearch7.X 入门学习第一课笔记----基本概念
原文:Elasticsearch7.X 入门学习第一课笔记----基本概念 版权声明:本文为博主原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接和本声明. 本文链接:https: ...
- vue入门学习(基础篇)
vue入门学习总结: vue的一个组件包括三部分:template.style.script. vue的数据在data中定义使用. 数据渲染指令:v-text.v-html.{{}}. 隐藏未编译的标 ...
- Hadoop入门学习笔记---part4
紧接着<Hadoop入门学习笔记---part3>中的继续了解如何用java在程序中操作HDFS. 众所周知,对文件的操作无非是创建,查看,下载,删除.下面我们就开始应用java程序进行操 ...
- Hadoop入门学习笔记---part3
2015年元旦,好好学习,天天向上.良好的开端是成功的一半,任何学习都不能中断,只有坚持才会出结果.继续学习Hadoop.冰冻三尺,非一日之寒! 经过Hadoop的伪分布集群环境的搭建,基本对Hado ...
随机推荐
- centos下安装wireshark 抓包
centos下安装wireshark相当简单.两条命令就够了.这里.主要是记录写使用方面的东西 安装:1.yum install wireshark.注意这样并无法使用wireshark命令和图形界面 ...
- 对Unity的Resources目录进行改名
项目用的是Unity5.5版本,开发的时候将相关的图集.预制对象资源都放在 Resources 目录下,而真机使用的是 StreamingAssets 目录下的资源. Resources(不分层级)在 ...
- wordclock中文模式快一个小时怎么调整
wordclock屏幕保护,设置为中文模式,显示的时间比系统时间要快一个小时,其实软件自带的配置文件可以设置调整到正常时间…… 工具/原料 wordclock 方法/步骤 桌面上右键菜 ...
- 【JavaScript从入门到精通】第一课 初探JavaScript魅力-01
第一课 初探JavaScript魅力-01 JavaScript是什么 如今我们打开一个大型的网站,都会有很多JS效果的功能和应用.对于学过CSS+HTML的同学,即使是像淘宝那样的网站,用一两天时间 ...
- 阿里云配置gitlab邮箱
gitlab_rails['gitlab_email_from'] = 'username@163.com' user['git_user_email'] = "username@163.c ...
- 招中高级web开发工程师
>>招中高级web开发工程师
- 转载:MVC升级以后出现"当前上下文中不存在ViewBag"的问题解决
MVC升级以后出现"当前上下文中不存在ViewBag"的问题解决 把自己的项目从MVC4升级到了MVC5,结果问题一大堆,View的设计环境出现了"当前上下文中不存在Vi ...
- python sphinx 文档自动生成方法
## sphinx 生成开发文档#### 配置 1. 运行如下命令,即可生成 conf.py index.rst Makefile 三个文件: `sphinx-quickstart` 2. conf. ...
- vue2 枚举类型转换
vue2页面上要把数字0,1,2...之类的数值转换成对应的枚举文本,解决如下: 方案一: 如果是是否的问题,直接: {{enable == 1 ? '是' : '否'}} 即可. 方案二: 通过定义 ...
- 解决Protobuf生成的C#代码命名不规范问题
起因 通常使用Protobuf的步骤为 定义 .proto 文件 使用 protoc 生成对应语言的代码 以生成C#代码为例,使用如下命令: protoc -I ../protos --csharp_ ...