
Hbase记录-ZooKeeper介绍
ZooKeeper是一个分布式协调服务来管理大量的主机。协调和管理在分布式环境的一个服务是一个复杂的过程。ZooKeeper 简单解决了其结构和API这个问题。ZooKeeper允许开发人员能够专注于核心应用程序逻辑,而无需担心应用程序的分布式特性。
ZooKeeper框架始建于“雅虎”,一个简单而强大的方法用于访问应用程序。后来 Apache ZooKeeper 成为用 Hadoop,HBase 的组织服务以及其他分布式架构的标准。例如,Apache HBase 使用 ZooKeeper 跟踪分布式数据的状态。
Apache ZooKeeper是由群集(组节点)之间进行相互协调,并保持强大的同步技术共享数据的服务。ZooKeeper本身是一个分布式应用写入分布式应用提供服务。
ZooKeeper 提供的通用服务如下-
命名服务 − 确定在一个集群中的节点的名字。它类似于DNS,只不是过节点。
配置管理 − 系统最近加入节点和向上最新配置信息。
集群管理 − 加入/节点的群集和节点状态实时离开。
节点领导者选举 − 选举一个节点作为领导者协调的目的。
锁定和同步服务 − 锁定数据,同时修改它。这种机制可以帮助自动故障恢复,同时连接其它的分布式应用程序。如Apache HBase。
高可靠的数据注册表 − 一个或几个节点的可用性的数据向下。
分布式应用程序提供了很多好处,但他们也带来了一些复杂的,难以破解的挑战。ZooKeeper框架提供了完整的机制来克服所有挑战。竞争条件和死锁使用故障安全同步的方式进行处理。另一个主要缺点是不一致的数据,ZooKeeper 使用原子性解决。
ZooKeeper的优点
下面是使用 ZooKeeper 的好处 -
简单的分布式协调过程
同步 − 互斥和服务器进程之间的合作。这个过程有助于Apache HBase 的配置管理。
有序消息
序列化− 根据特定的规则进行编码数据。确保应用程序不断地运行。这种方法可以用来在MapReduce的协调队列以执行正在运行的线程。
可靠性
原子性 − 数据传输成功或完全失败,但没有事务处理部分。
ZooKeeper的体系结构
看看下面的图。它描绘ZooKeeper 的“客户端 - 服务器架构”。
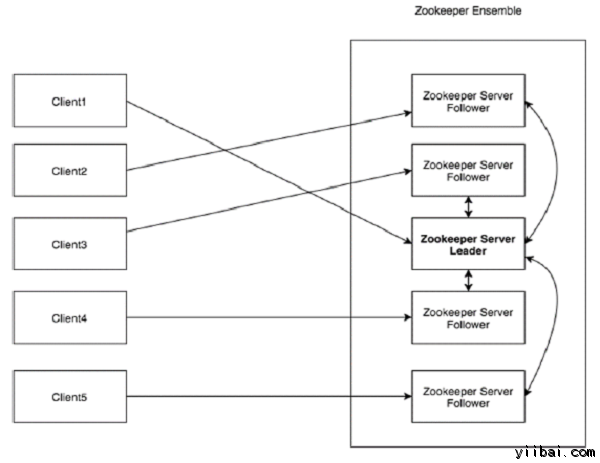
ZooKeeper 架构的一部分组件如下表中所解释。
| 部分 | 描述 |
|---|---|
| Client |
客户端,在我们的分布式应用集群的一个节点,从服务器获取信息。对于一个特定的时间间隔,每个客户端将消息发送到服务器,以让服务器都知道客户机是活的。 同样,服务器会发送一个确认当客户端连接。如果没有从所连接的服务器的响应,客户端自动重定向消息到另一个服务器 |
| Server | 服务器,ZooKeeper集成的一个节点,提供所有的服务提供给客户。给出应答客户,告知该服务器还活着 |
| 合组 | ZooKeeper 服务器组。节点所需要形成的合奏的最小数目为3 |
| Leader | 它执行自动恢复,如果任何连接的节点的故障的服务器节点。领导者服务启动 |
| Follower | 遵循领导指示服务器节点 |
分层命名空间
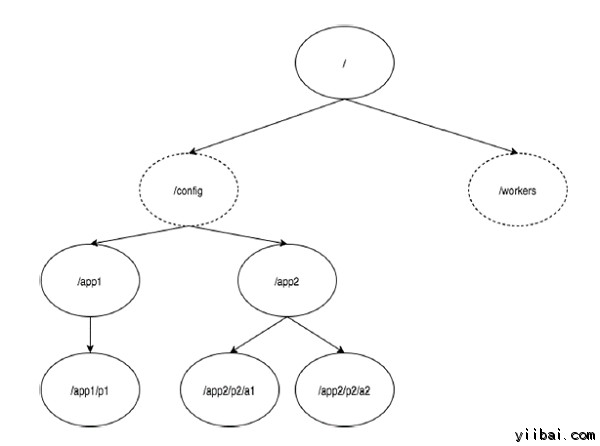
下图显示了用于内存中表示 ZooKeeper 文件系统的树形结构。 ZooKeeper节点被称为znode。每个znode由一个名称识别,并通过路径(/)序列隔开。
在图中,首先有一个根znode,它由“/”分隔。在根下,有两个逻辑命名空间 config 和 workers。
在config命名空间用于集中配置管理以及 workers 命名空间用于命名。
在 config 命名空间下,每个znode可以存储高达 1MB 的数据。这类似于UNIX文件系统,不同的是父 znode 也可以存储数据。这种结构的主要目的是存储同步数据以及描述znode的元数据。这种结构被称为 ZooKeeper数据模型。
在 ZooKeeper 数据模型中每个 znode 维护一个 stat 结构。 一个统计(stat )只是提供了一个 znode 元数据。 它由版本号,动作控制列表(ACL),时间戳和数据长度组成。
版本号 − 每个znode都有一个版本号,这意味着每个相关的时间使用节点改变数据,其相应的版本号也将增加。使用版本号是重要的,在多个 zookeeper 的客户端正在努力通过相同znode执行操作。
动作控制列表(ACL) −ACL是基本的身份验证机制,用于访问znode。它管理所有的znode读写操作。
时间戳 − 时间戳表示过去时间,从znode创建和修改起算。它通常以毫秒表示。ZooKeeper 确定每次从“事务ID”(zxid)更改znodes。Zxid是独特的,为每个事务处理维持时间,使您可以轻松地识别从一个请求到另一个请求经过的时间。
数据长度 − 存储在 znode 数据的合计量是数据长度。可以存储的最大数据容量为1MB。
Znodes 类型
Znodes 被归类为持久性,顺序和短暂。
持久性znode − 持久性 znode 处于活动状态,即使客户端,它创造了特定的 znode。默认情况下,所有的 znodes 是持久的,除非另有说明。
短暂znode − 短暂znodes活跃,直到客户端还活着。当客户端被从 ZooKeeper 集合断开连接,然后znodes自动删除。由于这个原因,只有短暂znodes不允许再有一个子。如果短周期znode被删除,那么下一个合适的节点,将填补其位置。短暂znodes 发挥在领导选举中起重要作用。
连续znode − 连续znodes可以是持久或短暂的。当一个新的znode作为连续znode创建的,则 ZooKeeper 通过将10位的序列号为原始名称设置znode的路径。例如,如果使用路径 /myapp 来创建一个znode作为连续znode,ZooKeeper将改变路径 /myapp0000000001并设置一个序列号为0000000002。如果两个连续znodes同时被创建,ZooKeeper从来不使用相同数量在每个znode上。连续znodes在锁定和同步中起到重要作用。
会话
会话对于 ZooKeeper 操作是非常重要的。请求在会话 FIFO 顺序执行。当一个客户端连接到服务器,会话将建立一个会话ID并分配给客户端。
客户端在特定的时间间隔发送心跳来保持会话有效。如果 ZooKeeper 从客户端接收检测信号超过在服务的开始指定的期间(会话超时),它认为该客户死亡。
会话超时通常以毫秒表示。当一个会话因任何原因而结束,该会话期间短暂创造了的 znodes 会被删除。
监视
监视是一个简单的机制,在ZooKeeper集合通知下以获取客户有关的变化。 客户端可以设置监视,同时读取特定znode。监视发送通知给注册的客户机对任何znode(在其上的客户端寄存器)的变化。
节点改变时znode或子znode变化相关联的数据也会被修改。监视只被触发一次。如果客户想要再次通知,则必须通过另一次读操作来完成。当一个连接会话已过期,客户端会从服务器断开,并在相关的监视也将被删除。
Zookeeper工作流
当ZooKeeper集合启动时,它会等待客户端连接。客户端将连接到ZooKeeper的集合的其中一个节点。它可能是一个领导者或跟随者节点。当客户机连接时,该节点分配会话ID给特定的客户端,并发送一个确认消息给客户端。如果客户端没有得到确认,它会尝试连接ZooKeeper集合的另一个节点。当连接到一个节点后,客户端将以规则的间隔发送心跳到节点,以确保连接不会丢失。
如果客户想要读取特定的znode,它发送一个读请求使用znode路径的节点,所述节点从其自己的数据库中获取它返回所请求的znode。出于这个原因,读取在动物园管理员集合中速度非常快。
如果客户希望将数据存储在ZooKeeper 集合,它发送znode路径和数据到服务器。连接的服务器将请求转发到领导者,那么领导者将重新发出书面请求到所有的追随者。如果只有一个数节点成功响应,接着写请求将成功及一个成功的返回代码将被发送到客户端。否则,写请求将失败。严格大部分节点被称为定额。
ZooKeeper集合的节点
让我们来分析ZooKeeper集合不同数量的节点的作用。
如果我们有一个节点,那么当该节点出现故障时ZooKeeper集合失败。它有利于“单一失败教程”,它不建议用在生产环境中。
如果我们有两个节点,一个节点出现故障,我们也没有“多数”,因为二分之一并不是一个大多数。
如果我们有三个节点及其一个节点发生故障,我们有大多数,因此它是最低要求。它强制 ZooKeeper 集合在实际生产环境中至少有三个节点。
如果我们有四个节点及其有当两个节点失败,它类似于有三个节点。额外的节点没有任何作用,因此,最好是单数增加节点,例如,3, 5, 7.
我们知道,写处理它比在 ZooKeeper 集合读过程是昂贵的,由于所有的节点需要写相同的数据在其数据库中。因此,最好是具有节点(3,5或7)比具有大量节点的一个平衡的环境的数量少。
下图描述了ZooKeeper 的工作流程以及在随后的表说明了其不同的组件。

| 组件 | 描述 |
|---|---|
| 写入 | 写过程是由领导节点处理。领导者转发写请求到所有znodes及其等待来自znodes应答。如果一半的znodes的回复,那么写入过程就完成了。 |
| 读取 | 读取在内部由特定连接znode进行的,所以没有必要与集群交互。 |
| 复制数据库 | 它是用来将数据存储在zookeeper。每个znode都有自己的数据库及其每个znode 在一致性的作用下,每次有相同的数据。 |
| 领导者(节点) | 领导者是由Znode负责处理写请求。 |
| 追随者(节点) | 追随者收到来自客户端的写请求,并将其转发到领导znode。 |
| 请求处理器 | 目前仅在领导节点。它从跟随节点的请求支配写入。 |
| 原子广播 | 负责从领导节点到从节点广播更改。 |
Zookeeper领导人选举
让我们来分析一下一个领导节点在ZooKeeper集合的选举。考虑集群中有N多的节点。领导人选举的过程如下 −
所有节点创建一个顺序,znode具有相同路径,/app/leader_election/guid_。
ZooKeeper 的集合将追加的10位序列号的路径,创造了 znode 将会是 /app/leader_election/guid_0000000001, /app/leader_election/guid_0000000002, ...等。
对于给定的实例,它在znode创建最小数量的节点成为领导者以及所有其他节点的追随者。
每一个追随者节点监控下一个最小号的znode。
例如,节点这将创建znode /app/leader_election/guid_0000000008 将监控znode/app/leader_election/guid_0000000007
及其该节点创建znode /app/leader_election/guid_0000000007 将监控znode /app/leader_election/guid_0000000006.
如果领导停机,接着其对应的znode/app/leader_electionN被删除。
跟随节点接下来将通过观察者得到关领导去除的通知。
跟随节点接下来会检查是否有其他znodes用最小数量。 如果没有,接着它将承担领导者的角色。否则,它会找到哪些用最小数创造了znode作为领导者的节点。
同样,其他所有跟随节点选举创造了znode用最小数作为领导者的节点。
领导人选举时,它从头开始做一个复杂的过程。但ZooKeeper服务,使得它非常简单。让我们在接下来的章节介绍 ZooKeeper 安装和开发。
Zookeeper CLI
ZooKeeper 命令行界面(CLI)是用来与 ZooKeeper 集成作开发进行交互的。这是在调试和使用不同的选项时的工作有用。
为了执行ZooKeeper的CLI操作, ZooKeeper服务器首先要启动 (“bin/zkServer.sh start”) , 然后使用 ZooKeeper 客户端 (“bin/zkCli.sh”). 当客户端启动后,可以执行以下操作 -
- 创建znodes
- 获取数据
- 监视 znode 变化
- 设置数据
- 创建 znode 的子 znode
- 列出一个 znode 的子 znode
- 检查状态
- 删除一个 znode
现在,让我们一个个用一个例子地来看上面的命令。
创建Znodes
由一个给定的路径来创建znode。flag参数指定了创建的 znode 是否为短暂的,持久的,或连续的。默认情况下,所有的 znodes是持久的。
短暂 znodes(flag: e)当会话过期或当客户端断开连接将被自动删除。
连续 znodes 保证 znode 路径是唯一的。
ZooKeeper集成将沿着添加序列号使用10位填充到znode路径。例如,znode路径 /myapp 将被转换为 /myapp0000000001 以及下一个序列号将是 /myapp0000000002. 如果没有指定flag,那么 znode 是持久的。
语法
create /path /data
示例
create /FirstZnode “Myfirstzookeeper-app”
输出结果
[zk: localhost:2181(CONNECTED) 0] create /FirstZnode “Myfirstzookeeper-app”

Created /FirstZnode
要创建一个连续znode,如下图所示添加 -s 标志。
语法
create -s /path /data
示例
create -s /FirstZnode second-data
输出
[zk: localhost:2181(CONNECTED) 2] create -s /FirstZnode “second-data”

Created /FirstZnode0000000023
要创建一个临时Znode,添加-e标志,如下图所示。
语法
create -e /path /data
示例
create -e /SecondZnode “Ephemeral-data”
输出
[zk: localhost:2181(CONNECTED) 2] create -e /SecondZnode “Ephemeral-data”

Created /SecondZnode
记住,当丢失一个客户端连接,在临时 znode 将被删除。可以通过退出 ZooKeeper CLI 尝试,然后重新打开命令行。
获取数据
它返回 znode 的相关数据和指定 znode 元数据。这里将得到信息,例如当数据最后一次修改,在那里它被修改和有关数据的信息。此外 CLI 还用于分配监视显示通知有关的数据。
语法
get /path
示例
get /FirstZnode
输出
[zk: localhost:2181(CONNECTED) 1] get /FirstZnode

“Myfirstzookeeper-app”

cZxid = 0x7f

ctime = Tue Sep 29 16:15:47 IST 2015

mZxid = 0x7f

mtime = Tue Sep 29 16:15:47 IST 2015

pZxid = 0x7f

cversion = 0

dataVersion = 0

aclVersion = 0

ephemeralOwner = 0x0

dataLength = 22

numChildren = 0
要访问顺序znode,必须输入znode的完整路径。
示例
get /FirstZnode0000000023
输出
[zk: localhost:2181(CONNECTED) 1] get /FirstZnode0000000023

“Second-data”

cZxid = 0x80

ctime = Tue Sep 29 16:25:47 IST 2015

mZxid = 0x80

mtime = Tue Sep 29 16:25:47 IST 2015

pZxid = 0x80

cversion = 0

dataVersion = 0

aclVersion = 0

ephemeralOwner = 0x0

dataLength = 13

numChildren = 0
监视
监视显示通知当指定znode或znode的子数据变化。只能在 get 命令中设置监视。
语法
get /path [watch] 1
示例
get /FirstZnode 1
输出
[zk: localhost:2181(CONNECTED) 1] get /FirstZnode 1

“Myfirstzookeeper-app”

cZxid = 0x7f

ctime = Tue Sep 29 16:15:47 IST 2015

mZxid = 0x7f

mtime = Tue Sep 29 16:15:47 IST 2015

pZxid = 0x7f

cversion = 0

dataVersion = 0

aclVersion = 0

ephemeralOwner = 0x0

dataLength = 22

numChildren = 0
输出类似于正常get命令,但它会在后台等待节点改变。
设置数据
设置指定znode的数据。当你完成设置操作,就可以使用get CLI命令检查数据。
语法
set /path /data
示例
set /SecondZnode Data-updated
输出
[zk: localhost:2181(CONNECTED) 1] get /SecondZnode “Data-updated”

cZxid = 0x82

ctime = Tue Sep 29 16:29:50 IST 2015

mZxid = 0x83

mtime = Tue Sep 29 16:29:50 IST 2015

pZxid = 0x82

cversion = 0

dataVersion = 1

aclVersion = 0

ephemeralOwner = 0x15018b47db00000

dataLength = 14

numChildren = 0
如果分配监视选项在get命令(之前的命令),则输出将类似如下 -
输出
[zk: localhost:2181(CONNECTED) 1] get /FirstZnode “Mysecondzookeeper-app”

WATCHER: :

WatchedEvent state:SyncConnected type:NodeDataChanged path:/FirstZnode

cZxid = 0x7f

ctime = Tue Sep 29 16:15:47 IST 2015

mZxid = 0x84

mtime = Tue Sep 29 17:14:47 IST 2015

pZxid = 0x7f

cversion = 0

dataVersion = 1

aclVersion = 0

ephemeralOwner = 0x0

dataLength = 23

numChildren = 0
创建子znode
创建子znode类似于创建新的znodes。唯一的区别在于,子 znode 的路径将包含有父路径。
语法
create /parent/path/subnode/path /data
示例
create /FirstZnode/Child1 firstchildren
输出
[zk: localhost:2181(CONNECTED) 16] create /FirstZnode/Child1 “firstchildren”

created /FirstZnode/Child1

[zk: localhost:2181(CONNECTED) 17] create /FirstZnode/Child2 “secondchildren”

created /FirstZnode/Child2
列出子znode
该命令用于列出和显示子 znode 。
语法
ls /path
示例
ls /MyFirstZnode
输出
[zk: localhost:2181(CONNECTED) 2] ls /MyFirstZnode

[mysecondsubnode, myfirstsubnode]
检查状态
状态描述了指定znode的元数据。它包含详细信息,如时间戳,版本号,访问控制列表,数据长度和子znode。
语法
stat /path
示例
stat /FirstZnode
输出
[zk: localhost:2181(CONNECTED) 1] stat /FirstZnode

cZxid = 0x7f

ctime = Tue Sep 29 16:15:47 IST 2015

mZxid = 0x7f

mtime = Tue Sep 29 17:14:24 IST 2015

pZxid = 0x7f

cversion = 0

dataVersion = 1

aclVersion = 0

ephemeralOwner = 0x0

dataLength = 23

numChildren = 0
删除Znode
删除指定znode和递归删除所有的子znode。这只有在znode可用时发生。
语法
rmr /path
示例
rmr /FirstZnode
输出
[zk: localhost:2181(CONNECTED) 10] rmr /FirstZnode

[zk: localhost:2181(CONNECTED) 11] get /FirstZnode

Node does not exist: /FirstZnode
删除(删除/路径)命令类似remove命令,但它仅适用于无子znode的znode。
Hbase记录-ZooKeeper介绍的更多相关文章
- Hbase记录-zookeeper部署
#官网下载二进制包解压到/usr/app下,配置/etc/profile: export ZOOKEEPER_HOME=/usr/app/zookeeper export PATH=$PATH:$ZO ...
- Hbase记录-ZooKeeper API
Zookeeper API ZooKeeper有一个Java和C绑定的官方API.ZooKeeper社区提供了对于大多数语言(.NET,Python等)的非官方API.使用ZooKeeper的API, ...
- Hbase记录-Hbase介绍
Hbase是什么 HBase是一种构建在HDFS之上的分布式.面向列的存储系统,适用于实时读写.随机访问超大规模数据的集群. HBase的特点 大:一个表可以有上亿行,上百万列. 面向列:面向列表(簇 ...
- 竞价广告系统-ZooKeeper介绍
ZooKeeper介绍 为了讲述的完整性,介绍一下ZooKeeper.ZooKeeper在Index和Ad Server里使用比较多,虽然它可能没有google的Chubby好,但它是开源的工具.举一 ...
- Zookeeper系列一:Zookeeper介绍、Zookeeper安装配置、ZK Shell的使用
https://www.cnblogs.com/leeSmall/p/9563547.html 一.Zookeeper介绍 1. 介绍Zookeeper之前先来介绍一下分布式 1.1 分布式主要是下面 ...
- zookeeper 介绍与集群安装
zookeeper 介绍 ZooKeeper是一个分布式开源框架,提供了协调分布式应用的基本服务,它向外部应用暴露一组通用服务——分布式同步(Distributed Synchronization). ...
- Hbase记录-Hbase基础概念
HBase是什么? HBase是建立在Hadoop文件系统之上的分布式面向列的数据库.它是一个开源项目,是横向扩展的. HBase是一个数据模型,类似于谷歌的大表设计,可以提供快速随机访问海量结构化数 ...
- 【HBase】zookeeper在HBase中的应用
转自:http://support.huawei.com/ecommunity/bbs/10242721.html Zookeeper在HBase中的应用 HBase部署相对是一个较大的动作,其依赖于 ...
- Zookeeper介绍及安装部署
本节内容: Zookeeper介绍 Zookeeper特点 Zookeeper应用场景 用到了Zookeeper的一些系统 Zookeeper集群安装部署 一.Zookeeper介绍 是一个针对大型分 ...
随机推荐
- Tomcat7解决java.lang.OutOfMemoryError: PermGen space
上述两参数,可根据实际情况,逐渐调大.
- redi集群测试
redis集群的测试 原文:http://blog.sina.com.cn/s/blog_53b45c4d0102wg10.html 1.测试存取值 客户端连接集群redis-cli需要带上 -c ...
- lsof 查看端口占用的进程ID
1. nohup execute >/dev/null 2>&1 & 提交了一个后台jobs 2. 然后查看一下 哪个进程正在用 3. yum 安装lsof yum ins ...
- Windows 通过命令行设置固定ip地址
Winserver1709 之后 windows系统取消了GUI界面 设置ip地址 需要使用命令行界面进行 这里简单记录一下 打开win1709的虚拟机 进入命令行控制台 输入 ipconfig 查看 ...
- python 时间转换相关
最近需要操作时间的地方相当的多,包括打点,包括时间转换. 罗列最近遇到的两个需求. 1. 关于上篇文章写的base64上传图片的问题,我使用了打点来计算解码需要多少时间.这个对时间精度要求是比较高的. ...
- BZOJ2843极地旅行社&BZOJ1180[CROATIAN2009]OTOCI——LCT
题目描述 给出n个结点以及每个点初始时对应的权值wi.起始时点与点之间没有连边.有3类操作: 1.bridge A B:询问结点A与结点B是否连通. 如果是则输出“no”.否则输出“yes”,并且在 ...
- BZOJ3881[Coci2015]Divljak——AC自动机+树状数组+LCA+dfs序+树链的并
题目描述 Alice有n个字符串S_1,S_2...S_n,Bob有一个字符串集合T,一开始集合是空的. 接下来会发生q个操作,操作有两种形式: “1 P”,Bob往自己的集合里添加了一个字符串P. ...
- day11 filter函数
场景模拟:我想判断某个列表里面的某个元素怎么怎么样 基础方法,如果需要判断多次则重复代码 ret = [] move_peole = ["alex","sb_wupeiq ...
- 自学Aruba7.2-Aruba安全认证-Portal认证(web页面配置)
点击返回:自学Aruba之路 自学Aruba7.2-Aruba安全认证-Portal认证(web页面配置) 步骤1 建立AP Group,命名为testportal-group 步骤2 将AP加入到 ...
- 学习Spring Boot:(二十三)Spring Boot 中使用 Docker
前言 简单的学习下怎么在 Spring Boot 中使用 Docker 进行构建,发布一个镜像,现在我们通过远程的 docker api 构建镜像,运行容器,发布镜像等操作. 这里只介绍两种方式: 远 ...