
Python爬取6271家死亡公司数据,看十年创业公司消亡史
前言
文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
作者: 朱小五 凹凸玩数据
PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取
http://note.youdao.com/noteshare?id=3054cce4add8a909e784ad934f956cef
前段时间老罗和王校长都成为自己的创业公司成了失信人,小五打算上IT桔子看看他们的公司。
意外发现IT桔子出了个死亡公司库,统计了2000-2019年之间比较出名的公司“死亡”数据。
小五利用python将其中的死亡公司数据爬取下来,借此来观察最近十年创业公司消亡史。
获取数据
F12,Network查看异步请求XHR,翻页。
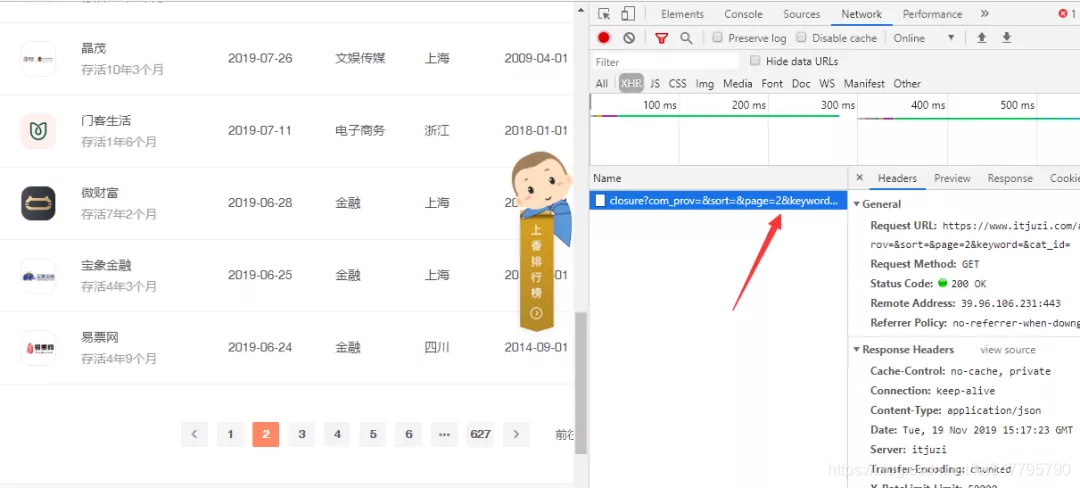
成功找到返回json格式数据的url,
https://www.itjuzi.com/api/closure?com_prov=&fund_status=&sort=&page=1
不了解json的读者可以看【python玩转Json数据】,部分爬虫代码
def main():

    data = pd.DataFrame(columns=['com_name','born','close','live_time','total_money','cat_name','com_prov','closure_type'])

    for i in range(1,2): #设置爬取N页

        url= 'https://www.itjuzi.com/api/closure?com_prov=&fund_status=&sort=&page='+ str(i)

        html = requests.get(url=url, headers=headers).content

        doc = json.loads(html.decode('utf-8'))['data']['info']

        for j in range(10): #一页10个死亡公司

            data = data.append({'com_name':doc[j]['com_name'],'born':doc[j]['born'],'cat_name':doc[j]['cat_name'],

                    'closure_type':doc[j]['closure_type'],'close':doc[j]['com_change_close_date'],'com_prov':doc[j]['com_prov'],

                    'live_time':doc[j]['live_time'],'total_money':doc[j]['total_money']},ignore_index=True)

            time.sleep(random.random())

    return data
成功获取6271家死亡公司数据。
数说10年生死相
截止 2019 年 11 月 24 日,共有近6271家公司在 IT 桔子数据库中被标注为“已关闭”,我们挑选最近十年(2010-2019)的5765家公司,来看一看这十年,创业公司的消亡。 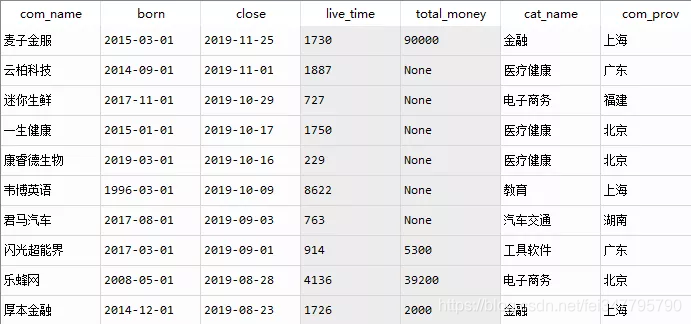
大家常说1998年是中国互联网元年,2010年是移动互联网的元年。
也难怪,2010年的移动互联网实在是太热闹了。微信、小米、美团、爱奇艺等都在这一年相继成立。
百度在谷歌退出中国后成为最大的受益者,淘宝成为阿里新的增长点,腾讯则宣布QQ同时在线超1亿人。自此,百度、阿里和腾讯正式成为“三巨头”——BAT。除此之外,网易的网游、新浪的微博、搜狐的视频和输入法也开始发力出击,移动互联网的竞争正式拉开帷幕。
2010 年来,历年出生及死亡的公司数量趋势如下图。
2013、2014 年是公司诞生潮,三年后,正好对应了2016、2017的一波死亡潮。在2017 年,超过 2000 家公司倒闭。 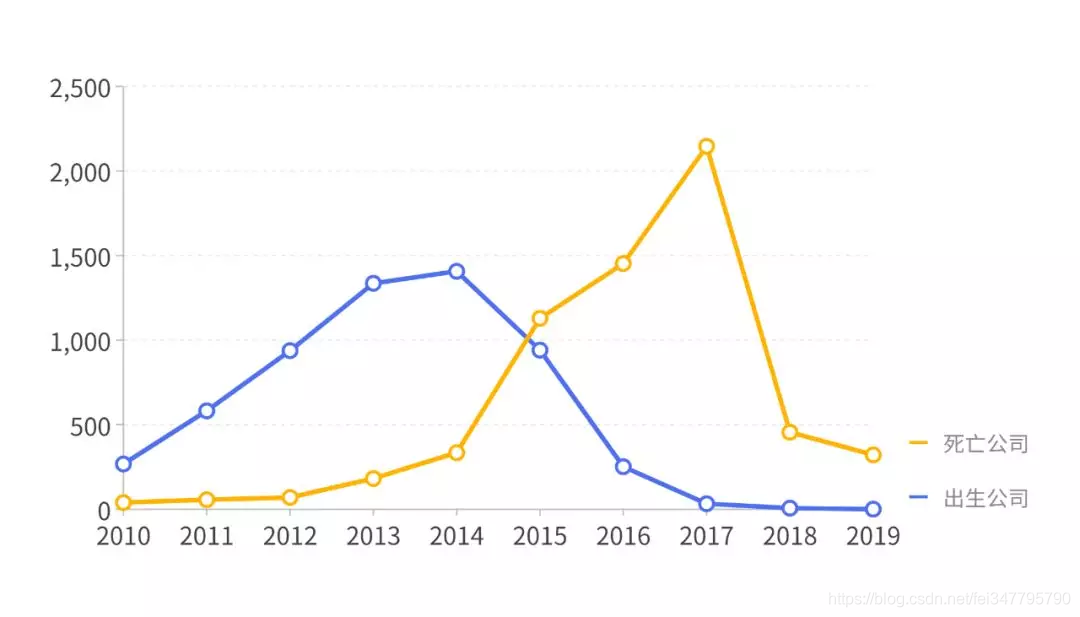
在这十年间,诸多“风口”起起伏伏。网约车、团购、直播、基因检测、共享单车、短视频、比特币、VR|AR、无人货架、人工智能、直播带货……
每一个风口上,都站着数百头“猪”,试图借力分一杯羹。
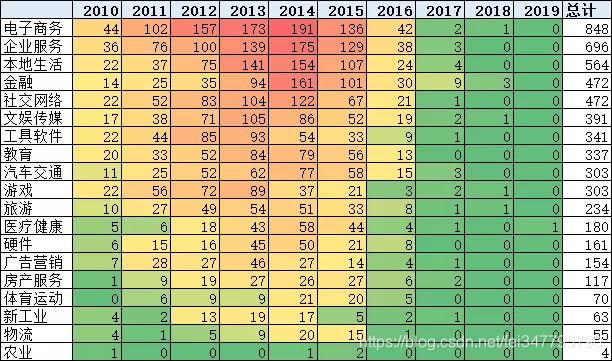
百团大战、垂直电商大战、外卖大战、打车大战、单车大战,在这些著名的战场里,各种桥段令吃瓜群众们目不暇接。有老大老二打架,老三打没了;有老二老三合并,继续和老大抗衡的;也有老大老二合并,将其他家远远甩在后面的……
还有像冲顶大会之类直播答题一样,办起来的时候,各家分庭抗礼来势汹汹,却从2018年的公历新年开始,没有挺到农历新年。
风口消亡的背后,是无数创业公司烧掉的钱,每个公司在一开始,都坚信可以烧倒对手,但烧着烧着把自己烧光了,却再也拿不到融资。
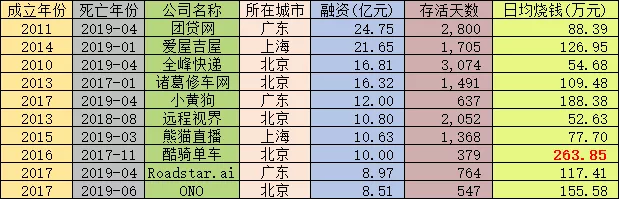
创业公司的消亡,究其原因必然是多方面的,除行业竞争激烈这一核心因素外,最主要的还是商业模式的匮乏。创业者内在对于如何维稳、如何盈利等方面欠缺的了解、思考与准备,不足以在行业稳定后,支撑他在风口来临之初的一腔热血豪情。 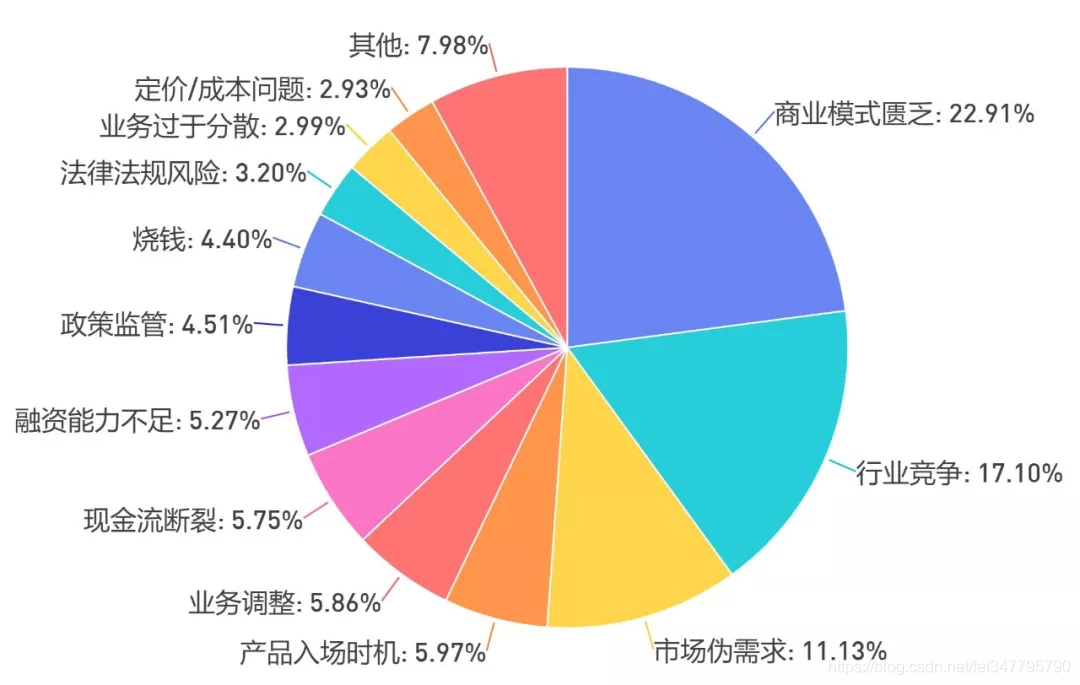
另外,“伪风口”与“伪需求”也曾迷住众多创业公司的眼。“共享经济”衍生出的共享单车、共享充电宝红红火火,但共享电话、共享厕纸、共享篮球什么的,倒也不必。
比较有意思的是,这个死亡公司数据库还加了一个#上香排行榜#,排行第一的果然是大名鼎鼎的“快播”。
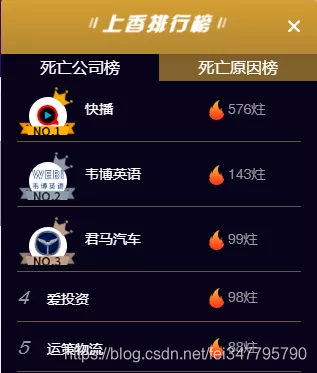
还真是有的公司死了,(在人心里)他还活着;
有的公司活着,(在人心里)他已经死去。
代码
import requests
import json
import pandas as pd
import time
import random
from fake_useragent import UserAgent
ua = UserAgent()
headers = {'User-Agent':ua.random} #伪装请求头
def main():
data = pd.DataFrame(columns=['com_name','born','close','live_time','total_money','cat_name','com_prov','closure_type'])
for i in range(1,2): #设置爬取N页
url= 'https://www.itjuzi.com/api/closure?com_prov=&fund_status=&sort=&page='+ str(i)
html = requests.get(url=url, headers=headers).content
doc = json.loads(html.decode('utf-8'))['data']['info']
for j in range(10): #一页10个死亡公司
data = data.append({'com_name':doc[j]['com_name'],'born':doc[j]['born'],'cat_name':doc[j]['cat_name'],
'closure_type':doc[j]['closure_type'],'close':doc[j]['com_change_close_date'],'com_prov':doc[j]['com_prov'],
'live_time':doc[j]['live_time'],'total_money':doc[j]['total_money']},ignore_index=True)
time.sleep(random.random())
return data
if __name__ == "__main__":
final_result = main()
#final_result.to_csv("final_result.csv", index_label="index_label",encoding='utf-8-sig')
Python爬取6271家死亡公司数据,看十年创业公司消亡史的更多相关文章
- Python爬取6271家死亡公司数据,一眼看尽十年创业公司消亡史!
小五利用python将其中的死亡公司数据爬取下来,借此来观察最近十年创业公司消亡史. 获取数据 F12,Network查看异步请求XHR,翻页. 成功找到返回json格式数据的url, 很多人 ...
- python 爬取天猫美的评论数据
笔者最近迷上了数据挖掘和机器学习,要做数据分析首先得有数据才行.对于我等平民来说,最廉价的获取数据的方法,应该是用爬虫在网络上爬取数据了.本文记录一下笔者爬取天猫某商品的全过程,淘宝上面的店铺也是类似 ...
- Python爬取链家二手房源信息
爬取链家网站二手房房源信息,第一次做,仅供参考,要用scrapy. import scrapy,pypinyin,requests import bs4 from ..items import L ...
- Python 爬取大众点评 50 页数据,最好吃的成都火锅竟是它!
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 胡萝卜酱 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- 适合初学者的Python爬取链家网教程
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: TinaLY PS:如有需要Python学习资料的小伙伴可以加点击下 ...
- 使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- [转]使用python爬取东方财富网机构调研数据
最近有一个需求,需要爬取东方财富网的机构调研数据.数据所在的网页地址为: 机构调研 网页如下所示: 可见数据共有8464页,此处不能直接使用scrapy爬虫进行爬取,因为点击下一页时,浏览器只是发起了 ...
- Python爬取上交所一年大盘数据
前言 文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 半个码农2018 PS:如有需要Python学习资料的小伙伴可以加点 ...
- Python爬取某网站文档数据完整教程(附源码)
基本开发环境 (https://jq.qq.com/?_wv=1027&k=NofUEYzs) Python 3.6 Pycharm 相关模块的使用 (https://jq.qq.com/?_ ...
随机推荐
- swoole为什么不能代替nginx
Swoole不能代替Apache和Nginx这些通用的HTTP服务器. 但基于Swoole开发的PHP应用不依赖Apache和Nginx也能提供生产级别的HTTP服务. 有需要学习交流的友人请加入交流 ...
- Linux 部署 java1.8
1.安装 查看java安装包 yum list | grep java 使用yum安装 yum install java-1.8.0-openjdk.x86_64 修改环境变量 vi /etc/pro ...
- 【pat】C++之刷题常用STL容器整理
1.vector 动态数组,方便的动态扩容,方便的变量初始化(int类型默认初始化为0,bool默认初始化为false),可以用来实现邻接表(结点数太多的图). 头文件 #include<vec ...
- 基于STM32F429,Cubemx的SDHC卡的基本Fatfs文件移植
本博文要求各位初步了解Fatfs文件系统 友情提示Fatfs官网:http://elm-chan.org/fsw/ff/00index_e.html 1.开发软件 keil5,Cube5.21 2.实 ...
- SpringMVC参数绑定,这篇就够了!
SpringMVC参数绑定,简单来说就是将客户端请求的key/value数据绑定到controller方法的形参上,然后就可以在controller中使用该参数了 下面通过5个常用的注解演示下如何进行 ...
- css网页布局模板
<!DOCTYPE html> <html> <head> <meta charset="utf-8"> <title> ...
- JMeter命令行执行+生成HTML报告
1.为什么用命令行模式 使用GUI方式启动jmeter,运行线程较多的测试时,会造成内存和CPU的大量消耗,导致客户机卡死: 所以一般采用的方式是在GUI模式下调整测试脚本,再用命令行模式执行: 命令 ...
- PostgreSQL 表字段起别名
使用Postgreq Sql 表字段起别名时注意要用双引号,使用单引号会出现语法错误,执行结果如图
- windows 应急流程及实战演练
前言 本文摘自信安之路公众号的文章. 当企业发生黑客入侵.系统崩溃或其它影响业务正常运行的安全事件时,急需第一时间进行处理,使企业的网络信息系统在最短时间内恢复正常工作,进一步查找入侵来源,还原入侵事 ...
- Xcode报错:could not attach to pid:"1764"
这种错误不是什么问题,按照参考链接操作即可,亲测有效: https://www.cnblogs.com/luorende/p/6295945.html 在运行项目时出现了如下错误 (基本上重新启动项目 ...