
假期学习【三】HDFS操作及spark的安装/使用
1.安装 Hadoop 和 Spark
进入 Linux 系统,参照本教程官网“实验指南”栏目的“Hadoop 的安装和使用”,完
成 Hadoop 伪分布式模式的安装。完成 Hadoop 的安装以后,再安装 Spark(Local 模式)。
2.HDFS 常用操作
使用 hadoop 用户名登录进入 Linux 系统,启动 Hadoop,参照相关 Hadoop 书籍或网络
资料,或者也可以参考本教程官网的“实验指南”栏目的“HDFS 操作常用 Shell 命令”,
使用 Hadoop 提供的 Shell 命令完成如下操作:
(1) 启动 Hadoop,在 HDFS 中创建用户目录“/user/hadoop”;
(2) 在 Linux 系统的本地文件系统的“/home/hadoop”目录下新建一个文本文件
test.txt,并在该文件中随便输入一些内容,然后上传到 HDFS 的“/user/hadoop”
目录下;
进入/home/hadoop目录,并创建test.txt文件

输入内容
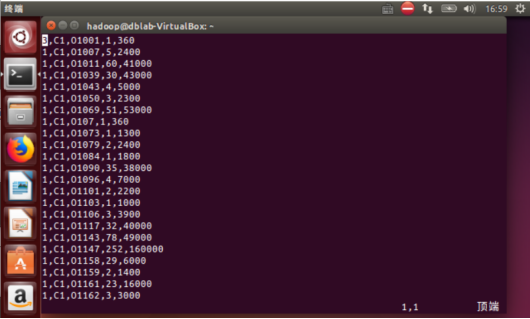
将文件上传到HDFS的/user/hadoop目录下,并查看。

可以发现已经上传成功
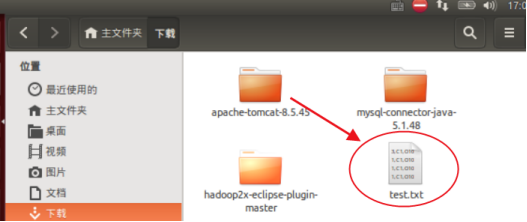
(3) 把 HDFS 中“/user/hadoop”目录下的 test.txt 文件,下载到 Linux 系统的本地文
件系统中的“/home/hadoop/下载”目录下;
执行如下命令。

可以查看到已经下载到本地。
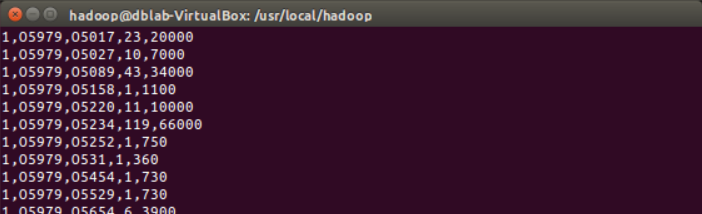
(4) 将HDFS中“/user/hadoop”目录下的test.txt文件的内容输出到终端中进行显示;
执行如下命令

可以显示
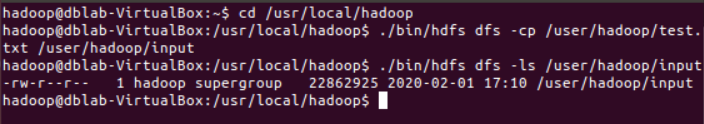
(5) 在 HDFS 中的“/user/hadoop”目录下,创建子目录 input,把 HDFS 中
“/user/hadoop”目录下的 test.txt 文件,复制到“/user/hadoop/input”目录下;
(6) 删除HDFS中“/user/hadoop”目录下的test.txt文件,删除HDFS中“/user/hadoop”
目录下的 input 子目录及其子目录下的所有内容。

3. Spark 读取文件系统的数据
Spark安装
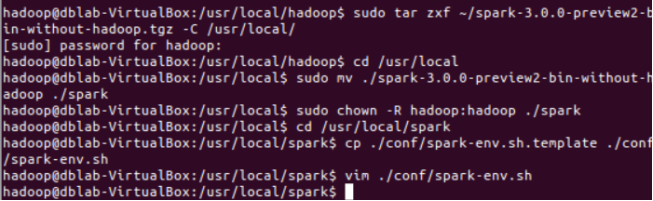
在Spark官网:http://spark.apache.org/downloads.html 下载Spark
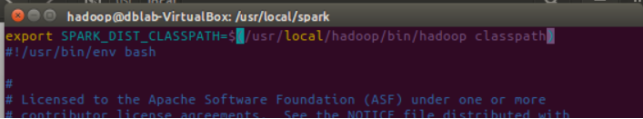
并在修改Spark的配置文件spark-env.sh添加输入下列命令:
export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoop classpath)
如图:
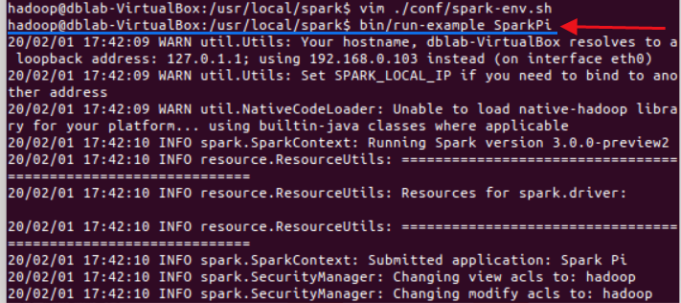
测试输入图中命令将输出大量信息
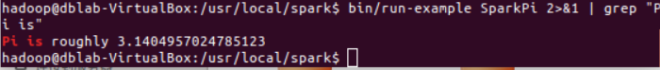
将得到一个π的近似数,说明安装成功
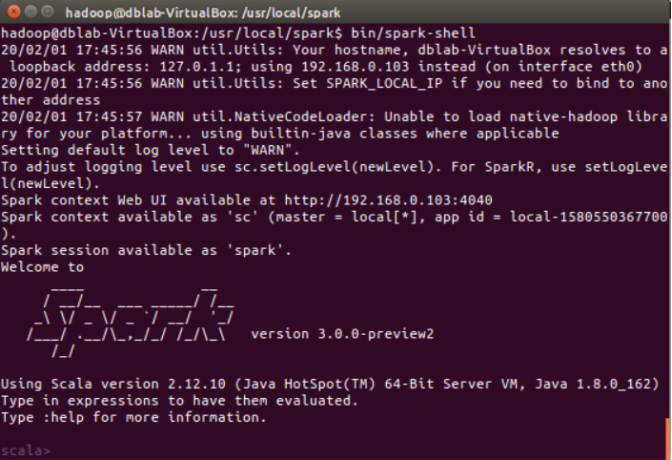
(1)在 spark-shell 中读取 Linux 系统本地文件“/home/hadoop/test.txt”,然后统计出文件的行数;
启动spark-shell
(2)在 spark-shell 中读取 HDFS 系统文件“/user/hadoop/test.txt”(如果该文件不存在,
请先创建),然后,统计出文件的行数;
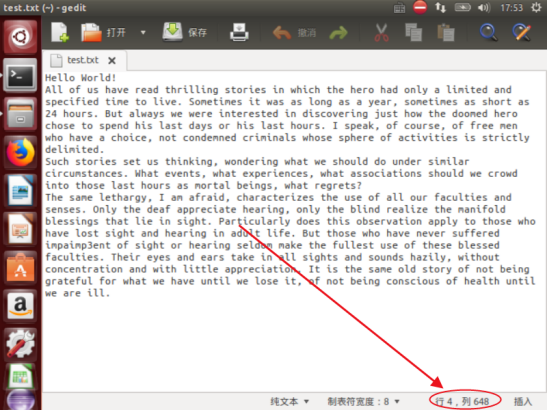
统计结果
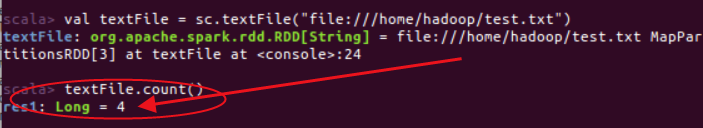
未理解的问题:
显示4行正确,但不理解为什么界面行数大于统计的行数。
(3)编写独立应用程序,读取 HDFS 系统文件“/user/hadoop/test.txt”(如果该文件不存在,
请先创建),然后,统计出文件的行数;通过 sbt 工具将整个应用程序编译打包成 JAR 包,
并将生成的 JAR 包通过 spark-submit 提交到 Spark 中运行命令。
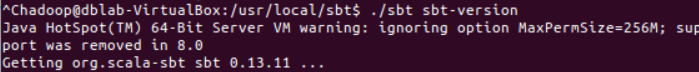
1.安装sbt
假期学习【三】HDFS操作及spark的安装/使用的更多相关文章
- git学习——<三>git操作
一.创建仓库 创建一个目录 mkdir repository cd到该目录下,初始化该版本库 git init 至此,版本库创建成功,可以在该文件夹下看到.git文件夹,ls -ah可以看到该文件夹. ...
- Redis基础学习(三)—Key操作
一.key的相关操作 1.删除 del key1 key2 ... Keyn 作用: 删除1个或多个键. 返回值: 不存在的key忽略掉,返回真正删除的key的数量. 2.重命名 rename k ...
- jquery 学习(三) - 遍历操作
HTML代码 <p>1111</p> <p>1111</p> <p>1111</p> <p>1111</p&g ...
- Python基础学习三 文件操作(一)
文件读写 r,只读模式(默认). w,只写模式.[不可读:不存在则创建:存在则删除内容:] a,追加模式.[不可读: 不存在则创建:存在则只追加内容:] r+,[可读.可写:可追加,如果打开的文件不存 ...
- deno学习三 官方提供的方便deno 安装方式
早起deno 使用了golang 开发,同时需要protobuf 进行数据的序列化以及反序列化处理 当前的deno 已经使用rust 进行了开发,同时官方提供的安装方式也很方便了,不需要 那么复杂的编 ...
- hadoop学习(五)----HDFS的java操作
前面我们基本学习了HDFS的原理,hadoop环境的搭建,下面开始正式的实践,语言以java为主.这一节来看一下HDFS的java操作. 1 环境准备 上一篇说了windows下搭建hadoop环境, ...
- 大数据技术之_19_Spark学习_05_Spark GraphX 应用解析 + Spark GraphX 概述、解析 + 计算模式 + Pregel API + 图算法参考代码 + PageRank 实例
第1章 Spark GraphX 概述1.1 什么是 Spark GraphX1.2 弹性分布式属性图1.3 运行图计算程序第2章 Spark GraphX 解析2.1 存储模式2.1.1 图存储模式 ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
- Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作
Spark-读写HBase,SparkStreaming操作,Spark的HBase相关操作 1.sparkstreaming实时写入Hbase(saveAsNewAPIHadoopDataset方法 ...
随机推荐
- Oracle Linux下安装Oracle11gR2
Linux上Oracle11g R2安装及配置 一. 安装环境准备 1. 环境说明 Linux服务器系统:Oracle Linux Release 6 Update 2 (64bit),先安装好. ...
- .NET Core MVC 静态文件应用
一.静态文件应用方面 ASP.NET Core 静态文件应用,主要分为两方面:网站访问和静态文件整合 二.案例 1.访问静态文件 我们都知道,在 ASP.NET 项目中,我们的静态文件一般要放在 ww ...
- jvm 内存结构
jvm 内存结构 graph TB A(jvm)-->E(类加载器系统) A-->B(运行时数据区) A-->D(本地库接口) A-->C(执行引擎) B-->虚拟机栈 ...
- Android中实现自定义View组件并使其能跟随鼠标移动
场景 实现效果如下 注: 博客: https://blog.csdn.net/badao_liumang_qizhi 关注公众号 霸道的程序猿 获取编程相关电子书.教程推送与免费下载. 实现 新建An ...
- docker笔记(2)
docker笔记(2) 常用命令和操作 1. 镜像操作 操作 命令 说明 检索 docker search 关键字 eg:docker search redis 我们经常去docker hub上检索镜 ...
- cf877D
题意简述:矩阵中有的点不能走,你每次可从四个方向走,至少走一步,最多走k步(不能横跨那些不能走的格子),问从(sx,sy)走到(tx,ty)的最短时间是多少? 题意:利用set来加速bfs的过程,原理 ...
- fatal: HttpRequestException encountered
报错:fatal: HttpRequestException encountered 解决方法 Github 禁用了TLS v1.0 and v1.1,必须更新Windows的git凭证管理器,才行. ...
- string_random
1.随机数 import random 0-1间的随机浮点数,random.random() 指定区间随机浮点数,random.uniform(a,b) 指定区间随机整数(闭区间),random.ra ...
- 全面了解Java中的15种锁概念及机制!
在读很多并发文章中,会提及各种各样锁如公平锁,乐观锁等等,这篇文章介绍各种锁的分类.介绍的内容如下: 1.公平锁 / 非公平锁 2.可重入锁 / 不可重入锁 3.独享锁 / 共享锁 4.互斥锁 / 读 ...
- cisco 路由器的操作系统基础命令集
路由器和交换机里都有操作系统,cisco的操作系统叫ios. 怪不得路由器贵,原来也是带操作系统的机器啊,以前真是小白. ios里的几种模式 1,>:用户模式:啥也干不了. 2,#:特权模式:用 ...