
Python实现DBSCAN聚类算法(简单样例测试)
发现高密度的核心样品并从中膨胀团簇。
Python代码如下:
 # -*- coding: utf-8 -*-

 """

 Demo of DBSCAN clustering algorithm

 Finds core samples of high density and expands clusters from them.

 """

 print(__doc__)

 # 引入相关包

 import numpy as np

 from sklearn.cluster import DBSCAN

 from sklearn import metrics

 from sklearn.datasets.samples_generator import make_blobs

 from sklearn.preprocessing import StandardScaler

 import matplotlib.pyplot as plt

 # 初始化样本数据

 centers = [[1, 1], [-1, -1], [1, -1]]

 X, labels_true = make_blobs(n_samples=750, centers=centers, cluster_std=0.4,

                             random_state=0)

 X = StandardScaler().fit_transform(X)

 # 计算DBSCAN

 db = DBSCAN(eps=0.3, min_samples=10).fit(X)

 core_samples_mask = np.zeros_like(db.labels_, dtype=bool)

 core_samples_mask[db.core_sample_indices_] = True

 labels = db.labels_

 # 聚类的结果

 n_clusters_ = len(set(labels)) - (1 if -1 in labels else 0)

 n_noise_ = list(labels).count(-1)

 print('Estimated number of clusters: %d' % n_clusters_)

 print('Estimated number of noise points: %d' % n_noise_)

 print("Homogeneity: %0.3f" % metrics.homogeneity_score(labels_true, labels))

 print("Completeness: %0.3f" % metrics.completeness_score(labels_true, labels))

 print("V-measure: %0.3f" % metrics.v_measure_score(labels_true, labels))

 print("Adjusted Rand Index: %0.3f"

       % metrics.adjusted_rand_score(labels_true, labels))

 print("Adjusted Mutual Information: %0.3f"

       % metrics.adjusted_mutual_info_score(labels_true, labels,

                                            average_method='arithmetic'))

 print("Silhouette Coefficient: %0.3f"

       % metrics.silhouette_score(X, labels))

 # 绘出结果

 unique_labels = set(labels)

 colors = [plt.cm.Spectral(each)

           for each in np.linspace(0, 1, len(unique_labels))]

 for k, col in zip(unique_labels, colors):

     if k == -1:

         col = [0, 0, 0, 1]

     class_member_mask = (labels == k)

     xy = X[class_member_mask & core_samples_mask]

     plt.plot(xy[:, 0], xy[:, 1], 'o', markerfacecolor=tuple(col),

              markeredgecolor='k', markersize=14)

     xy = X[class_member_mask & ~core_samples_mask]

     plt.plot(xy[:, 0], xy[:, 1], 'o', markerfacecolor=tuple(col),

              markeredgecolor='k', markersize=6)

 plt.title('Estimated number of clusters: %d' % n_clusters_)

 plt.show()
测试结果如下:
最终结果绘图:
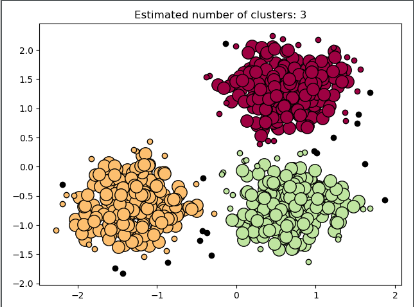
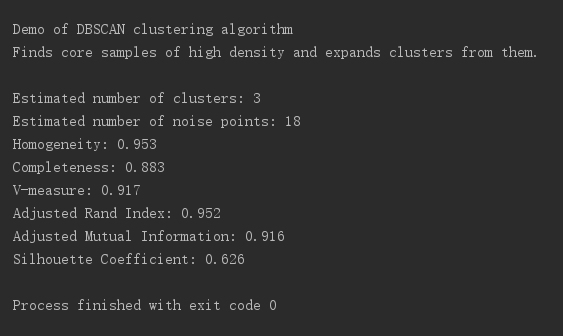
具体数据:
Python实现DBSCAN聚类算法(简单样例测试)的更多相关文章
- extern外部方法使用C#简单样例
外部方法使用C#简单样例 1.添加引用using System.Runtime.InteropServices; 2.声明和实现的连接[DllImport("kernel32", ...
- spring事务详解(二)简单样例
系列目录 spring事务详解(一)初探事务 spring事务详解(二)简单样例 spring事务详解(三)源码详解 spring事务详解(四)测试验证 spring事务详解(五)总结提高 一.引子 ...
- 机器学习入门-DBSCAN聚类算法
DBSCAN 聚类算法又称为密度聚类,是一种不断发张下线而不断扩张的算法,主要的参数是半径r和k值 DBSCAN的几个概念: 核心对象:某个点的密度达到算法设定的阈值则其为核心点,核心点的意思就是一个 ...
- Python实现 K_Means聚类算法
使用 Python实现 K_Means聚类算法: 问题定义 聚类问题是数据挖掘的基本问题,它的本质是将n个数据对象划分为 k个聚类,以便使得所获得的聚类满足以下条件: 同一聚类中的数据对象相似度较高 ...
- velocity简单样例
velocity简单样例整体实现须要三个步骤,详细例如以下: 1.创建一个Javaproject 2.导入须要的jar包 3.创建须要的文件 ============================= ...
- 自己定义隐式转换和显式转换c#简单样例
自己定义隐式转换和显式转换c#简单样例 (出自朱朱家园http://blog.csdn.net/zhgl7688) 样例:对用户user中,usernamefirst name和last name进行 ...
- Kafka在Linux上安装部署及样例测试
Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了普通消息系统的功能,但具有自己独特的设计.这个独特的设计是什么样的呢 介绍 Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了 ...
- gtk+3.0的环境配置及基于gtk+3.0的python简单样例
/********************************************************************* * Author : Samson * Date ...
- 5.无监督学习-DBSCAN聚类算法及应用
DBSCAN方法及应用 1.DBSCAN密度聚类简介 DBSCAN 算法是一种基于密度的聚类算法: 1.聚类的时候不需要预先指定簇的个数 2.最终的簇的个数不确定DBSCAN算法将数据点分为三类: 1 ...
随机推荐
- K8S 容器挂载Windows 文件共享目录,访问出现Permission denied的解决办法
K8S Pod,Docker 容器挂载Windows主机目录,访问相应的文件出现Premission denied的权限访问问题 Windows远程共享目录为//192.168.61.115/huas ...
- ASPNetCore 发布到IIS
ASPNetCore 发布到IIS 准备工作 1.1. 安装IIS.(具体操作不再说明) 安装成功后再浏览器输入localhost得到的页面如下 1.2. 安装dotnet-hosting-2.2 ...
- mysql 使用 limit ,从指定条数读取完,-1失效
, 原因很简单这种写法本身就是错的,虽然它可以在之前的版本中运行(低优先级),新版本的mysql对此做出了修复,现在的替代方法是第二个参数用一个较大的正数代替 比如你写个 , 感觉这方法很蠢,然鹅我并 ...
- url相对路径变成绝对路径
var eleLink = document.createElement('a'); eleLink.href = "/wordpress/?p=9227"; console.lo ...
- 【干货】Python基础——列表
1.列表的创建 列表是多个.有序.可重复的元素集合,数据包装在“[]”里,列表中的元素可以是任何类型,甚至可以是一个列表.创建列表有两种方法: A 对于规模比较小的列表可以直接定义和赋值,列表可以嵌套 ...
- 聊聊spring之贯穿全局的重要对象BeanDefinition
BeanDefinition 在 spring 中贯穿始终,spring 要根据 BeanDefinition 对象来实 例化 bean,只要把解析的标签,扫描的注解类封装成 BeanDefiniti ...
- css3基础-选择器+边框与圆角+背景与渐变
Css3选择器相关: section > div直接子元素选择器 div + article相邻兄弟选择器(在元素之后出现) div ~ article通用兄弟选择器(在元素之后出现) 属性选择 ...
- jQuery---jQuery插件
jQuery插件 使用插件的步骤 1. 引入jQuery文件 2. 引入插件(如果有用到css的话,需要引入css) 3. 使用插件 <!--1. 引入jquery的js文件--> < ...
- Auto-Encoder(自编码器)原理
1.无监督学习 无监督学习和监督学习是机器学习的两个方向,监督学习主要适用于已经标注好的数据集(如mnist分类问题),无监督学习则是希望计算机完成复杂的标注任务,简单的解释就是——教机器自己学习,它 ...
- .net mvc 自定义错误页面
1.Global.asax.cs中,加入如下代码 protected void Application_Error(Object sender, EventArgs e) { Exception ex ...