
mds的cpu占用问题分析以及解决办法
前言
mds是ceph里面处理文件接口的组件,一旦使用文件系统,不可避免的会出现一种场景就是目录很多,目录里面的文件很多,而mds是一个单进程的组件,现在虽然有了muti mds,但稳定的使用的大部分场景还是单acitve mds的
这就会出现一种情况,一旦一个目录里面有很多文件的时候,去查询这个目录里的文件就会在当前目录做一次遍历,这个需要一个比较长的时间,如果能比较好的缓存文件信息,也能避免一些过载情况,本篇讲述的是内核客户端正常,而export nfs后mds的负载长时间过高的情况
问题复现
准备测试数据,准备好监控环境
监控mds cpu占用
pidstat -u  1 -p 27076 > /tmp/mds.cpu.log

UserParameter=mds.cpu,cat /tmp/mds.cpu.log|tail -n 1|grep -v Average| awk '{print $8}'
整个测试避免屏幕的打印影响时间统计,把输出需要重定向
测试一:
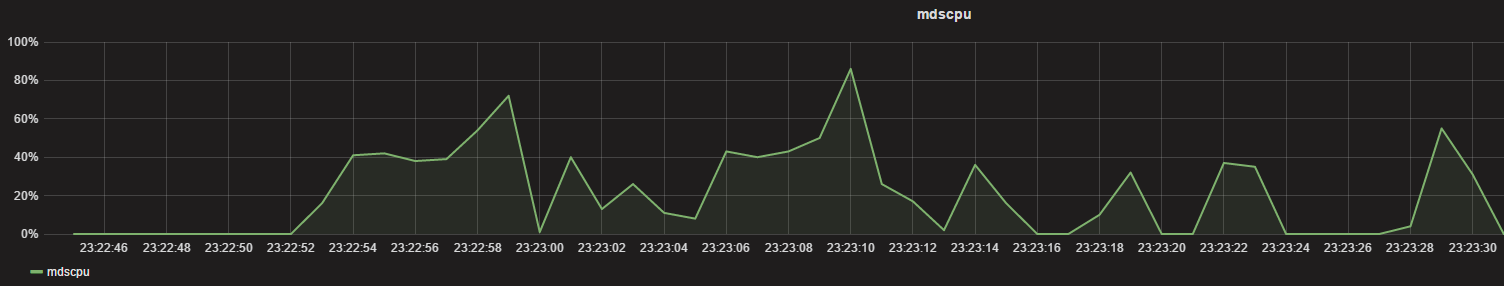
内核客户端写入10000文件查看时间以及cpu占用
[root@nfsserver kc10000]# time seq 10000|xargs -i dd if=/dev/zero of=a{} bs=1K count=1  2>/dev/null

real	0m30.121s

user	0m1.901s

sys	0m10.420s
测试二:
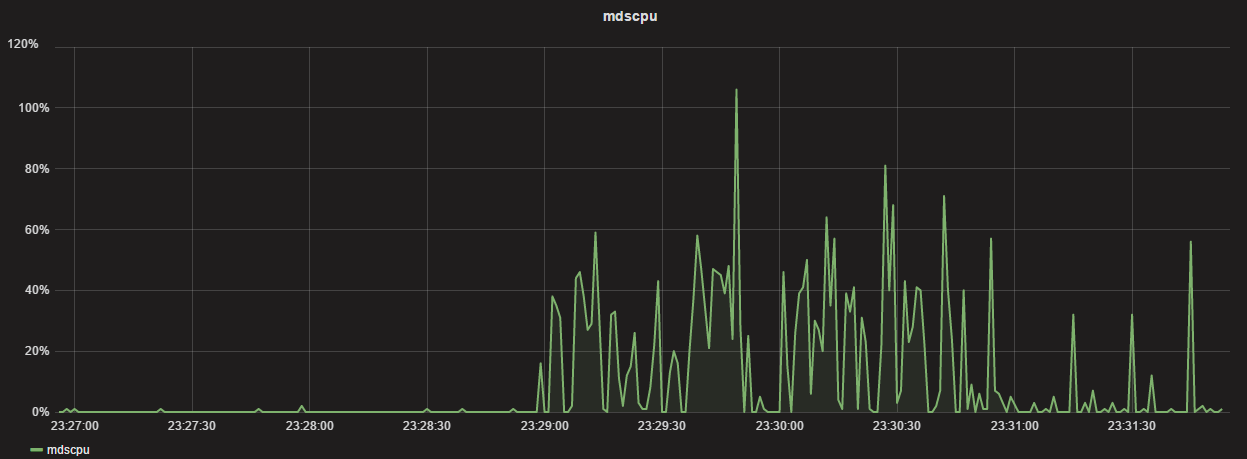
内核客户端写入20000文件查看时间以及cpu占用
[root@nfsserver kc20000]# time seq 20000|xargs -i dd if=/dev/zero of=a{} bs=1K count=1  2>/dev/null

real	1m38.233s

user	0m3.761s

sys	0m21.510s
测试三:
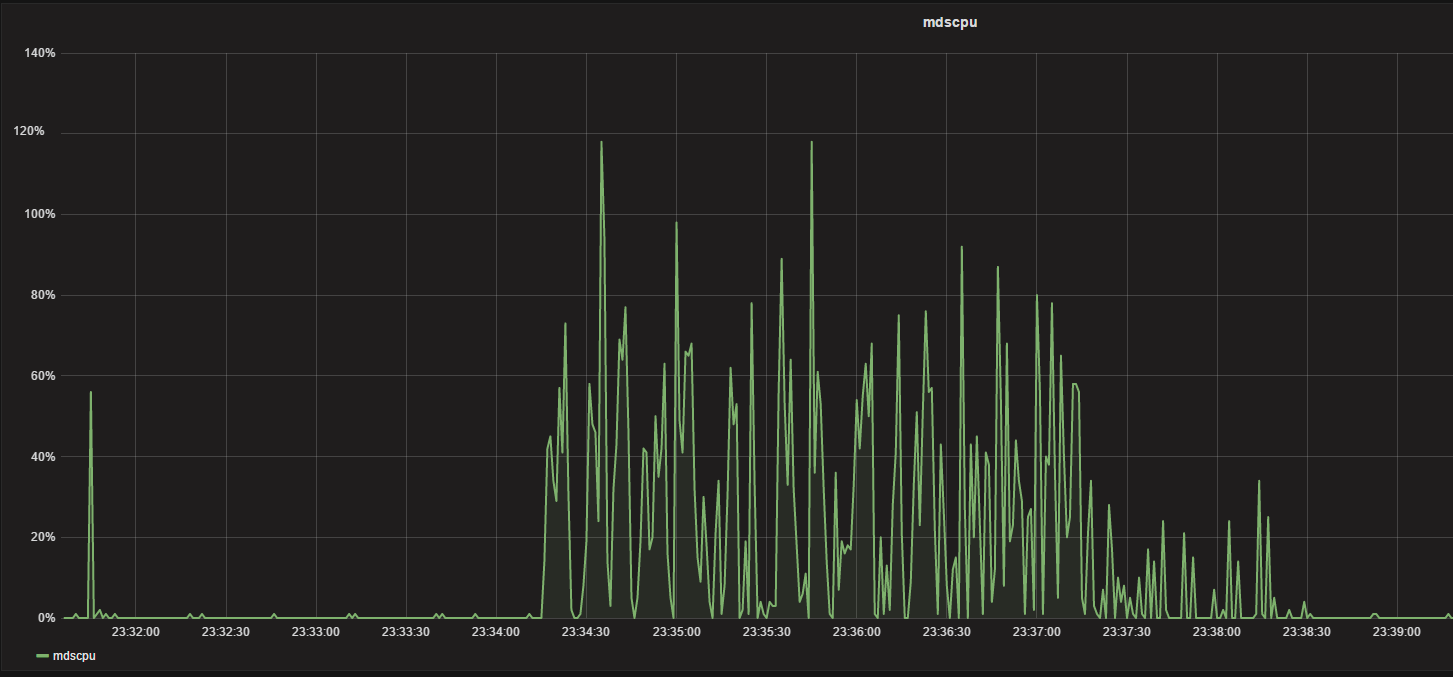
内核客户端写入40000文件查看时间以及cpu占用
[root@nfsserver kc40000]#  time seq 40000|xargs -i dd if=/dev/zero of=a{} bs=1K count=1  2>/dev/null

real	2m55.261s

user	0m7.699s

sys	0m42.410s
测试4:
内核客户端列目录10000文件,第一次写完有缓存情况
[root@nfsserver kc10000]# time ll 2>&1 > /dev/null

real	0m0.228s

user	0m0.063s

sys	0m0.048s
内核客户端列目录20000文件,第一次写完有缓存情况
[root@nfsserver kc20000]# time ll 2>&1 > /dev/null

real	0m0.737s

user	0m0.141s

sys	0m0.092s
内核客户端列目录40000文件,第一次写完有缓存情况
[root@nfsserver kc40000]# time ll 2>&1 > /dev/null

real	0m1.658s

user	0m0.286s

sys	0m0.196s
都是比较快的返回,CPU可以忽略不计
现在重启mds后再次列目录
客户端如果不umount,直接重启mds的话,还是会缓存在
新版本这个地方好像已经改了(重启了mds 显示inode还在,但是随着时间的增长inode会减少,说明还是有周期,会释放,这个还不知道哪个地方控制,用什么参数控制,这个不是本篇着重关注的地方,后续再看下,jewel版本已经比hammer版本的元数据时间快了很多了)
[root@nfsserver kc10000]# time ll 2>&1 > /dev/null

real	0m0.380s

user	0m0.065s

sys	0m0.041s

[root@nfsserver kc10000]# cd ../kc20000/

[root@nfsserver kc20000]# time ll 2>&1 > /dev/null

real	0m0.868s

user	0m0.154s

sys	0m0.074s

[root@nfsserver kc20000]# cd ../kc40000/

[root@nfsserver kc40000]# time ll 2>&1 > /dev/null

real	0m1.947s

user	0m0.300s

sys	0m0.166s
测试都是看到很快的返回,以上都是正常的,下面开始将这个目录exportnfs出去,看下是个什么情况
负载问题复现
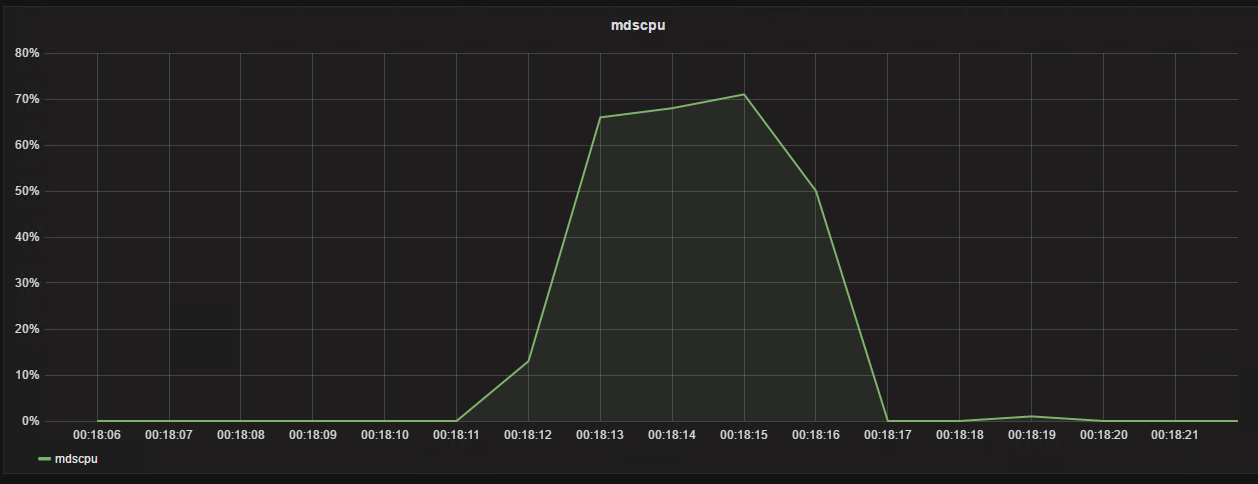
从nfs客户端第一次列10000个小文件的目录
[root@nfsclient kc10000]# time ll 2>&1 > /dev/null

real	0m4.038s

user	0m0.095s

sys	0m0.069s
从nfs客户端第一次列20000个小文件的目录
[root@nfsclient kc20000]# time ll 2>&1 > /dev/null

real	0m17.446s

user	0m0.175s

sys	0m0.141s
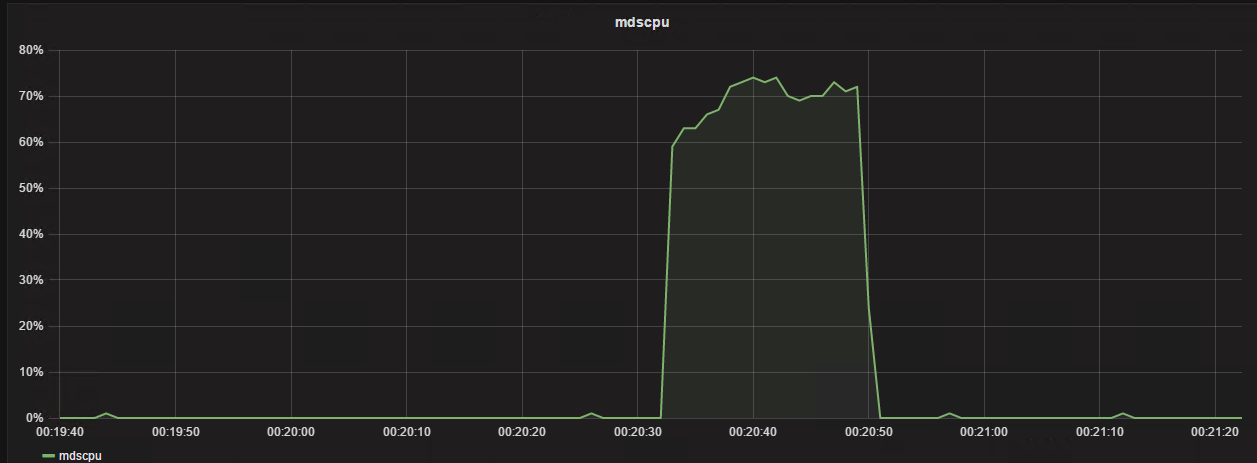
从nfs客户端第二次列20000个小文件目录
[root@nfsclient kc20000]# time ll 2>&1 > /dev/null

real	0m21.215s

user	0m0.182s

sys	0m0.151s
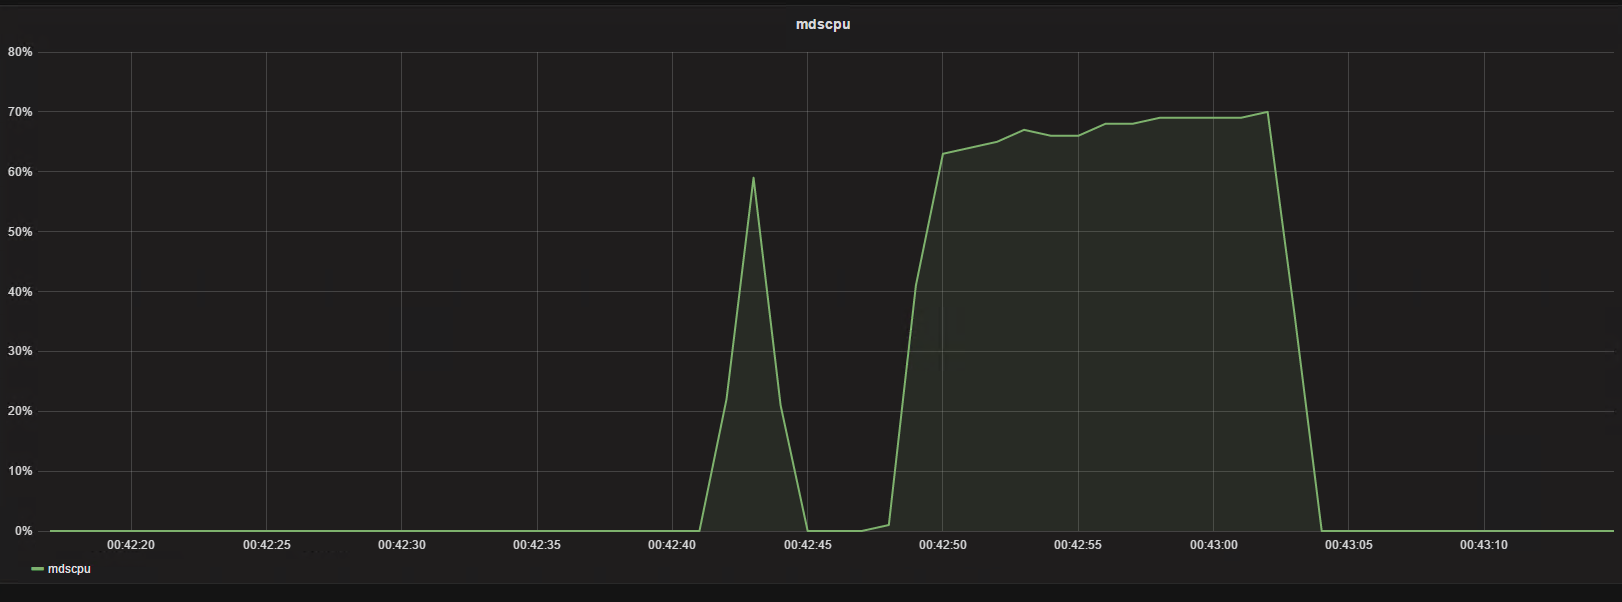
从nfs客户端第三次列20000个小文件目录
[root@nfsclient kc20000]# time ll 2>&1 > /dev/null

real	0m16.222s

user	0m0.189s

sys	0m0.143s
可以看到在20000量级的时候列目录维持在20000左右,CPU维持一个高位
从nfs客户端列40000个小文件的目录
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	7m15.663s

user	0m0.319s

sys	0m0.581s

[root@nfsclient kc40000]#
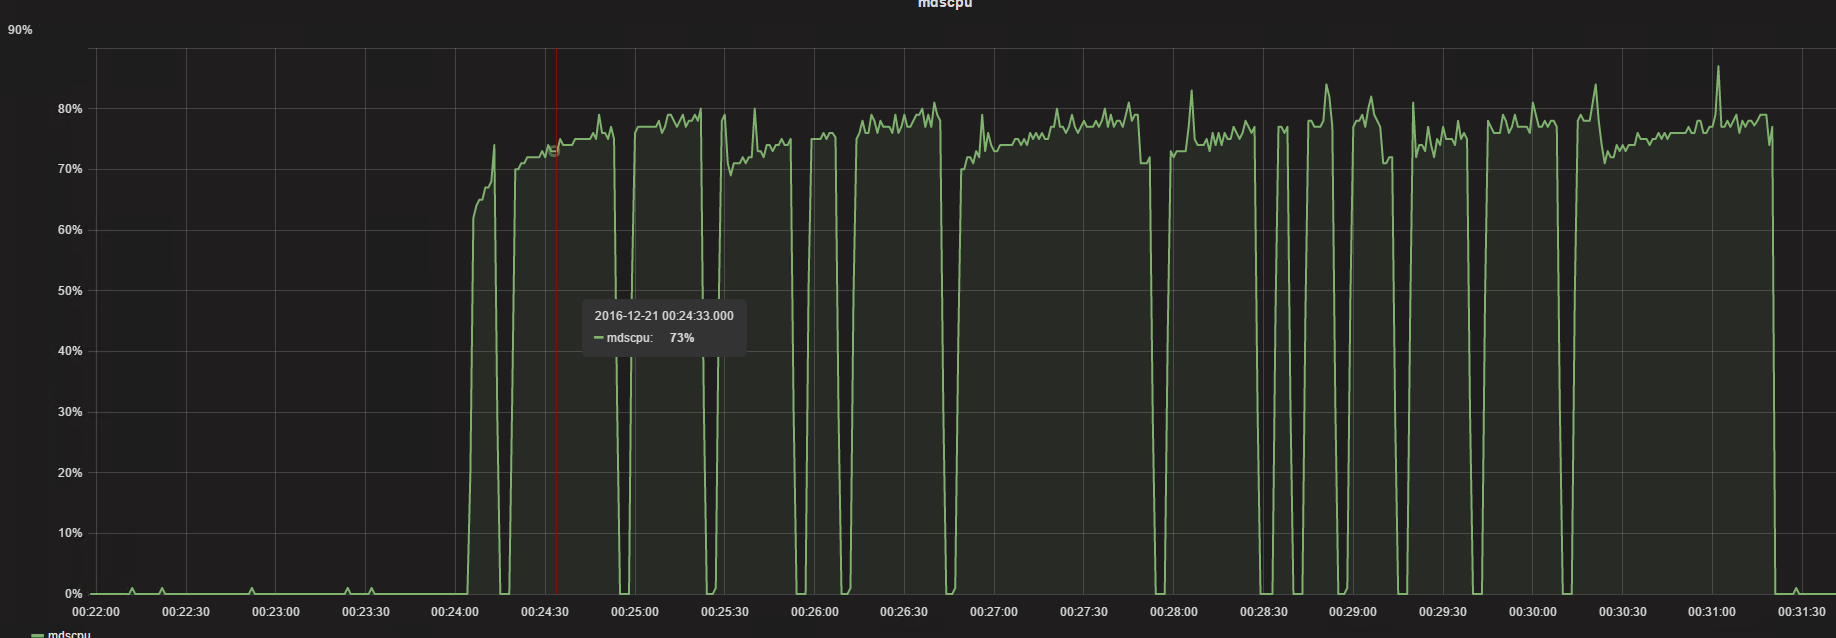
第一次列完,马上第二次列看下情况
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	1m12.816s

user	0m0.163s

sys	0m0.142s
可以看到第二次列的时间已经缩短了,再来第三次
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	1m33.549s

user	0m0.162s

sys	0m0.183s
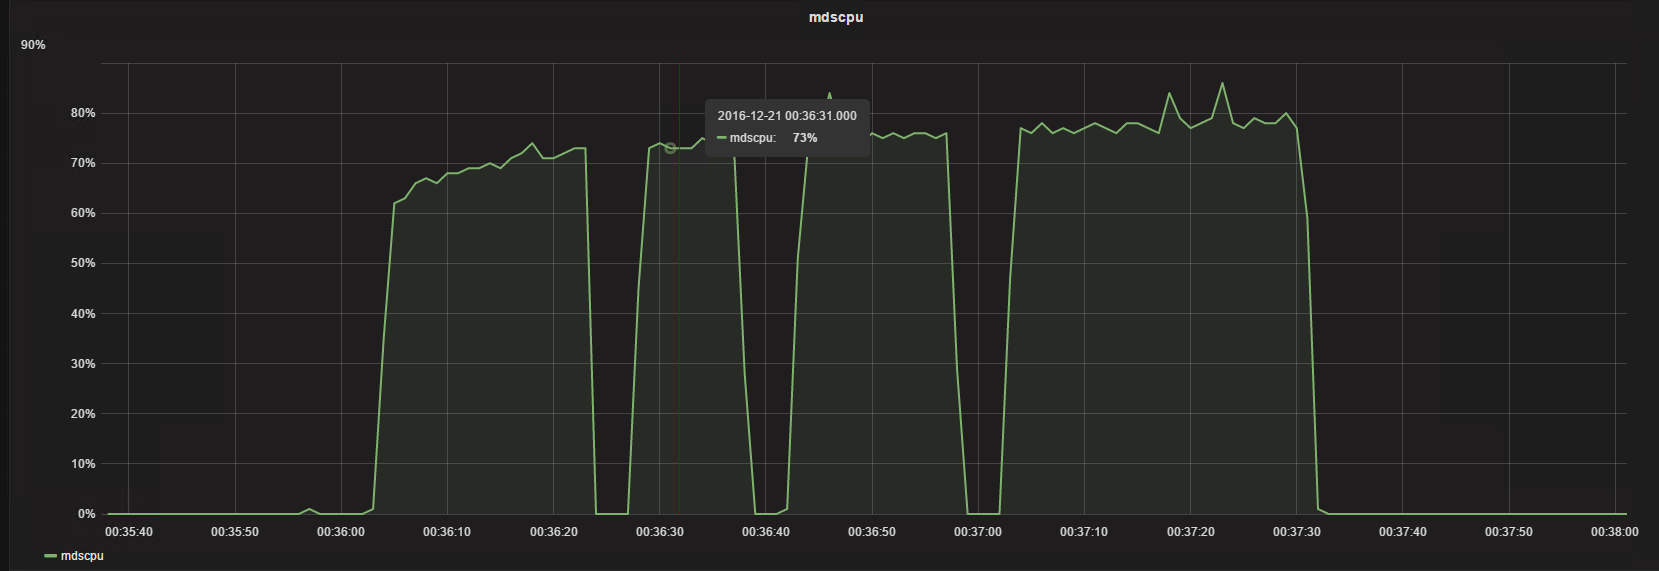
可以看到在后面列的时候时间确实缩短了,但是还是维持一个非常高CPU的占用,以及比较长的一个时间,这个很容易造成过载
这个地方目前看应该是内核客户端与内核NFS的结合的问题
解决办法:用ganesha的ceph用户态接口替代kernel nfs
我们看下另外一种方案用户态的NFS+ceph同样的环境下测试结果:
从nfs客户端第一次列40000个小文件的目录
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	0m3.289s

user	0m0.335s

sys	0m0.386s
从nfs客户端第二次列40000个小文件的目录
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	0m1.686s

user	0m0.351s

sys	0m0.389s
从nfs客户端第三次列40000个小文件的目录
[root@nfsclient kc40000]# time ll 2>&1 > /dev/null

real	0m1.675s

user	0m0.320s

sys	0m0.391s
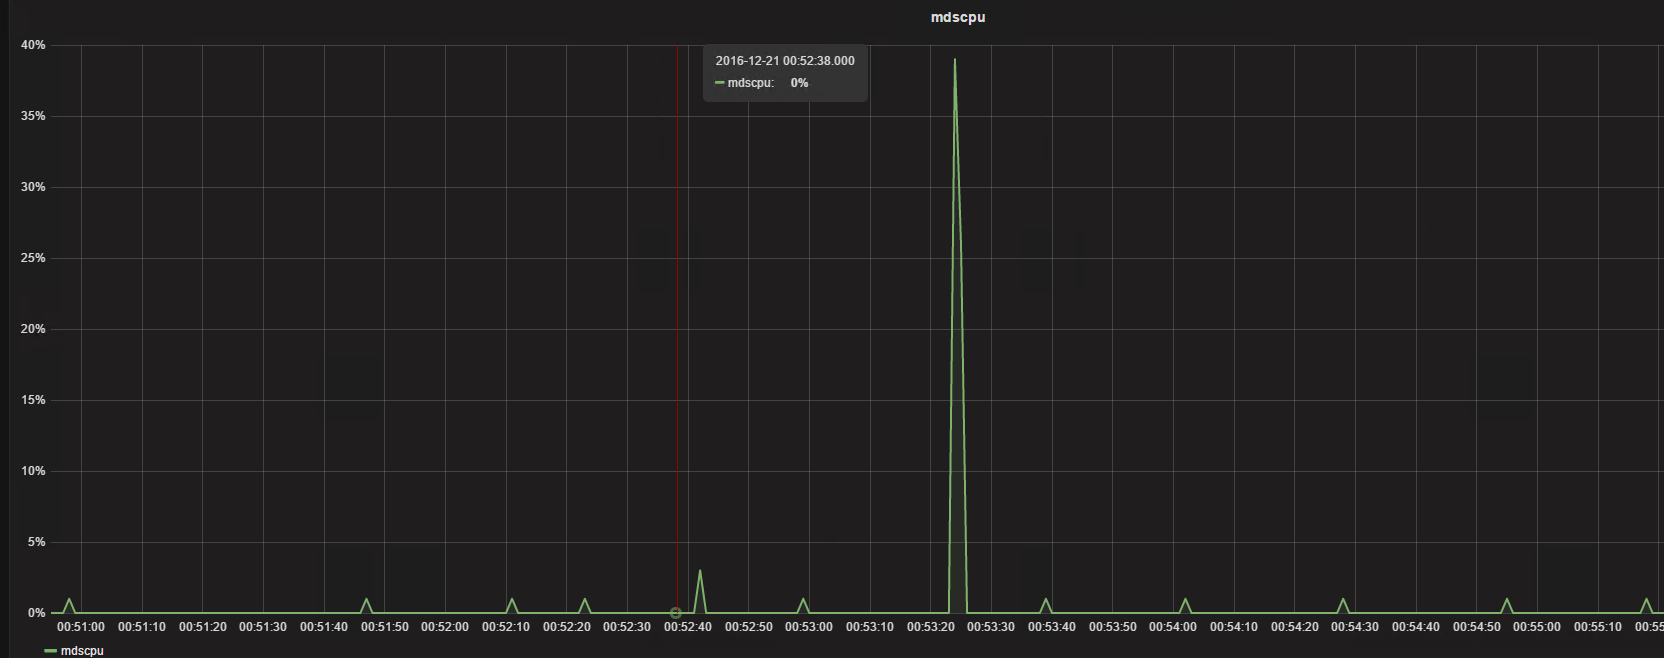
基本mds无多余的负载,非常快的返回
可以从上面的测试看到差别是非常的大的,这个地方应该是内核模块与内核之间的问题,而采用用户态的以后解决了列目录慢以及卡顿的问题
如何配置ganesha支持ceph的nfs接口
git clone -b V2.3-stable https://github.com/nfs-ganesha/nfs-ganesha.git

cd nfs-ganesha/

git submodule update --init --recursive

cd ..

cd nfs-ganesha/

ll src/FSAL/FSAL_CEPH/

cd ..

mkdir mybuild

cd mybuild/

cmake -DUSE_FSAL_CEPH=ON ../nfs-ganesha/src/

ll FSAL/FSAL_CEPH/

make

make -j 12

make install
vim /etc/ganesha/ganesha.conf
修改配置文件
EXPORT

{

    Export_ID=1;

    Path = "/";

    Pseudo = "/";

    Access_Type = RW;

    NFS_Protocols = 4;

    Transport_Protocols = TCP;

    FSAL {

        Name = CEPH;

    }

}
停止掉原生的nfs
systemctl stop nfs
启用ganesha nfs
systemctl start nfs-ganesha.service
然后在客户端进行nfs的挂载即可
总结
ganesha在需要用到cephfs又正好是要用到nfs接口的时候,可以考虑这个方案,至少在缓存文件,降低负载上面能够比kernel client有更好的效果,这个可以根据测试情况用数据来做比较
变更记录
| Why | Who | When |
|---|---|---|
| 创建 | 武汉-运维-磨渣 | 2017-12-04 |
/assets/images/blogimg/mds-use-too-more-cpu/

mds的cpu占用问题分析以及解决办法的更多相关文章
- JavaScript中的ParseInt("08")和“09”返回0的原因分析及解决办法
今天在程序中出现一个bugger ,调试了好久,最后才发现,原来是这个问题. 做了一个实验: alert(parseInt("01")),当这个里面的值为01====>07时 ...
- php中session_start()相关问题分析与解决办法
介绍下,在php中使用session时遇到的一些问题,与相关解决方法.1.错误提示Warning: Cannot send session cookie - headers already sentW ...
- oracle执行update语句时卡住问题分析及解决办法
转载:http://www.jb51.net/article/125754.htm 这篇文章主要介绍了oracle执行update语句时卡住问题分析及解决办法,涉及记录锁等相关知识,具有一定参考价值, ...
- Juniper SRX550防火墙web页面CPU达到100%的故障解决办法
Juniper SRX550防火墙web页面CPU达到100%的故障解决办法 利用telnet远程连接主机,对web页面注销重新登录即可,在配置中输入命令:run restart web-manage ...
- selenium元素定位不到问题分析及解决办法
最近正在学习写自动化测试脚本,遇到一个错误迟迟未解决,导致自信心大受挫败,甚至想放弃. 思考许久突然想到,我遇到的问题是否也有人会遇到,如果有的话问题就应该有解决办法了.没什么问题是百度解决不了的,如 ...
- 服务器CPU使用率高的原因分析与解决办法
我们的服务器在使用操作系统的时候,用着用着系统就变慢了,打开“ 任务管理器 ”一看,才发现CPU使用率达到80%以上.这是怎么回事情呢?遇到病毒了吗?硬件有问题?还是系统设置有问题呢?在本文中将从硬件 ...
- HashMap-死锁导致cpu占用100%分析(转)
最近项目里面的一段千年代码出了问题,这个问题以前也出现过,不过不是那么明显,这次迁移机器由以前的4台机子变成2台以后问题被放大,最终不得不解决,特此分析一下. 先放出问题的代码 ? 1 2 3 4 5 ...
- Nested Loops join时显示no join predicate原因分析以及解决办法
本文出处:http://www.cnblogs.com/wy123/p/6238844.html 最近遇到一个存储过程在某些特殊的情况下,效率极其低效, 至于底下到什么程度我现在都没有一个确切的数据, ...
- 80端口未占用,apache无法启动解决办法
网上很多关于apache无法启动的原因,新手遇到最多的是80端口被占用. 今天为了解决apache和tomcat端口共存问题,修改了httpd.conf的配置,由于增加位置没有做明显标识,重启apac ...
随机推荐
- C++11随机数库
random随机数库 C++11引入了新的随机数生成机制,那就是<random>随机数库,支持多种伪随机数生成算法,多种连续和离散随机数分布算法,以及封装了真正的随机数生成引擎random ...
- spring boot:用spring security加强druid的安全(druid 1.1.22 / spring boot 2.3.3)
一,druid的安全保障有哪些环节要注意? 1,druid ui的访问要有ip地址限制 2,用户必须要有相应的权限才能访问druid 3,关闭重置功能 说明:stat-view-servlet.url ...
- spring boot:配置shardingsphere(sharding jdbc)使用druid数据源(druid 1.1.23 / sharding-jdbc 4.1.1 / mybatis / spring boot 2.3.3)
一,为什么要使用druid数据源? 1,druid的优点 Druid是阿里巴巴开发的号称为监控而生的数据库连接池 它的优点包括: 可以监控数据库访问性能 SQL执行日志 SQL防火墙 但spring ...
- spring boot:用itextpdf处理pdf表格文件(spring boot 2.3.2)
一,什么是itextpdf? 1,itextpdf的用途 itextpdf是用来生成PDF文档的一个java类库, 通过iText可以生成PDF文档, 还可以把XML/Html文件转化为PDF文件 2 ...
- 性能测试之JVM的故障排查-堆内存泄漏
JVM异常说明(超链接) 一文中已介绍了,JVM每个运行时区域--程序计数器 .Java虚拟机栈.本地方法栈.Java堆.方法区.直接内存发生OutOfMemoryError的不同原因和不同错误信息. ...
- mysql 必会基础1
1.cmd --> 开启服务:net start mysql 关闭服务:net stop mysql 没有restart命令;命令格式:net stop serviceName;后面不需要加分号 ...
- RAM ROM区别记忆
我老是忘这个 1.概念 RAM即随机存储内存,这种存储器在断电时将丢失其存储内容,故主要用于存储短时间使用的程序.ROM即只读内存,是一种只能读出事先所存数据的固态半导体存储器. 2.对比 手机中的R ...
- confluence 4.2 升级至 6.10.x 记录
confluence 4.2 升级至 6.10.x 记录 首先将线上环境中的 confluence 安装目录.数据目录以及数据库进行备份,相关信息如下: 安装目录:/opt/atlassian/con ...
- WrapperClass
* 测试包装类的基本用法: * 包装类就是把基本属性也变成对象,方便有时候用: * 八种基本属性,其他类型类似于integer,除了int-integer和char-character:其他都是原样: ...
- mq_open失败,Invalid argument
经四处查找,终于发现原因: (1)attr.mq_maxmsg 不能超过文件 /proc/sys/fs/mqueue/msg_max 中的数值,我的机器上面是10. (2)attr.mq_msgsiz ...