
使用HttpWebRequest和HtmlAgilityPack抓取网页(拒绝乱码,拒绝正则表达式)
废话不多说, 直接说需求。
公司的网站需要抓取其他网站的文章,但任务没到我这,同事搞了一下午没搞出来。由于刚刚到公司, 想证明下自己,就把活揽过来了。因为以前做过,觉得应该很简单,但当我开始做的时候,我崩溃了,http请求后,得到的是字符串竟然是乱码,然后就各种百度(谷歌一直崩溃中),最后找到了原因。由于我要抓取的网页做了压缩,所以当我抓的时候,抓过来的是压缩后的,所以必须解压一下,如果不解压,不管用什么编码方式,结果还是乱码。直接上代码:
1 public Encoding GetEncoding(string CharacterSet)

2         {

3             switch (CharacterSet)

4             {

5                 case "gb2312": return Encoding.GetEncoding("gb2312");

6                 case "utf-8": return Encoding.UTF8;

7                 default: return Encoding.Default;

8             }

9         }
  public string HttpGet(string url)

        {

            string responsestr = "";

            HttpWebRequest req = HttpWebRequest.Create(url) as HttpWebRequest;

            req.Accept = "*/*";

            req.Method = "GET";

            req.UserAgent = "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/21.0.1180.89 Safari/537.1";

            using (HttpWebResponse response = req.GetResponse() as HttpWebResponse)

            {

                Stream stream;

                if (response.ContentEncoding.ToLower().Contains("gzip"))

                {

                    stream = new GZipStream(response.GetResponseStream(), CompressionMode.Decompress);

                }

                else if (response.ContentEncoding.ToLower().Contains("deflate"))

                {

                    stream = new DeflateStream(response.GetResponseStream(), CompressionMode.Decompress);

                }

                else

                {

                    stream = response.GetResponseStream();

                }

                using (StreamReader reader = new StreamReader(stream, GetEncoding(response.CharacterSet)))

                {

                    responsestr = reader.ReadToEnd();

                    stream.Dispose();

                }

            }

            return responsestr;

        }
调用HttpGet就可以获取网址的源码了,得到源码后, 现在用一个利器HtmlAgility来解析html了,不会正则不要紧,此乃神器啊。老板再也不用担心我的正则表达式了。
至于这个神器的用法,园子文章很多,写的也都挺详细的,在此不赘余了。
下面是抓取园子首页的文章列表:
 string html = HttpGet("http://www.cnblogs.com/");

            HtmlDocument doc = new HtmlDocument();

            doc.LoadHtml(html);

            //获取文章列表

            var artlist = doc.DocumentNode.SelectNodes("//div[@class='post_item']");

            foreach (var item in artlist)

            {

                HtmlDocument adoc = new HtmlDocument();

                adoc.LoadHtml(item.InnerHtml);

                var html_a = adoc.DocumentNode.SelectSingleNode("//a[@class='titlelnk']");

                Response.Write(string.Format("标题为:{0},链接为:{1}<br>",html_a.InnerText,html_a.Attributes["href"].Value));

            }
运行结果如图: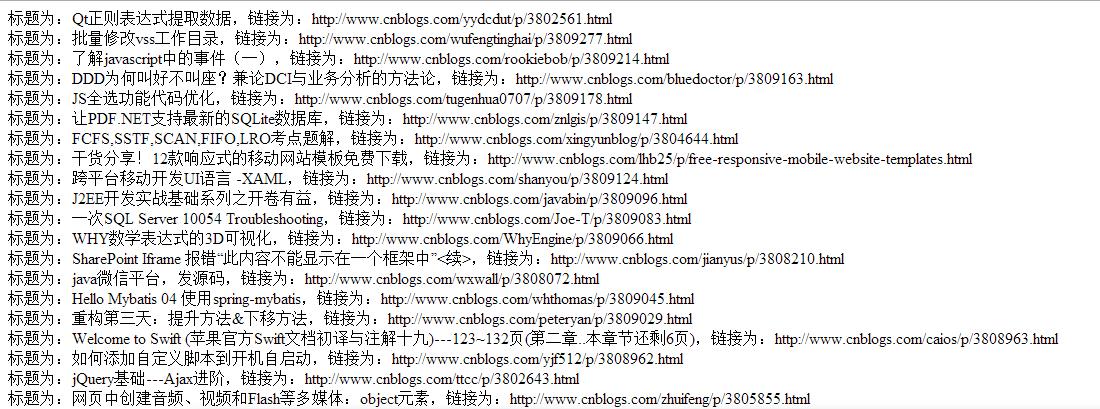
打完收工。
由于时间仓促,加上本人文笔不行,如有疑问,欢迎吐槽,吐吐更健康。
使用HttpWebRequest和HtmlAgilityPack抓取网页(拒绝乱码,拒绝正则表达式)的更多相关文章
- HtmlAgilityPack 抓取页面的乱码处理
HtmlAgilityPack 抓取页面的乱码处理 用来解析 HTML 确实方便.不过直接读取网页时会出现乱码. 实际上,它是能正确读到有关字符集的信息,怎么会在输出时,没有取到正确内容. 因此,读两 ...
- 使用HtmlAgilityPack抓取网页数据
XPath 使用路径表达式来选取 XML 文档中的节点或节点集.节点是通过沿着路径 (path) 或者步 (steps) 来选取的. 下面列出了最有用的路径表达式: nodename:选取此节点的所有 ...
- C# 使用HtmlAgilityPack抓取网页信息
前几天看到一篇博文:C# 爬虫 抓取小说 博主使用的是正则表达式获取小说的名字.目录以及内容. 下面使用HtmlAgilityPack来改写原博主的代码 在使用HtmlAgilityPack之前,可以 ...
- NET 使用HtmlAgilityPack抓取网页数据
刚刚学习了XPath路径表达式,主要是对XML文档中的节点进行搜索,通过XPath表达式可以对XML文档中的节点位置进行快速定位和访问,html也是也是一种类似于xml的标记语言,但是语法没有那么严谨 ...
- 【.NET】使用HtmlAgilityPack抓取网页数据
刚刚学习了XPath路径表达式,主要是对XML文档中的节点进行搜索,通过XPath表达式可以对XML文档中的节点位置进行快速定位和访问,html也是也是一种类似于xml的标记语言,但是语法没有那么 ...
- 解决PHP中file_get_contents抓取网页中文乱码问题
根据网上有朋友介绍说原因可能是服务器开了GZIP压缩. 下面是用firebug查看我的博客的头信息,Gzip是开了的. 请求头信息原始头信息 代码如下 复制代码 Accept text/html,ap ...
- Jumony快速抓取网页 --- Jumony使用笔记--icode
作者:郝喜路 个人主页:http://www.cnicode.com 博客地址:http://haoxilu.cnblogs.com 时间:2014年6月26日 19:25:02 ...
- Jumony快速抓取网页
Jumony快速抓取网页 --- Jumony使用笔记--icode 作者:郝喜路 个人主页:http://www.cnicode.com 博客地址:http://haoxilu.c ...
- 使用HtmlAgilityPack批量抓取网页数据
原文:使用HtmlAgilityPack批量抓取网页数据 相关软件点击下载登录的处理.因为有些网页数据需要登陆后才能提取.这里要使用ieHTTPHeaders来提取登录时的提交信息.抓取网页 Htm ...
随机推荐
- pentaho cde popup弹出框口
弹出窗口在pentaho cde里面相对比较容易,不过还是记录一下,以防时间久了,忘记关键参数. 先看一下效果图: 画出自己想要在弹出框展示的图形,把他的HtmlObject设置成弹出窗口,如图: 然 ...
- mysql-4 数据检索(2)
用通配符进行过滤 like操作符 %通配符 %可以匹配任意字符 SELECT prod_id , prod_name FROM products WHERE prod_name LIKE 'je ...
- SQL Server 2000:提示“未与信任SQL SERVER连接相关连”错误
在使用“用户模式”登陆SQL Server 2000时提示“未与信任SQL SERVER连接相关连”错误,因为在安装SQL Server时选择“仅Windows”模式,所以所有用户都不可以登陆. 解决 ...
- linux rpm 安装和卸载
[root@wang Packages]# mount /dev/cdrom /mnt 挂载 [root@wang Packages]# rpm -ivh zip-3.0-1.el6.x86_64.r ...
- 解决Python2.7的UnicodeEncodeError: 'ascii' codec can’t encode异常错误
import sys reload(sys) sys.setdefaultencoding('utf-8') 好了,通过上面短短的三行,我们算是很好的解决了这个问题了,同样的方式也可以应用到Unico ...
- 初涉Linux ----------> Ubuntu15.04的安装与美化
“你玩 Linux 吗?” “什么 Linux ?” “你连 Linux 都不知道?还说是学计算机的呢...” “干嘛要用 Linux 啊?windows多好,Linux?没兴趣” 一. 前言 ...
- java中的io系统详解 - ilibaba的专栏 - 博客频道 - CSDN.NET
java中的io系统详解 - ilibaba的专栏 - 博客频道 - CSDN.NET 亲,“社区之星”已经一周岁了! 社区福利快来领取免费参加MDCC大会机会哦 Tag功能介绍—我们 ...
- 【2016-10-14】【坚持学习】【Day5】【策略模式】
今天学了策略模式 例子 一个售票系统,针对不同的用户使用不用的计价方式, 环境类:一个业务场景(电影票累,) 抽象类:计价算法 具体实现类:5折算法,满100减20算法,..... 抽象策略类 abs ...
- (一)观察者模式-C++实现
观察者模式: 定义对象间的一种一对多的依赖关系,当一个对象的状态发生变化时,所有依赖它的对象都得到通知并被自动更新. 它有四种角色: 主题(Subject):一个接口,规定了具体主题需要实现的方法. ...
- HTML标签----图文详解
国庆节快乐,还在加班的童鞋,良辰必有重谢! 本文主要内容 头标签 排版标签:<p> <br> <hr> <center> ...