
python学习--第二天 爬取王者荣耀英雄皮肤
今天目的是爬取所有英雄皮肤
在爬取所有之前,先完成一张皮肤的爬取
打开anacond调出编译器Jupyter Notebook
打开王者荣耀官网
下拉找到位于网页右边的英雄/皮肤
点击【+更多】
进入英雄皮肤页面
按键盘F12调出网页代码
点击进入调出页的【Network】(这里是谷歌浏览器,其他浏览器可能显示为’网络‘)

刷新网页 重新接收所有网页数据(不要关闭调出的Network页)
刷新后在Network下会看到所有的数据重新加载处来
找到名为【herolist.json】的json文件(有两个随便选中一个就行
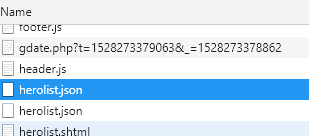
看右边会有这个文件的说明 复制这个json文件的URL地址:
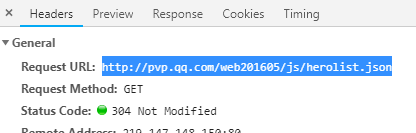
浏览器打开一个新窗口将地址粘贴进去,此时浏览器会自动下载【herolist.json】文件
在文件夹中能找到它
此时将程序写到这里
import urllib.request

import json

import os

v_herolist_url = urllib.request.urlopen('http://pvp.qq.com/web201605/js/herolist.json')

v_herolist = v_herolist_url.read()
当print(v_herolist)时,编译器底下会出现如下内容:
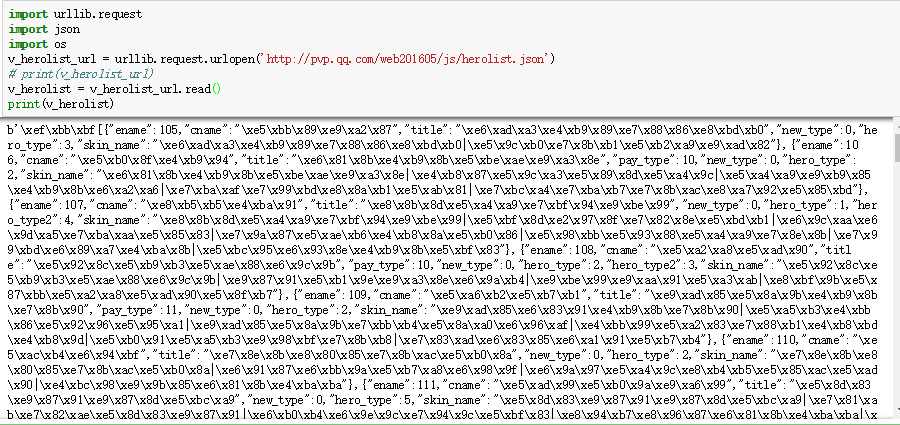
显示的\xe5\xbb这些是Unicode编码,要对它进行解码
v_herolist=v_herolist_url.read().decode('utf-8')
转换为json格式
hero_json=json.loads(v_herolist)
但此时输出的话会报错:
hero_json=json.loads(v_herolist)

print(hero_json)      #报错,自己百度
v_herolist=v_herolist.encode('utf8')[:].decode('utf-8')
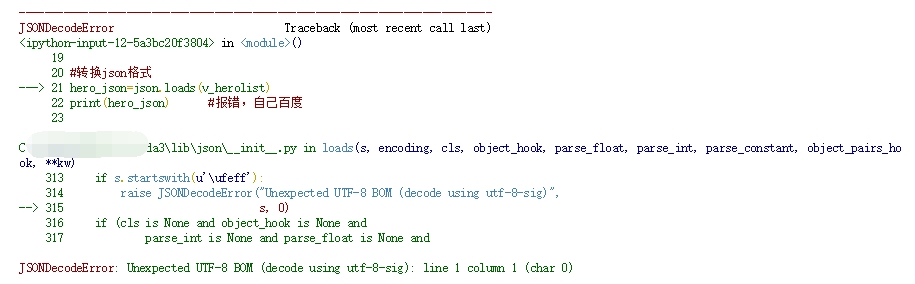
此时对其进行反编码并切掉python自动加入的编码方式声明’\xef\xbb\xbf‘
v_herolist=v_herolist.encode('utf8')[3:].decode('utf-8')

 hero_json=json.loads(v_herolist)

 print(hero_json)
爬取一张图片:
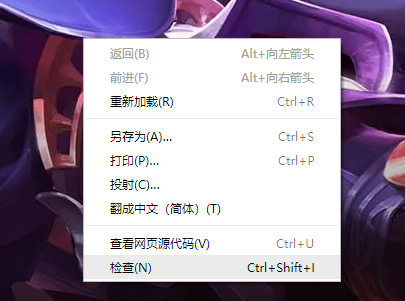
打开王者荣耀英雄/皮肤页面,随便选取一个英雄,在显示皮肤图片位置右击选中检查
在元素页面中会有图片的地址:
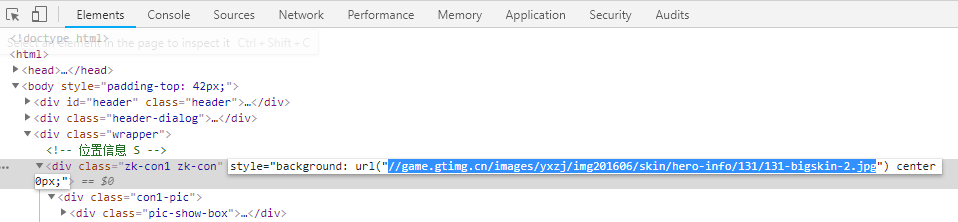
复制地址 并在首部加上 【http:】
创建本地文件夹存放图片
# 创建本地文件夹

hero_dir='D:\python practice\myhero\\'      #文件夹后面要加两个‘\\’!!

if not os.path.exists(hero_dir):           #如果不存在这个文件夹 自动创建

os.mkdir(hero_dir)
爬取这张皮肤图片
 skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/131/131-bigskin-2.jpg'

 hero_img = hero_dir+"aa.jpg"

 urllib.request.urlretrieve(skin_url,hero_img)         #这里只是爬取到了一张 如何爬取多张?
爬取成功:

完整程序代码:
#王者荣耀皮肤爬取

import urllib.request

import json

import os

#爬取皮肤的json文件

v_herolist_url=urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")

#请求

v_herolist=v_herolist_url.read().decode('utf-8')   #要进行python字符串切割

#解码

#截取

#\xef\xbb\xbf 是python自动加入的编码方式声明    可以用正则表达式

v_herolist=v_herolist.encode('utf8')[3:].decode('utf-8')

hero_json=json.loads(v_herolist)

# 创建本地文件夹

hero_dir='D:\python practice\myhero\\'

if not os.path.exists(hero_dir):

    os.mkdir(hero_dir)

skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/131/131-bigskin-2.jpg'

hero_img = hero_dir+"aa.jpg"

urllib.request.urlretrieve(skin_url,hero_img)
以下为多张皮肤爬取(只贴代码,有空详细解释):
#爬虫 -- 王者荣耀

import urllib.request

import json

import os #对计算机的操作

#json文件

v_herolist_url = urllib.request.urlopen("http://pvp.qq.com/web201605/js/herolist.json")

#请求

v_herolist = v_herolist_url.read().decode('utf-8')

#字符串的截取BOM脚本

# \xef\xbb\xbf -- python 自动加入的编码方式声明

v_hero = v_herolist.encode('utf8')[3:].decode('utf-8')

#转换json格式

#返回一个变量

hero_json = json.loads(v_hero)

#获取长度

hero_num = len(hero_json)

#皮肤网址

#http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/167/167-bigskin-5.jpg

#创建本地文件夹

hero_dir = 'D:\python practice\myhero\\'

if not os.path.exists(hero_dir):

    os.mkdir(hero_dir)

for num in range(hero_num):

   skinsname =  hero_json[num]['skin_name'].split("|")

   for i in range(len(skinsname)):

        skin_name = hero_json[num]['ename']

        #皮肤的数字标记

        #皮肤地址

        skin_url = 'http://game.gtimg.cn/images/yxzj/img201606/skin/hero-info/'+str(skin_name)+'/'+str(skin_name)+'-bigskin-'+str(i+1)+'.jpg'

        #要保存的地址

        save_url=hero_dir+str(skin_name)+"_"+str(i+1)+".jpg"

        urllib.request.urlretrieve(skin_url,save_url)
python学习--第二天 爬取王者荣耀英雄皮肤的更多相关文章
- Python爬取 | 王者荣耀英雄皮肤海报
这里只展示代码,具体介绍请点击下方链接. Python爬取 | 王者荣耀英雄皮肤海报 import requests import re import os import time import wi ...
- python 爬取王者荣耀英雄皮肤代码
import os, time, requests, json, re, sys from retrying import retry from urllib import parse "& ...
- 利用python爬取王者荣耀英雄皮肤图片
前两天看到同学用python爬下来LOL的皮肤图片,感觉挺有趣的,我也想试试,于是决定来爬一爬王者荣耀的英雄和皮肤图片. 首先,我们找到王者的官网http://pvp.qq.com/web201605 ...
- python爬虫---爬取王者荣耀全部皮肤图片
代码: import requests json_headers = { "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win ...
- 20行Python代码爬取王者荣耀全英雄皮肤
引言王者荣耀大家都玩过吧,没玩过的也应该听说过,作为时下最火的手机MOBA游戏,咳咳,好像跑题了.我们今天的重点是爬取王者荣耀所有英雄的所有皮肤,而且仅仅使用20行Python代码即可完成. 准备工作 ...
- Python 爬取 "王者荣耀.英雄壁纸" 过程中的矛和盾
1. 前言 学习爬虫,最好的方式就是自己编写爬虫程序. 爬取目标网站上的数据,理论上讲是简单的,无非就是分析页面中的资源链接.然后下载.最后保存. 但是在实施过程却会遇到一些阻碍. 很多网站为了阻止爬 ...
- 用Python爬取"王者农药"英雄皮肤
0.引言 作为一款现象级游戏,王者荣耀,想必大家都玩过或听过,游戏里中各式各样的英雄,每款皮肤都非常精美,用做电脑壁纸再合适不过了.本篇就来教大家如何使用Python来爬取这些精美的英雄皮肤. 1.环 ...
- 用Python爬取"王者农药"英雄皮肤 原
padding: 10px; border-bottom: 1px solid #d3d3d3; background-color: #2e8b57; } .second-menu-item { pa ...
- python爬取王者荣耀全英雄皮肤
import os import requests url = 'https://pvp.qq.com/web201605/js/herolist.json' herolist = requests. ...
随机推荐
- JavaScript中的编码解码
1.URI 统一资源标识符(URI)是一个用于标识某一互联网资源名称的字符串.,该种标识允许用户对任何(包括本地和互联网)的资源通过特定的协议进行交互操作.Web上可用的每种资源 -HTML文档.图像 ...
- 容器————vector
目录 一.介绍 二.声明及初始化 三.方法 front find remove erase substr 一.介绍 向量 vector 是一种对象实体, 能够容纳许多其他类型相同的元素, 因此又被称为 ...
- paper 163: opencv知识点回顾
From Here: https://zhuanlan.zhihu.com/p/24425116 Python下使用OpenCV 本篇将介绍和深度学习数据处理阶段最相关的基础使用,并完成4个有趣实用的 ...
- Dllregisterserver调用失败解决方法
在做一个注册com组件时,出现这样的情况 出现这个错误一般是和权限问题有关,命令提示符需要以管理员权限运行才可以注册成功. 最简单的解决方法就是: 在开始菜单右击—>命令提示符(管理员)(A) ...
- 汇编 “error A2031”
assume cs:code code segment main: mov ax,0020h mov ds,ax ;指定段地址0200h mov dx,0h mov cx,003fh s: mov [ ...
- 小程序 js 判断 字符串 为空 null
判断字符串是否为空 1 2 3 4 5 var strings = ''; if (string.length == 0) { alert('不能为空'); } 判断字符串是否为“空”字符即用户输入了 ...
- python input() 与raw_input()
使用input和raw_input都可以读取控制台的输入,但是input和raw_input在处理数字时是有区别的1:纯数字输入 当输入为纯数字时 input返回的是数值类型,如int,float ...
- 【原】webpack--文件监听的原理
轮询判断文件的最后编辑时间是否发生变化,一开始有个文件的修改时间,先存储起来这个修改时间,下次再有修改就会和上次修改时间比对,发现不一致的时候不会立即告诉监听者,而是把文件修改缓存起来,等待一段时间, ...
- PHP连接FTP服务的简单实现
PHP连接FTP服务: <?php class Ftp { private $connect; private $getback; /** * ftp连接信息 * @var array */ p ...
- 题解 P1017 【进制转换】
我赶jio这个题难道是让我们写快写? 不管了,赶紧把咕咕咕了一万年的题解写出来. 这个题就是考察负进制和在mod意义下的除法运算的基础运算. (其实也没多大问题) 首先我们先假设一个原始数据\(num ...