
loglikelihood ratio 相似度
摘要:
在机器学习中常用到各种距离或者相似度,今天在看美团推荐系统重排序的文章时看到了loglikelihood ratio 相似度,特总结起来。以后有时间再把常用的相似度或者距离梳理到一篇文章。
背景:
记录loglikelihood ratio 相似度概念
总结:
在mahout中,loglikelihood ratio也作为一种相似度计算方法被采用。
下表表示了Event A和Event B之间的相互关系,其中:
k11 :Event A和Event B共现的次数
k12 :Event A发生,Event B未发生的次数
k21 :Event B发生,Event A未发生的次数
k22 :Event A和Event B都不发生的次数
则logLikelihoodRatio=2 * (matrixEntropy - rowEntropy - columnEntropy)
其中
rowEntropy = entropy(k11, k12) + entropy(k21, k22)
columnEntropy = entropy(k11, k21) + entropy(k12, k22)
matrixEntropy = entropy(k11, k12, k21, k22)
(entropy为几个元素组成的系统的香农熵)
下面举一个实际的例子:
我以一个实际的例子来介绍一下其中的计算过程:假设有商品全集I={a,b,c,d,e,f},其中A用户偏好商品{a,b,c},B用户偏好商品{b,d},那么有如下矩阵:
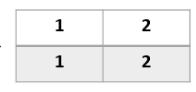
- k11表示用户A和用户B的共同偏好的商品数量,显然只有商品b,因此值为1
- k12表示用户A的特有偏好,即商品{a,c},因此值为2
- k21表示用户B的特有偏好,即商品d,因此值为1
- k22表示用户A、B的共同非偏好,有商品{e,f},值为2
此外我们还定义以下变量N=k11+k12+k21+k22,即总商品数量。
计算步骤如下:
计算行熵
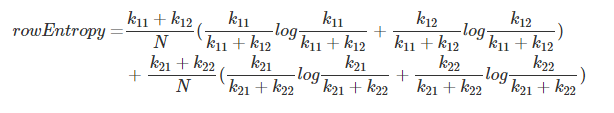
注:代码中k11+k12与k21+k22均被约掉了,分母N也省去了
计算列熵
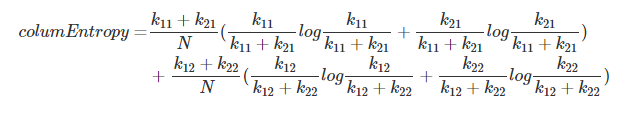
计算矩阵熵
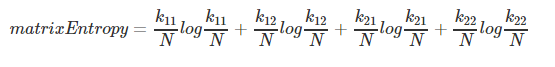
注意:以上熵的计算均没有加负号,后面会讲到原因
计算相似度
UserSimilarity=2∗(matrixEntropy−rowEntropy−columnEntropy)- 实现代码:https://github.com/Tongzhenguo/Java-codes/blob/master/src/main/java/data/code/similarity/logLikelihoodRatio.java
参考链接:
http://www.csdn.net/article/2015-01-30/2823783
http://blog.csdn.net/u014374284/article/details/49823557
loglikelihood ratio 相似度的更多相关文章
- SVM与LR的比较
两种方法都是常见的分类算法,从目标函数来看,区别在于逻辑回归采用的是logistical loss,svm采用的是hinge loss.这两个损失函数的目的都是增加对分类影响较大的数据点的权重,减少与 ...
- DNA binding motif比对算法
DNA binding motif比对算法 2012-08-31 ~ ADMIN 之前介绍了序列比对的一些算法.本节主要讲述motif(有人翻译成结构模式,但本文一律使用基模)的比对算法. 那么什么是 ...
- OpenCV进行图像相似度对比的几种办法
转载请注明出处:http://blog.csdn.net/wangyaninglm/article/details/43853435, 来自:shiter编写程序的艺术 对计算图像相似度的方法,本文做 ...
- Python 连接MongoDB并比较两个字符串相似度的简单示例
本文介绍一个示例:使用 pymongo 连接 MongoDB,查询MongoDB中的 字符串 记录,并比较字符串之间的相似度. 一,Python连接MongoDB 大致步骤:创建MongoClient ...
- 字符串相似度算法-LEVENSHTEIN DISTANCE算法
Levenshtein Distance 算法,又叫 Edit Distance 算法,是指两个字符串之间,由一个转成另一个所需的最少编辑操作次数.许可的编辑操作包括将一个字符替换成另一个字符,插入一 ...
- 【NLP】Python实例:基于文本相似度对申报项目进行查重设计
Python实例:申报项目查重系统设计与实现 作者:白宁超 2017年5月18日17:51:37 摘要:关于查重系统很多人并不陌生,无论本科还是硕博毕业都不可避免涉及论文查重问题,这也对学术不正之风起 ...
- python-Levenshtein几个计算字串相似度的函数解析
linux环境下,没有首先安装python_Levenshtein,用法如下: 重点介绍几个该包中的几个计算字串相似度的几个函数实现. 1. Levenshtein.hamming(str1, str ...
- win7基于mahout推荐之用户相似度计算
http://www.douban.com/note/319219518/?type=like win7基于mahout推荐之用户相似度计算 2013-12-03 09:19:11 事情回到半年 ...
- Levenshtein计算相似度距离
使用Levenshtein计算相似度距离,装下模块,调用下函数就好. 拿idf还得自己去算权重,而且不一定准确度高,一般做idf还得做词性归一化,把动词形容词什么全部转成名词,很麻烦. Levensh ...
随机推荐
- WCF 套接字连接已中止。这可能是由于处理消息时出错或远程主机超过接收超时或者潜在的网络资源问题导致的
一个项目需要用到推送的功能,就是服务器主动推送数据给多台客户机.于是采用了WCF的双工通讯netTcpBinding 写好的项目,在本机测试都没有问题. 如果放在局域网内测试,问题出来了:先是安全性问 ...
- LeetCode(97) Interleaving String
题目 Given s1, s2, s3, find whether s3 is formed by the interleaving of s1 and s2. For example, Given: ...
- hdoj 1272 小希的迷宫
上次Gardon的迷宫城堡小希玩了很久(见Problem B),现在她也想设计一个迷宫让Gardon来走.但是她设计迷宫的思路不一样,首先她认为所有的通道都应该是双向连通的,就是说如果有一个通道连通了 ...
- uglifyjs2压缩混淆js文件
uglifyjs可以用来压缩混淆js文件,发布release版本应用利器.在StackOverflow浏览了一下,相比Google Closure和YUI compressor,uglifyjs被推荐 ...
- Fiddler 工作原理
Fiddler工作原理: 就在在客户端与服务器端创建一个代理服务器: 在开启Fiddler后,Fiddler会自动窜改浏览器的代理,例如我们打开Fiddler,打开IE浏览器--设置--Interne ...
- 【洛谷P3076】Taxi
这道题值得好好想一会 我们通过对一些小数据的手算,以及对于每段路程的拆分,可以发现: 1.每个st对应的ed这段路程无论如何都要算上 2.额外还要计算的一段路程,就是"切换"费用 ...
- NPOI创建DOCX常用操作【转】
1. 创建文档 XWPFDocument m_Docx = new XWPFDocument();2. 页面设置 //1‘=1440twip=25.4mm=72pt(磅point)=96px(像素 ...
- git ignore
我最初将整个项目push到远程仓库,但是项目代码里面有大文件,从而传输太费时间了. 看网上的说法,可以通过ignore文件达到不提交某些文件的效果,尝试了一下发现不行. 后来尝试清除缓存 $ git ...
- Jquery Mobile 学习笔记(一)
1.模拟器,IOS:XCODE GENYMOTION ANDROID:ECLIPSE GENYMOTION 2.jquery mobile data-role=page 代表一个页面 data-po ...
- oracle sys as dba
====管理分区表====1.添加分区(若已设置取值范围为MAXVALUE的分区,则会报ORA-14174分区界限必须调整为高于最后一个分区界限)alter table test_part_tab a ...