
NodeJS的url信息截取模块url-extract
NodeJS的url信息截取模块url-extract2013-09-12 22:49 by Justany_WhiteSnow, 212 阅读, 0 评论, 收藏, 编辑
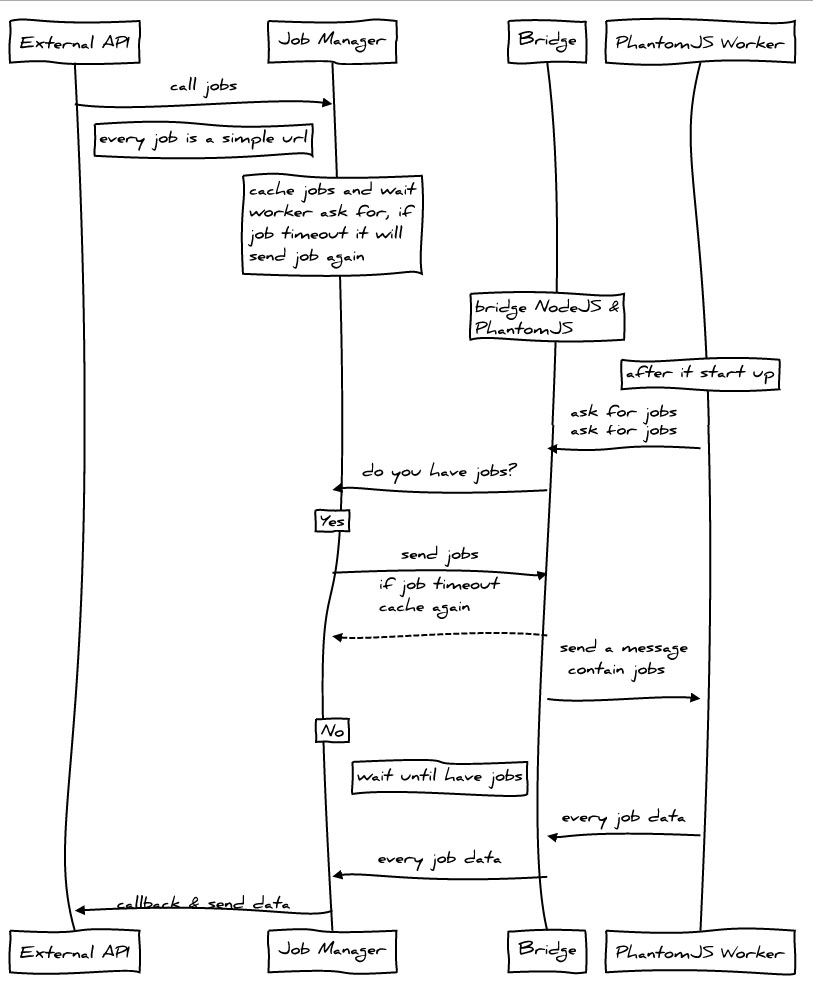
上一篇文章,介绍了怎么利用NodeJS + PhantomJS进行截图,但由于对每次截图操作,都启用了一个PhantomJS进程,所以并发量上去后,效率堪忧,所以我们重写了所有代码,并将其独立成为一个模块,方便调用。
如何改进?
- 控制线程数,以及单线程处理url数量。
- 使用Standard Output & WebSocket 进行通讯。
- 添加缓存机制,目前使用Javascript Object进行。
- 对外提供简易的接口。
设计图
依赖 & 安装
由于PhantomJS 1.9.0+才开始支持Websocket,所以我们先要确定在PATH中的PhantomJS是为1.9.0以上版本。在命令行键入:
$ phantomjs -v
如果能返回版本号1.9.x,则可以继续操作。如果版本过低,或者出现错误,请到PhantomJS官网下载最新版本。
如果你已经安装了Git,或者拥有Git Shell,那么在命令行键入:
$ npm install url-extract
进行安装。
如果没有,那么请在下面的连接下载整个项目:
http://pan.baidu.com/share/link?shareid=1055562065&uk=855675565
一个简单的例子
比如我们要截取百度首页,那么可以这样:

module.exports = (function () {

  "use strict"

  var urlExtract = require('url-extract');

  urlExtract.snapshot('http://www.baidu.com', function (job) {

    console.log('This is a snapshot example.');

    console.log(job);

    process.exit();

  });

})();
下面是打印:
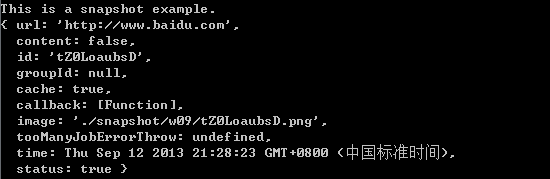
其中,image属性就是截图相对于工作路径的地址。我们可以使用Job的getData接口来得到更清楚的数据,例如:
module.exports = (function () {

  "use strict"

  var urlExtract = require('url-extract');

  urlExtract.snapshot('http://www.baidu.com', function (job) {

    console.log('This is a snapshot example.');

    console.log(job.getData());

    process.exit();

  });

})();
打印就变成了这样了:

image表示截图相对于工作路径的地址,status表示状态是否正常,true代表正常,false代表截图失败。
更多例子请参见:https://github.com/miniflycn/url-extract/tree/master/examples
主要API
.snapshot
url快照
- .snapshot(url, [callback])
- .snapshot(urls, [callback])
- .snapshot(url, [option])
- .snapshot(urls, [option])
url {String} 要截取的地址
urls {Array} 要截取的地址数组
callback {Function} 回调函数
option {Object} 可选参数
┝ id {String} 自定义url的id,如果第一个参数是urls,此参数无效
┝ image {String} 自定义截图的保存地址,如果第一个参数是urls,此参数无效
┝ groupId {String} 定义一组url的groupId,用于返回时候辨认是哪一组url
┝ ignoreCache {Boolean} 是否忽略缓存
┗ callback {Function} 回调函数
.extract
url信息抓取,并获取快照
- .extract(url, [callback])
- .extract(urls, [callback])
- .extract(url, [option])
- .extract(urls, [option])
url {String} 要截取的地址
urls {Array} 要截取的地址数组
callback {Function} 回调函数
option {Object} 可选参数
┝ id {String} 自定义url的id,如果第一个参数是urls,此参数无效
┝ image {String} 自定义截图的保存地址,如果第一个参数是urls,此参数无效
┝ groupId {String} 定义一组url的groupId,用于返回时候辨认是哪一组url
┝ ignoreCache {Boolean} 是否忽略缓存
┗ callback {Function} 回调函数
Job(类)
每一个url对应一个job对象,url的相关信息由job对象存储。
Field
- url {String} 链接地址
- content {Boolean} 是否抓取页面的title和description信息
- id {String} job的id
- groupId {String} 一堆job的组id
- cache {Boolean} 是否开启缓存
- callback {Function} 回调函数
- image {String} 图片地址
- status {Boolean} job当前是否正常
Prototype
- getData() 获取job的相关数据
全局配置
url-extract根目录中的config文件可以进行全局配置,默认如下:
module.exports = {

  wsPort: 3001,

  maxJob: 100,

  maxQueueJob: 400,

  cache: 'object',

  maxCache: 10000,

  workerNum: 0

};
- wsPort {Number} websocket占用的端口地址
- maxJob {Number} 每个PhantomJS线程可并发worker数
- maxQueueJob {Number} 最大等待工作数量,0表示不限制,超过该数量,任何工作都直接返回失败(即status = false)
- cache {String} 缓存实现,目前只有object实现
- maxCache {Number} 最大缓存链接数
- workerNum {Number} PhantomJS线程数,0表示和CPU数量相同
一个简单的服务例子
https://github.com/miniflycn/url-extract-server-example
注意,需要安装connect和url-extract:
$ npm install
如果你下载了网盘的文件,那么请安装connect:
$ npm install connect
然后键入:
$ node bin/server
打开:
查看效果。
NodeJS的url信息截取模块url-extract的更多相关文章
- PHP模拟发送POST请求之二、用PHP和JS处理URL信息
明白了HTTP请求的头信息后,我们还需要对请求地址有所了解.再者,HTTP GET请求是靠URL实现的,所以了解URL的构造,处理URL的重要性不言而喻. 在PHP中我们用parse_url()函数来 ...
- Node.js:path、url、querystring模块
Path模块 该模块提供了对文件或目录路径处理的方法,使用require('path')引用. 1.获取文件路径最后部分basename 使用basename(path[,ext])方法来获取路径的最 ...
- nodejs学习笔记<三>关于路由(url)
在网站开发中,路由的设置非常关键.nodejs对路由处理封装了一个比较全面的模块. 来认识下url模块 1)在命令行(cmd)可以直接 node —> url 可直接查看url模块的所有方法. ...
- node(03)--利用 HTTP 模块 URl 模块 PATH 模块 FS 模块创建一个 WEB 服务器
Web 服务器一般指网站服务器,是指驻留于因特网上某种类型计算机的程序,可以向浏览器等 Web 客户端提供文档,也可以放置网站文件,让全世界浏览:可以放置数据文件,让全世界下载.目前最主流的三个 We ...
- 字符串格式的Url的截取
一,我们先在看在页面上获取的URL的处理,如下方法: //获取全部URL string Url = Request.Url.ToString(); Url += "</br>&q ...
- 用心整理的 献丑啦 一些关于http url qs fs ...模块的方法
http: const http = require("http"); http.createServer((req , res)=>{ req:request 请求 ...
- js获取url信息
设置或获取对象指定的文件名或路径. alert(window.location.pathname) 设置或获取整个 URL 为字符串. alert(window.location.href); 设置或 ...
- 一个用php实现的获取URL信息的类
获取URL信息的类 使用这个类,你能获得URL的如下信息: - Host - Path - Statuscode (eg. 404,200, ...) - HTTP Version - Ser ...
- ASP.NET获取请求的url信息汇总
ASP.NET获取请求的url信息汇总 最近做项目需要处理一个用代码获取当前网站的域名或ip信息的问题,于是尝试了ASP.NET中各种获取url信息的方法,在此总结一下: 在Global.asax文件 ...
随机推荐
- crawler_基于块儿统计正文抽取_改进版
在线查看效果:http://tool.haoshuju.cn/ import java.util.ArrayList; import java.util.Arrays; import java.uti ...
- Eclipse部署Web项目(图文讲解)
讲解是在linux下完成的,但对windows系统,操作也是一样的,不要被吓到了 1.下载Eclipse
- maven+hudson构建集成测试平台
1.下载hudson.war.2.命令行运行:java -jar hudson.war --httpPort=8070 -Dorg.eclipse.jetty.util.URI.charset=GB ...
- Asp.net Mvc WebSocket
转载一种仿照Asp.net Mvc思维构建WebSocket服务器的方法 问题场景 Asp.net Mvc提供了DependencyResolver.Routing.Filter. Modelbind ...
- 【百度地图API】如何激发手机的高分辨率
原文:[百度地图API]如何激发手机的高分辨率 摘要:不少用户使用百度地图API开发在移动浏览器上的应用时发现,明明自己的手机是高分辨率的,但是显示出来的地图却比较模糊,甚至“看不清楚”.接下来,我们 ...
- 使用Visual Studio创建映像向导(Image Sprite)——Web Essential
原版的:Creating Image Sprite in Visual Studio - Web Essential 译者注:有关图片精灵的信息请參阅http://baike.baidu.com/vi ...
- APMServ—我用过的最优秀的PHP集成环境工具
原文:APMServ-我用过的最优秀的PHP集成环境工具 经常折腾wordpress和各种cms,免不了要在本地测试一些程序,所以选择一款好的php集成环境就至关重要啦. 1. 我用过的php集成环境 ...
- [CLR via C#]1.6 Framework类库~1.9与非托管代码的互操作性
原文:[CLR via C#]1.6 Framework类库~1.9与非托管代码的互操作性 1.6 Framework类库 1. .NET Framework中包含了Framework类库(Frame ...
- JavaScript实现简单日历
页面代码: <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w ...
- R - 变化plot字形,嵌入字体以pdf
近期使用R绘图遇到两个问题 1. 使用不同的字体 2. 保存 plot 至 pdf 当字体嵌入pdf (embed the font) 使用extrafont和Ghostscript能够解决这两个问题 ...