
100天搞定机器学习:PyYAML基础教程
编程中免不了要写配置文件,今天我们继续Python网络编程,学习一个比 JSON 更简洁和强大的语言————YAML 。本文老胡简单介绍 YAML 的语法和用法,以及 YAML 在机器学习项目中的应用实例。欢迎大家一起学习,也欢迎点赞、在看、分享!
YAML
YAML 是 "YAML Ain't a Markup Language"(YAML 不是一种标记语言)的递归缩写。YAML 的语法和其他高级语言类似,并且可以简单表达清单、散列表,标量等数据形态。它使用空白符号缩进和大量依赖外观的特色,特别适合用来表达或编辑数据结构、各种配置文件、倾印调试内容、文件大纲。YAML 的配置文件后缀为 .yaml
YAML 它的基本语法规则如下:
- 大小写敏感
- 使用缩进表示层级关系
- 缩进时不允许使用Tab键,只允许使用空格。
- 缩进的空格数目不重要,只要相同层级的元素左侧对齐即可
号 表示注释
YAML 支持的数据结构有三种:
- 对象:键值对的集合,对象键值对使用冒号结构表示 key: value,冒号后面要加一个空格。
- 数组:一组按次序排列的值,又称为序列/ 列表,用 - 表示。
- 纯量(scalars):单个的、不可再分的值
YAML 用法
安装
pip install pyyaml
yaml 文件格式很简单,比如:
# categories.yaml file

sports: #注意,冒号后面要加空格

  - soccer # 数组

  - football

  - basketball

  - cricket

  - hockey

  - table tennis

countries:

  - Pakistan

  - USA

  - India

  - China

  - Germany

  - France

  - Spain
python 读取 yaml 文件
# read_categories.py file

import yaml

with open(r'categories.yaml') as file:

    documents = yaml.full_load(file)

    for item, doc in documents.items():

        print(item, ":", doc)
运行结果:
sports : ['soccer', 'football', 'basketball', 'cricket', 'hockey', 'table tennis']

countries : ['Pakistan', 'USA', 'India', 'China', 'Germany', 'France', 'Spain']
以上便是 YAML 最基础的应用了,可能大家还是有点一头雾水,咱们更进一步,看看在机器学习项目中如何写 YAML 配置文件。
YAML & Machine Learning
我们直接改写100天搞定机器学习|Day62 随机森林调参实战中的代码。
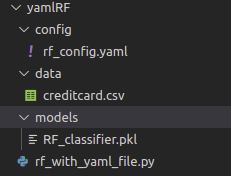
写配置文件rf_config.yaml
#INITIAL SETTINGS

data_directory: ./data/

data_name: creditcard.csv

target_name: Class

test_size: 0.3

model_directory: ./models/

model_name: RF_classifier.pkl

#RF parameters

n_estimators: 50

max_depth: 6

min_samples_split: 5

oob_score: True

random_state: 666

n_jobs: 2
完整代码,可以对比源代码看看区别:
# rf_with_yaml_file.py

import os

import yaml

import joblib

import numpy as np

import pandas as pd

from sklearn.model_selection import train_test_split

from sklearn.ensemble import RandomForestClassifier

from sklearn.metrics import roc_auc_score

CONFIG_PATH = "./config/"

def load_config(config_name):

    with open(os.path.join(CONFIG_PATH, config_name)) as file:

        config = yaml.safe_load(file)

    return config

config = load_config("rf_config.yaml")

df = pd.read_csv(os.path.join(config["data_directory"], config["data_name"]))

data = df.iloc[:, 1:31]

X = data.loc[:, data.columns != config["target_name"]]

y = data.loc[:, data.columns == config["target_name"]]

number_records_fraud = len(data[data.Class == 1])

fraud_indices = np.array(data[data.Class == 1].index)

normal_indices = data[data.Class == 0].index

random_normal_indices = np.random.choice(

    normal_indices, number_records_fraud, replace=False)

random_normal_indices = np.array(random_normal_indices)

under_sample_indices = np.concatenate(

    [fraud_indices, random_normal_indices])

under_sample_data = data.iloc[under_sample_indices, :]

X_undersample = under_sample_data.loc[:,

                                      under_sample_data.columns != config["target_name"]]

y_undersample = under_sample_data.loc[:,

                                      under_sample_data.columns == config["target_name"]]

X_train, X_test, y_train, y_test = train_test_split(

    X, y, test_size=config["test_size"], random_state=42

)

rf1 = RandomForestClassifier(

    n_estimators=config["n_estimators"],

    max_depth=config["max_depth"],

    min_samples_split=config["min_samples_split"],

    oob_score=config["oob_score"],

    random_state=config["random_state"],

    n_jobs=config["n_jobs"]

)

rf1.fit(X_train, y_train)

print(rf1.oob_score_)

y_predprob1 = rf1.predict_proba(X_test)[:, 1]

print("AUC Score (Train): %f" % roc_auc_score(y_test, y_predprob1))

joblib.dump(rf1, os.path.join(config["model_directory"], config["model_name"]))
reference
https://www.runoob.com/w3cnote/yaml-intro.html
https://www.ruanyifeng.com/blog/2016/07/yaml.html
100天搞定机器学习:PyYAML基础教程的更多相关文章
- 100天搞定机器学习|Day19-20 加州理工学院公开课:机器学习与数据挖掘
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day21 Beautiful Soup
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day35 深度学习之神经网络的结构
100天搞定机器学习|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习 ...
- 100天搞定机器学习|day40-42 Tensorflow Keras识别猫狗
100天搞定机器学习|1-38天 100天搞定机器学习|day39 Tensorflow Keras手写数字识别 前文我们用keras的Sequential 模型实现mnist手写数字识别,准确率0. ...
- 100天搞定机器学习|Day56 随机森林工作原理及调参实战(信用卡欺诈预测)
本文是对100天搞定机器学习|Day33-34 随机森林的补充 前文对随机森林的概念.工作原理.使用方法做了简单介绍,并提供了分类和回归的实例. 本期我们重点讲一下: 1.集成学习.Bagging和随 ...
- 100天搞定机器学习|Day7 K-NN
最近事情无比之多,换了工作.组队参加了一个比赛.和朋友搞了一些小项目,公号荒废许久.坚持是多么重要,又是多么艰难,目前事情都告一段落,我们继续100天搞定机器学习系列.想要继续做这个是因为,一方面在具 ...
- 100天搞定机器学习|Day11 实现KNN
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
- 100天搞定机器学习|Day8 逻辑回归的数学原理
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
- 100天搞定机器学习|Day9-12 支持向量机
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
随机推荐
- NGK的发行量是多少?NGK销毁机制是怎么样的?
代币销毁(Coin Burning),是指将代币从流通中永久性去除.换句话说,被销毁的代币相当于被永久性冻结,再也无法流入市场.那为什么要进行代币销毁呢? 销毁加密货币,可以使剩余加密货币的价值升高, ...
- javascript 十大经典排序
首先生成一个数字数组: let arr = Array.from({length:20},x=>{return Math.ceil(Math.random()*10**2)}) console. ...
- Maven报错:Unsupported major.minor version 51.0
这个错误时因为JDK版本的问题,比如本机的JDK为1.6,但是项目编译时用的JDK为1.7那么就会出现这个异常,因为本机JDK版本较低不能执行编译版本为高版本的Class文件,各JDK版本对应的错误编 ...
- Java中base64与byte[]转换
1.base64转byte[] 导包: import java.util.Base64 转换: String base64Str = base64的字符串; byte[] bytes = Base64 ...
- 【JAVA并发第四篇】线程安全
1.线程安全 多个线程对同一个共享变量进行读写操作时可能产生不可预见的结果,这就是线程安全问题. 线程安全的核心点就是共享变量,只有在共享变量的情况下才会有线程安全问题.这里说的共享变量,是指多个线程 ...
- Python分类模型构建
分离训练集测试集 from sklearn.model_selection import train_test_split eg: X_train, X_test, y_train, y_test = ...
- 顶级c程序员之路 选学篇-1 深入理解字节,字节序与字节对齐
深入理解字节,字节序与字节对齐 一 总述 作为一个职业的coder玩家,首先应该对计算机的字节有所了解. 我们经常谈到的2进制流,字节(字符)流,数据类型流(针对编程),结构流等说法,2进制流,0和 ...
- hive中更改表impala中不能生效
hive中的更新或者新建表impala 不能实时更新 Impala是基于Hive的大数据实时分析查询引擎,直接使用Hive的元数据库Metadata,意味着impala元数据都存储在Hive的meta ...
- 七. SpringCloud服务配置
1. SpringCloud Config概述 1.1 分布式系统面临的配置问题 微服务意味着要将单体应用中的业务拆分成一个一个子服务,每个服务的粒度相对较小,因此系统中会出现大量的服务.由于每个服务 ...
- JavaScript中的事件循环机制跟函数柯里化
一.事件循环机制的理解 test();//按秒输出5个5 function test() { for (var i = 0; i < 5; i++) { setTimeout(() => ...