
19条常用的MySQL优化方法(转)
本文我们来谈谈项目中常用的MySQL优化方法,共19条,具体如下:
1、EXPLAIN命令做MySQL优化,我们要善用EXPLAIN查看SQL执行计划。下面来个简单的示例,标注(1、2、3、4、5)我们要重点关注的数据:
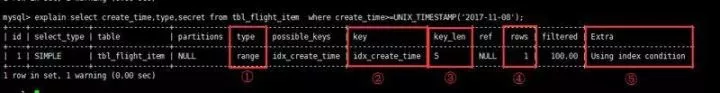
- type列,连接类型。一个好的SQL语句至少要达到range级别。杜绝出现all级别。
- key列,使用到的索引名。如果没有选择索引,值是NULL。可以采取强制索引方式。
- key_len列,索引长度。
- rows列,扫描行数。该值是个预估值。
- extra列,详细说明。注意,常见的不太友好的值,如下:Using filesort,Using temporary。
2、SQL语句中IN包含的值不应过多MySQL对于IN做了相应的优化,即将IN中的常量全部存储在一个数组里面,而且这个数组是排好序的。但是如果数值较多,产生的消耗也是比较大的。再例如:select id from t where num in(1,2,3) 对于连续的数值,能用between就不要用in了;再或者使用连接来替换。
3、SELECT语句务必指明字段名称SELECT*增加很多不必要的消耗(CPU、IO、内存、网络带宽);增加了使用覆盖索引的可能性;当表结构发生改变时,前断也需要更新。所以要求直接在select后面接上字段名。
4、当只需要一条数据的时候,使用limit 1这是为了使EXPLAIN中type列达到const类型
5、如果排序字段没有用到索引,就尽量少排序
6、如果限制条件中其他字段没有索引,尽量少用oror两边的字段中,如果有一个不是索引字段,而其他条件也不是索引字段,会造成该查询不走索引的情况。很多时候使用union all或者是union(必要的时候)的方式来代替“or”会得到更好的效果。
7、尽量用union all代替unionunion和union all的差异主要是前者需要将结果集合并后再进行唯一性过滤操作,这就会涉及到排序,增加大量的CPU运算,加大资源消耗及延迟。当然,union all的前提条件是两个结果集没有重复数据。
8、不使用ORDER BY RAND()
select id from `dynamic` order by rand() limit 1000;上面的SQL语句,可优化为:
select id from `dynamic` t1 join (select rand() * (select max(id) from `dynamic`) as nid) t2 on t1.id > t2.nidlimit 1000;9、区分in和exists、not in和not exists
select * from 表A where id in (select id from 表B)上面SQL语句相当于
select * from 表A where exists(select * from 表B where 表B.id=表A.id)区分in和exists主要是造成了驱动顺序的改变(这是性能变化的关键),如果是exists,那么以外层表为驱动表,先被访问,如果是IN,那么先执行子查询。所以IN适合于外表大而内表小的情况;EXISTS适合于外表小而内表大的情况。关于not in和not exists,推荐使用not exists,不仅仅是效率问题,not in可能存在逻辑问题。如何高效的写出一个替代not exists的SQL语句?原SQL语句:
select colname … from A表 where a.id not in (select b.id from B表)高效的SQL语句:
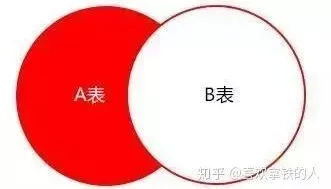
select colname … from A表 Left join B表 on where a.id = b.id where b.id is null取出的结果集如下图表示,A表不在B表中的数据:
10、使用合理的分页方式以提高分页的效率
select id,name from product limit 866613, 20使用上述SQL语句做分页的时候,可能有人会发现,随着表数据量的增加,直接使用limit分页查询会越来越慢。优化的方法如下:可以取前一页的最大行数的id,然后根据这个最大的id来限制下一页的起点。比如此列中,上一页最大的id是866612。SQL可以采用如下的写法:
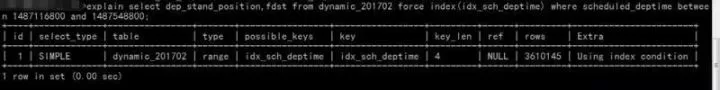
select id,name from product where id> 866612 limit 2011、分段查询在一些用户选择页面中,可能一些用户选择的时间范围过大,造成查询缓慢。主要的原因是扫描行数过多。这个时候可以通过程序,分段进行查询,循环遍历,将结果合并处理进行展示。如下图这个SQL语句,扫描的行数成百万级以上的时候就可以使用分段查询:
12、避免在where子句中对字段进行null值判断对于null的判断会导致引擎放弃使用索引而进行全表扫描。13、不建议使用%前缀模糊查询例如LIKE“%name”或者LIKE“%name%”,这种查询会导致索引失效而进行全表扫描。但是可以使用LIKE “name%”。那如何查询%name%?如下图所示,虽然给secret字段添加了索引,但在explain结果并没有使用:
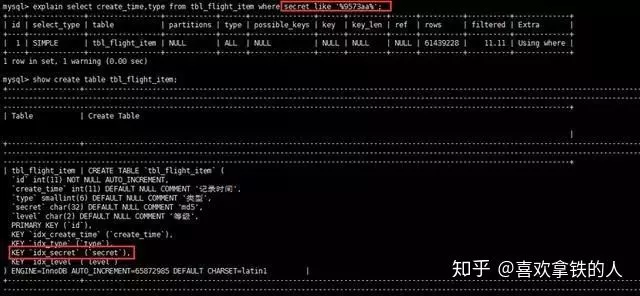
那么如何解决这个问题呢,答案:使用全文索引。在我们查询中经常会用到select id,fnum,fdst from dynamic_201606 where user_name like '%zhangsan%'; 。这样的语句,普通索引是无法满足查询需求的。庆幸的是在MySQL中,有全文索引来帮助我们。创建全文索引的SQL语法是:
ALTER TABLE `dynamic_201606` ADD FULLTEXT INDEX `idx_user_name` (`user_name`);使用全文索引的SQL语句是:
select id,fnum,fdst from dynamic_201606 where match(user_name) against('zhangsan' in boolean mode);注意:在需要创建全文索引之前,请联系DBA确定能否创建。同时需要注意的是查询语句的写法与普通索引的区别。
14、避免在where子句中对字段进行表达式操作比如:
select user_id,user_project from user_base where age*2=36;中对字段就行了算术运算,这会造成引擎放弃使用索引,建议改成:
select user_id,user_project from user_base where age=36/2;15、避免隐式类型转换where子句中出现column字段的类型和传入的参数类型不一致的时候发生的类型转换,建议先确定where中的参数类型。
16、对于联合索引来说,要遵守最左前缀法则举列来说索引含有字段id、name、school,可以直接用id字段,也可以id、name这样的顺序,但是name;school都无法使用这个索引。所以在创建联合索引的时候一定要注意索引字段顺序,常用的查询字段放在最前面。
17、必要时可以使用force index来强制查询走某个索引有的时候MySQL优化器采取它认为合适的索引来检索SQL语句,但是可能它所采用的索引并不是我们想要的。这时就可以采用forceindex来强制优化器使用我们制定的索引。
18、注意范围查询语句对于联合索引来说,如果存在范围查询,比如between、>、<等条件时,会造成后面的索引字段失效。
19、关于JOIN优化:
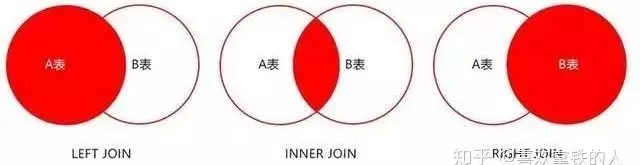
LEFT JOIN A表为驱动表,INNER JOIN MySQL会自动找出那个数据少的表作用驱动表,RIGHT JOIN B表为驱动表。
注意:
1)MySQL中没有full join,可以用以下方式来解决:
select * from A left join B on B.name = A.namewhere B.name is nullunion allselect * from B;2)尽量使用inner join,避免left join:参与联合查询的表至少为2张表,一般都存在大小之分。如果连接方式是inner join,在没有其他过滤条件的情况下MySQL会自动选择小表作为驱动表,但是left join在驱动表的选择上遵循的是左边驱动右边的原则,即left join左边的表名为驱动表。
3)合理利用索引:被驱动表的索引字段作为on的限制字段。
4)利用小表去驱动大表:
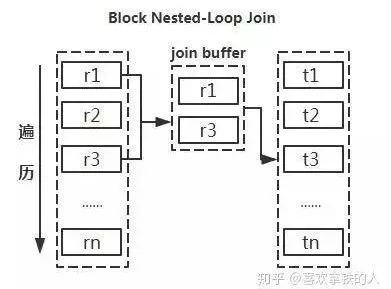
从原理图能够直观的看出如果能够减少驱动表的话,减少嵌套循环中的循环次数,以减少 IO总量及CPU运算的次数。
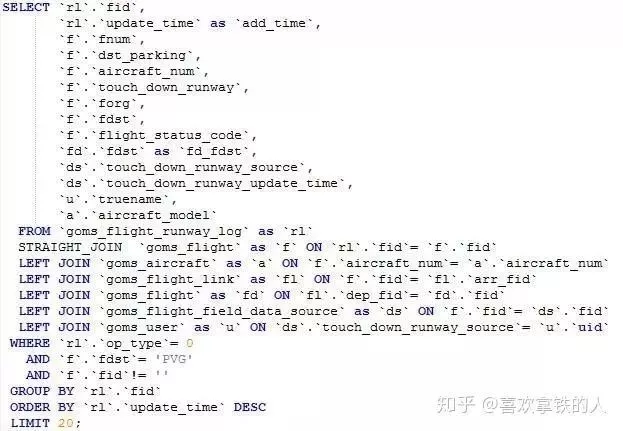
5)巧用STRAIGHT_JOIN:inner join是由MySQL选择驱动表,但是有些特殊情况需要选择另个表作为驱动表,比如有group by、order by等「Using filesort」、「Using temporary」时。STRAIGHT_JOIN来强制连接顺序,在STRAIGHT_JOIN左边的表名就是驱动表,右边则是被驱动表。在使用STRAIGHT_JOIN有个前提条件是该查询是内连接,也就是inner join。其他链接不推荐使用STRAIGHT_JOIN,否则可能造成查询结果不准确。
19条常用的MySQL优化方法(转)的更多相关文章
- 项目中常用的MySQL优化方法--壹拾玖条
1.EXPLAIN 做MySQL优化,我们要善用EXPLAIN查看SQL执行计划. 下面来个简单的示例,标注(1.2.3.4.5)我们要重点关注的数据: type列,连接类型.一个好的SQL语句至少要 ...
- 项目中常用的MySQL 优化
本文我们来谈谈项目中常用的MySQL优化方法,共19条,具体如下: 一.EXPLAIN 做MySQL优化,我们要善用EXPLAIN查看SQL执行计划. 下面来个简单的示例,标注(1.2.3.4.5)我 ...
- mysql优化方法积累
1.对查询进行优化,应尽量避免全表扫描,首先应考虑在 where 及 order by 涉及的列上建立索引. 2.应尽量避免在 where 子句中对字段进行 null 值判断,否则将导致引擎放弃使用索 ...
- 常用的webpack优化方法
1. 前言 关于webpack,相信现在的前端开发人员一定不会陌生,因为它已经成为前端开发人员必不可少的一项技能,它的官方介绍如下: webpack 是一个模块打包器.webpack的主要目标是将 J ...
- 最全 MySQL 优化方法,从此优化不再难
说起MySQL的查询优化,相信大家收藏了一堆奇技淫巧:不能使用SELECT *.不使用NULL字段.合理创建索引.为字段选择合适的数据类型..... 你是否真的理解这些优化技巧?是否理解其背后的工作原 ...
- mysql优化方法
1.选取最适用的字段属性 MySQL可以很好的支持大数据量的存取,但是一般说来,数据库中的表越小,在它上面执行的查询也就会越快.因此,在创建表的时候,为了获得更好的性能,我们可以将表中字段的宽度设得尽 ...
- mysql 优化方法
1.选取最适用的字段属性 MySQL可以很好的支持大数据量的存取,但是一般说来,数据库中的表越小,在它上面执行的查询也就会越快.因此,在创建表的时候,为了获得更好的性能,我们可以将表中字段的宽度设得尽 ...
- mysql优化方法陈列
高并发大多的瓶颈在后台,在存储,mysql的正常的优化方案如下: 1)代码中sql语句优化 2)数据库字段优化,索引优化 3)加缓存,redis/memcache等 4)主从,读写分离 5)分区表 6 ...
- 19 个常用的 JavaScript 简写方法
来自:SangSir 链接:https://segmentfault.com/a/1190000012673854 原文:https://www.sitepoint.com/shorthand-jav ...
随机推荐
- 高强度学习训练第一天总结:Java内存区域
---恢复内容开始--- 程序计数器: 程序计数器(Program Counter Register) 是一块较小的空间,他可以看作是当前线程所执行的字节码的行号指示器.在虚拟机的概念模型里(仅是概念 ...
- fetch和XMLHttpRequest
fetch和XMLHttpRequest 如果看网上的fetch教程,会首先对比XMLHttpRequest和fetch的优劣,然后引出一堆看了很快会忘记的内容(本人记性不好).因此,我写一篇关于fe ...
- js 设计模式——单例模式
单例模式 保证一个类仅有一个实例,并提供一个访问它的全局访问点. 单例模式是一种常用的模式,有一些对象我们往往只需要一个,比如线程池.全局缓存.浏览器中的 window 对象等. JavaScript ...
- Excel解析工具easyexcel全面探索
1. Excel解析工具easyexcel全面探索 1.1. 简介 之前我们想到Excel解析一般是使用POI,但POI存在一个严重的问题,就是非常消耗内存.所以阿里人员对它进行了重写从而诞生了eas ...
- Html头部meta标签
meta元素有4个属性:name.http-equiv.content.charset.meta标签通过name属性来表述页面文档的元信息,通过http-equiv属性设置http请求指令,通过c ...
- https抓包 Fiddler
打开Fiddler https抓包 安装证书 查看证书 打开Windows程序certmgr.msc 查找Fiddler证书 查看Fiddler证书是否安装成功 测试连接 使用Google Chrom ...
- Google Analytics 学习笔记二 —— GA部署
一.直接部署 直接复制GA跟踪代码 放到所有页面 跟踪代码放到 "head"前面 二.GTM部署方法一 三.GTM部署方法二 Tacking ID 四.测试.参数配置与调优
- 剑指:和为S的连续正数序列
题目描述 输入一个正数 s,打印出所有和为 s 的连续正数序列(至少含有两个数). 例如输入 15,由于 1+2+3+4+5=4+5+6=7+8=15,所以结果打印出 3 个连续序列 1-5.4-6 ...
- 2.监控软件zabbix-服务端安装
环境准备 Zabbix服务端环境要求: Red Hat Enterprise Linux CentOS Oracle Linux Debian Ubuntu 注意,要安装的Zabbix服务器需要联网, ...
- Mybatis使用Mybatis-generator插件及配置(数据库逆向工程)
Mybatis使用Mybatis-generator插件 首先在POM.xml文件添加架包,我这里用的是SpringBoot,所以用的也是SpringBoot架包,最少要mybatis,generat ...