
SQL Server 列存储索引概述
第一次接触ColumnStore是在2017年,数据库环境是SQL Server 2012,Microsoft开始在SQL Server 2012中推广列存储索引,到现在的SQL Server 2017环境,列存储索引发生了很大的变化。
列存储索引是用于查询和存储大型数据仓库事实表的标准方法,它使用基于列的数据存储和查询处理,从而使数据仓库中的查询性能比传统的面向行的存储高出10倍。在未压缩的数据大小上,您还可以获得高达数据压缩10倍的增益。
一,列存储索引的基本概念
列存储索引是指先把数据分组,在每一个分组中,物理实现上按照列来存储数据。
1,列存储、行存储和增量存储
行存储(Row Store):是传统的数据存储格式,物理存储上以行格式来实现。在物理存储上,数据按照行来存储,一行包含所有的数据列。
列存储(Column Store):是指物理存储上以列格式来实现,在物理存储上,各个列单独存储,通过键来关联。列存储索引实际上以列存储格式存储大多数数据,部分数据以行存储格式存储。在列存储格式中,数据以列为单位来压缩和解压缩,在一行数据中,对于需要的数据列进行解压缩和查询,而对于不需要的列,可以忽略,这样可以快速扫描大型表的整个列。
增量存储(Delta Store)是以行存储格式存储的聚集索引,列存储索引会把一些数据存储为行存储格式,这些数据被称为deltastore( 增量存储区),它用于存储在一次插入操作中因为数量太少而无法压缩到列存储中的行,每个增量行组都是通过行版本的聚集B树索引来实现的。
2,行组(Rowgroup)
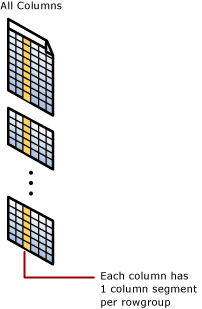
行组是一组同时被压缩为列存储格式的行。为了获得高性能和高压缩率,columnstore索引将表切成行组,然后以列方式压缩每个行组。 行组中的行数必须足够大以提高压缩率,并且必须足够小以受益于内存中操作。
3,列段(column segment)
列段是行组中的每一列构成的数据,对于每一个行组,每一列都有一个列段;每一个列段都压缩到一起,存储到物理设备上。
二,列存储索引架构的基础
聚集列存储索引是整个数据表的物理存储,为了减少列段的碎片并提高性能,columnstore索引可能会将一些数据临时存储到一个称为deltastore的聚集索引中。
deltastore是一个以RowStore格式存储的聚集索引,存储的数据分为两部分:一部分是新增的数据,另一部分是删除的数据。
- 对于新增的数据,该数据逻辑上存在于表中,但是不在列存储中,而是以rowstore格式存储。
- 对于被删除的数据,逻辑上被标记为删除,但是并没有从列存储中删除,也就是说物理上没有删除,deltastore存储被删除的数据行的ID列表。
deltastore用于进行增量存储,该操作在后台进行,对程序是透明的,为了返回正确的查询结果,聚集的列存储索引将列存储和deltastore的查询结果组合在一起,即把deltastore新增的行添加到结果集中,把deltastore中删除的行从结果集中删除,从而得到一个正确的结果。

1,增量行组(Delta Rowgroup)
增量行组是仅与列存储索引一起使用的聚集B树索引,它通过存储行直到行数达到阈值(1,048,576行)然后移入列存储,从而提高了列存储的压缩和性能。
当增量行组达到最大行数时,它将从“打开”状态转换为“关闭”状态。一个名为元组移动器(tuple-mover)的后台进程检查封闭行组。如果该进程找到一个封闭的行组,那么它将压缩增量行组并将其作为COMPRESSED行组存储到列存储中。
在压缩增量行组后,现有的增量行组将转换为TOMBSTONE状态,然后在无引用的情况下由元组移动器删除。
2,增量存储(deltastore)
列存储索引可以具有多个增量行组,所有增量行组统称为增量存储。
在大批量加载数据的期间,大多数行直接进入列存储,而无需通过增量存储。在批量加载结束时,或者执行INSERt操作时,由于插入行的数量太少,无法满足行组的最小大小(102,400行),这些少量的数据行将进入增量存储,而不是列存储。 对于行数少于102,400的小型批量负载,所有行均直接进入deltastore。
3,非聚集列存储索引
非集群列存储索引和集群列存储索引的功能相同,区别在于,非聚集索引是在行存储表上创建的辅助索引,而聚集列存储索引是整个表的主存储。非聚集索引包含基础表中部分或全部行和列的副本,索引被定义为表的一列或多列,并具有过滤行的可选条件。
三,列存储索引的更新
少量的数据加载和插入会直接进入deltastore,当deltastore中的数据行超过102,400行时,后台进程tuple-mover会把数据更新到columnstore中。
1,少量的数据加载和插入会直接进入deltastore
列存储索引不是实时更新的,它通过缓冲区deltastore来提高性能。首先,只有当数据的更新数量超过阈值102,400行时,才会触发列存储索引的更新。
列存储索引一次将至少102,400行压缩到列存储索引中,从而提高了列存储压缩和查询的性能。要以批量方式压缩数据行,columnstore索引会累积少量加载(bulk)和插入,并把数据插入到deltastore中。增量存储操作在后台进行,为了返回正确的查询结果,聚集列存储索引将列存储和增量存储中的查询结果组合在一起。
当行到达时,它们会进入增量存储区:
- 插入INSERT INTO ... VALUES语句。
- 批量加载结束时,它们的数量少于102,400行。
- 更新,每次更新都实现为删除和插入。
增量存储区还存储已删除行的ID列表,这些行已被标记为已删除但尚未从列存储中实际删除。
2,把deltastore中数据更新到columnstore中
每一个delta rowgroup最多存储1,048,576行,当delta rowgroup存储的数据行达到该阈值时,delta rowgroup的状态由OPEN转换为CLOSED,一个名为元组移动器(tuple-mover)的后台进程检查封闭行组。如果该进程找到一个封闭的行组,则将压缩该行组并把其存储到列存储中。压缩增量行组后,现有的增量行组将转换为TOMBSTONE状态,随后在无引用的情况下由元组移动器删除,并将新的压缩行组标记为COMPRESSED状态。
您可以使用ALTER INDEX重建或重新组织索引,以将增量行组强制进入列存储。请注意,如果在压缩过程中存在内存压力,则列存储索引可能会减少压缩的行组中的行数。
四,执行模式
SQL Server数据库引擎使用两种不同的处理模式来处理Transact-SQL语句:
- 行模式执行(Row mode execution)
- 批模式执行(Batch mode execution)
1,行模式执行
行模式执行是与传统数据表一起使用的查询处理方法,其中数据以行格式存储。SQL Server 引擎读取所需行或索引的所有列,SQL Server从读取的每一行中,检索SELECT语句,JOIN谓词或筛选器谓词所引用的结果集所需的列。这种执行模式,会把所需行的所有列都读取出来,即使有些列是不需要的。这种执行模式特别对于查询少量数据特别有效。
2,批模式执行
批处理模式执行用于同时处理多行,因此称为批处理。批处理中的每一列都作为矢量存储在单独的内存区域中,因此批处理模式处理基于矢量。批处理模式还使用针对多核CPU优化的算法,并提高了现代硬件上的内存吞吐量。
批处理模式执行与列存储存储格式紧密集成并进行了优化,批处理模式在可能的情况下对压缩数据进行操作,从而消除了行模式执行所使用的交换运算符,因此,获得了更好的并行性和更快的性能。
当以批处理方式执行查询并访问列存储索引中的数据时,SQL Server 引擎会在列段中同时读取多行,但是SQL Server仅读取结果所需的列,这些列由SELECT语句,JOIN谓词或过滤器谓词引用。
参考文档:
SQL Server 列存储索引概述的更多相关文章
- SQL Server 列存储索引强化
SQL Server 列存储索引强化 SQL Server 列存储索引强化 1. 概述 2.背景 2.1 索引存储 2.2 缓存和I/O 2.3 Batch处理方式 3 聚集索引 3.1 提高索引创建 ...
- SQL Server 列存储索引 第二篇:设计
列存储索引可以是聚集的,也可以是非聚集的,用户可以在表上创建聚集的列存储索引(Clustered Columnstore Index)或非聚集的列存储索引(Nonclustered Columnsto ...
- SQL Server 列存储索引 第三篇:维护
列存储索引分为两种类型:聚集的列存储索引和非聚集的列存储索引,在一个表上只能创建一个聚集索引,要么是聚集的列存储索引,要么是聚集的行存储索引,然而一个表上可以创建多个非聚集索引. 一,创建列存储索引 ...
- SQL Server 列存储索引 第四篇:实时运营数据分析
实时运营数据分析(real-time operational analytics )是指同时在同一张数据表上执行分析处理和业务处理.分析查询主要是对海量数据执行聚合查询,而事务主要是指对数据表进行少量 ...
- 使用Spark加载数据到SQL Server列存储表
原文地址https://devblogs.microsoft.com/azure-sql/partitioning-on-spark-fast-loading-clustered-columnstor ...
- SQL Server 列存储性能调优(翻译)
原文地址:http://social.technet.microsoft.com/wiki/contents/articles/4995.sql-server-columnstore-performa ...
- 解读SQL Server 2014可更新列存储索引——存储机制
概述 SQL Server 2014被号称是微软数据库的一个革命性版本,其性能的提升的幅度是有史以来之最. 可更新的列存储索引作为SQL Server 2014的一个关键功能之一,在提升数据库的查询性 ...
- SQL Server 2012 列存储索引分析(翻译)
一.概述 列存储索引是SQL Server 2012中为提高数据查询的性能而引入的一个新特性,顾名思义,数据以列的方式存储在页中,不同于聚集索引.非聚集索引及堆表等以行为单位的方式存储.因为它并不要求 ...
- SQL Server 2012 列存储索引分析(转载)
一.概述 列存储索引是SQL Server 2012中为提高数据查询的性能而引入的一个新特性,顾名思义,数据以列的方式存储在页中,不同于聚集索引.非聚集索引及堆表等以行为单位的方式存储.因为它并不要求 ...
随机推荐
- 微服务实战系列(二)-注册中心Springcloud Eureka客户端
1. 场景描述 前几天介绍了下springcloud的Eureka注册中心(springcloud-注册中心快速构建),今天结合springboot-web介绍下eureka客户端服务注册. 2. 解 ...
- Burp Suite的安装
安装均在虚拟机环境下进行. 1.首先在浏览器找到java进行最新版本的安装. 2.然后找到burp suite 的安装包下载 不知道这一次 怎么直接跳过安装打开了.
- MMC & SD 发展历史
一.概述 MMC 卡和 SD 卡都是基于 Nand Flash 技术的移动存储卡. MMC(MultiMediaCard) 卡于 1997 年由西门子和 Sandisk 推出,SD (Secure D ...
- Django_项目开始
如何初始Django运行环境? 1. 安装python 2. 创建Django项目专用的虚拟环境 http://www.cnblogs.com/2bjiujiu/p/7365876.html 3.进入 ...
- py004.python的逻辑运算,随机数及判断语句if,elif,else
判断语句又称 "分支语句" if判断语句的格式: if 条件1: 条件1满足时,执行的代码 -- # 前面有缩进4个空格 elif 条件2: 条件2满足时,执行的代码 -- # 前 ...
- 共享内存Distributed Memory 与分布式内存Distributed Memory
我们经常说到的多核处理器,是指一个处理器(CPU)上有多个处理核心(CORE),共享内存多核系统我们可以将CPU想象为一个密封的包,在这个包内有多个互相连接的CORES,每个CORE共享一个主存,所有 ...
- mysql-15-view
#视图 /* 含义:虚拟表,和普通表一样使用.通过表动态生成的数据 只保存了sql逻辑,不保存查询结果 应用场景: 1.多个地方用到同样的查询结果 2.该查询结果使用的sql语句较为复杂 */ USE ...
- Python练习题 049:Project Euler 022:姓名分值
本题来自 Project Euler 第22题:https://projecteuler.net/problem=22 ''' Project Euler: Problem 22: Names sco ...
- Arduino 串口的一些高级用法
来源: 1.配置串口通信数据位.校验位.停止位 通常我们使用Serial.begin(speed)来完成串口的初始化,这种方式,只能配置串口的波特率. 而使用Serial.begin(speed, c ...
- 一、Vuforia_AR
一.AR概念: 增强现实(Augmented Reality,简称AR),是一种将虚拟信息与真实世界巧妙融合的技术,广泛运用了多媒体.三维建模.实时跟踪及注册.智能交互.传感等多种技术手段,将计算机生 ...