
[HDFS_1] HDFS 的概念和特性
0. 参考
1. HDFS 是什么
HDFS :一种分布式文件系统,可提供对应用程序数据的高吞吐量访问,解决海量数据存储问题。
2. HDFS 产生的背景 & 设计前提
随着互联网的发展,数据产生的数量越来越大,速度越来越快。传统的文件系统所依赖的服务器价格昂贵,提高其处理性能成本较高且已达到技术瓶颈,纵向扩展并不符合当今需求。
HDFS 它的设计目标就是把超大的数据集存储到多台普通计算机上(横向扩展),并且可以提供高可靠性和高吞吐量的服务,支持通过添加节点的方式对集群进行扩容。所以 HDFS 有着它自己的设计前提:
对存储大文件支持很好,不适用于存储大量小文件
通过流式访问数据,保证高吞吐量而不是低延时的用户响应
简单一致性,使用场景应为一次写入多次读取,不支持多用户写入,不支持任意修改文件。
冗余备份机制,空间换可靠性(Hadoop3中引入纠删码机制,纠删码需通过计算恢复数据,实为通过时间换空间,有兴趣的可以查看 RAID 的实现)
移动计算优于移动数据,为支持大数据处理主张移动计算优于移动数据,提供相关接口。
3. HDFS 的优缺点
3.1 HDFS 的优点
HDFS 被设计成适合运行在通用和廉价硬件上的分布式文件系统。它和现有的分布式文件系统有很多共同点,但他和其它分布式文件系统的区别也是明显的。HDFS 是基于流式数据模式访问和处理超大文件的需求而开发的,其主要特点如下:
【1. 处理超大文件】
这里的超大文件通常指的是 GB、TB 甚至 PB 大小的文件。通过将超大文件拆分为小的 HDFS,并分配给数以百计、千计甚至万计的的节点,Hadoop 可以很容易地扩展并处理这些超大文件。
【2. 运行于廉价的商用机器集群上】
HDFS 设计对硬件需求比较低,只需运行在低廉的的商用机器集群上,而无须使用昂贵的高可用机器。在设计 HDFS 时要充分考虑数据的可靠性、安全性和高可用性。
【3. 高容错性和高可靠性】
HDFS 设计中就考虑到低廉硬件的不可靠性,一份数据会自动保存多个副本(具体可用设置,通常三个副本),通过增加副本的数量来保证它的容错性。如果某一个副本丢失,HDFS 会自动复制其它机器上的副本。
当然,有可能多个副本都会出现问题,但是 HDFS 保存的时候会自动跨节点和跨机架,因此这种概率非常低,HDFS 同时也提供了各种副本放置策略来满足不同级别的容错需求。
【4. 流式的访问数据】
HDFS 的设计建立在更多低相应 “一次写入,多次读写” 任务的基础上,这意味着一个数据集一旦有数据源生成,就会被复制分发到不同的存储节点中,然后响应各种各种的数据分析任务需求。在多数情况下,分析任务都会涉及数据集的大部分数据,也就是说,对 HDFS 来说,请求读取整个数据集比请求读取单条记录会更加高效。
3.2 HDFS 的缺点
HDFS 的上述种种特点非常适合于大数据量的批处理,但是对于一些特点问题不但没有优势,而且有一定的局限性,主要表现以下几个方面:
【1. 不适合低延迟数据访问】
如果要处理一些用户要求时间比较短的低延迟应用请求(比如毫秒级、秒级的响应时间),则 HDFS 不适合。HDFS 是为了处理大型数据集而设计的,主要是为了达到高的数据吞吐量而设计的,延迟时间通常是在分钟乃至小时级别。
对于那些有低延迟要求的应用程序,HBase 是一个更好的选择,尤其是对于海量数据集进行访问要求毫秒级响应的情况,单 HBase 的设计是对单行或少量数据集的访问,对 HBase 的访问必须提供主键或主键范围。
【2. 无法高效存储大量小文件】
【3. 不支持多用户写入和随机文件修改】
在 HDFS 的一个文件中只有一个写入者,而且写操作只能在文件末尾完成,即只能执行追加操作。
4. HDFS 架构
【HDFS 架构图 】
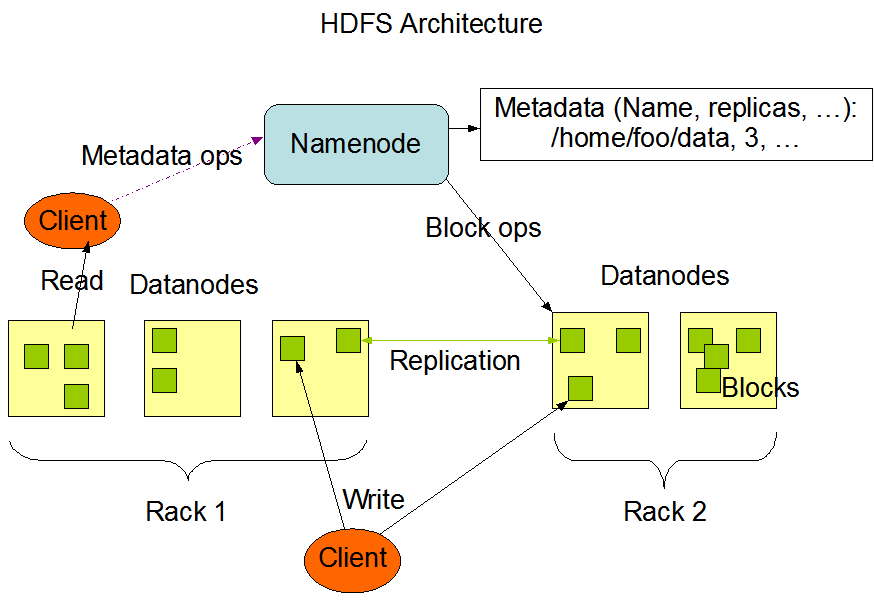
HDFS 负责分布式存储。
HDFS 采用了主从(Master/Slave)的结构模型,一个 HDFS 集群是由一个 NameNode 和若干个 DataNode 组成的。
1. HDFS Client
客户端可以通过一些命令访问 HDFS,通过访问 NameNode 获取文件的元数据信息,与 DataNode 交互读取文件。
客户端同时负责对文件的切分,在文件上传时,客户端将文件切分成Block进行存储。
2. NameNode
NameNode 作为 Master,用于存储文件的元数据信息(文件类型、大小、路径、权限等),它也负责数据块到具体 DataNode 的映射。
NameNode 执行文件系统的命名空间操作,比如打开、关闭、重命名文件或目录等。
3. DataNode
DataNode 作为 Slave,负责处理文件系统客户端的文件读写请求,并在 NameNode 的统一调度下进行数据块的创建、删除和复制工作。
集群中 DataNode 管理存储的数据。HDFS 允许用户以文件的形式存储数据。从内部来看,文件被分成若干数据块,而且这若干个数据块存放在一组 DataNode 上。
4. Secondary NameNode
Secondary NameNode 作为 NameNode 的辅助节点,在 NameNode 无法正常运行的情况下辅助 NameNode 恢复。
他的主要任务是合并 NameNode 的 edit logs 到 fsimage 文件中。
4. HDFS 文件块(Block)的大小
Hadoop1.x 的 HDFS 默认块大小为 64MB;Hadoop2.x 的默认块大小为 128MB。
块大小为什么是128M?
- 机械硬盘寻道时间 10ms
- 寻道时间占用读取时间的 1%
- 读取时间 1s
- 鉴于机械硬盘速度 100M/s ===> 128M //一代的块大小是64M
5. 补充
HDFS 以六十数据访问模式来存储大文件
- 流式访问:从文件头读到文件尾
- 随机访问:在文件的任意位置进行访问
Hadoop 不推荐存储大量的小文件:
- 每一个文件都占用元数据空间,此数据是会在启动时候加载到内存,大量小文件会大大占用 NameNode的内存性能
- 在分布式处理方面,每个小文件都会占用 Yarn 的一个进程资源,所以在处理时会产生非常多的 Yarn 进程,占用内存性能
Hadoop 在同一个文件中同时只能支持一个写入者
[HDFS_1] HDFS 的概念和特性的更多相关文章
- Hadoop_06_Hadoop的HDFS的概念和特性
1.HDFS的概念和特性 1.1. 首先,它是一个文件系统,用于存储文件,通过统一的命名空间——目录树来定位文件 1.2. 它是分布式的,由很多服务器联合起来实现其功能,集群中的服务器有各自的角色:重 ...
- RDD概念、特性、缓存策略与容错
一.RDD概念与特性 1. RDD的概念 RDD(Resilient Distributed Dataset),是指弹性分布式数据集.数据集:Spark中的编程是基于RDD的,将原始数据加载到内存变成 ...
- Hadoop — HDFS的概念、原理及基本操作
1. HDFS的基本概念和特性 设计思想——分而治之:将大文件.大批量文件分布式存放在大量服务器上,以便于采取分而治之的方式对海量数据进行运算分析.在大数据系统中作用:为各类分布式运算框架(如:map ...
- 【转帖】Hadoop — HDFS的概念、原理及基本操作
Hadoop — HDFS的概念.原理及基本操作 https://www.cnblogs.com/swordfall/p/8709025.html 分类: Hadoop undefined 1. HD ...
- DataNode 详解及HDFS 2.X新特性
1. 工作机制 一个数据块在 DataNode 上以文件形式存储在磁盘上,包括两个文件,一个是数据本身,一个是元数据包括数据块的长度,块数据的校验和,以及时间戳. DataNode 启动后向 Name ...
- HDFS的概念
1.数据块 每个磁盘都有默认的数据块大小,这是磁盘进行数据读/写的最小单位.构建于单个磁盘之上的文件系统通过磁盘块来管理该文件系统中的块,该文件系统块的大小可以是磁盘块的整数倍.文件系统快一半为几千字 ...
- 事务(Transaction)概念和特性
http://baike.baidu.com/view/121511.htm 概念 事务(Transaction)是访问并可能更新数据库中各种数据项的一个程序执行单元(unit).事务通常由高级数据库 ...
- IdentityServer的基本概念与特性
基本概念 IdentityServer4是一个基于OpenID Connect和OAuth 2.0的针对ASP.NET Core 2.0的框架. IdentityServer4可以帮助我们实现什么 I ...
- Hadoop 之 HDFS基本概念
1.HDFS的基本概念 答:块(Block).NameNode.DataNode.HDFS的文件被分成块进行存储,默认块的大小为64M,所以说块是文件存储和处理的逻辑单元.NameNode是管理节点, ...
随机推荐
- Beautiful Soup的用法
BEAUTIFUL SOUP的介绍 就是一个非常好用.漂亮.牛逼的第三方库,是用Python写的一个HTML/XML的解析器,它可以很好的处理不规范标记并生成剖析树(parse tree). 它提供简 ...
- Linux_CentOS-服务器搭建 <三> 补充
今天 才发现,服务器上 JDK 都没有好好的安装下.在这里补充说下. 1.看看机子上JDK的安装了多少 $ rpm -qa |grep java 会出现类似: java-1.6.0-openjdk-1 ...
- Spring Cloud Ribbon入门
一.简介 Spring Cloud Ribbon是一个基于Http和TCP的客户端负载均衡工具,它是基于Netflix Ribbon实现的.它不像服务注册中心.配置中心.API网关那样独立部署,但是它 ...
- Velocity常用语法详解
果然公司用的东西跟平时学的东西不太一样,我们公司前台页面并不是我们熟悉的.html或者.jsp文件,而是很多人不知道的 .vm文件,其实只要我们理解了jsp文件,vm文件也就是一些基本语法不同而已. ...
- [AHOI2008] 紧急集合
Description 欢乐岛上有个非常好玩的游戏,叫做"紧急集合".在岛上分散有N个等待点,有N-1条道路连接着它们,每一条道路都连接某两个等待点,且通过这些道路可以走遍所有的等 ...
- [转]完整记录在 windows7 下使用 docker 的过程
本文转自:https://www.jianshu.com/p/d809971b1fc1 借助 docker 可以不在开发电脑中安装环境,比如 nodejs,记录下如何实现. 下载安装 根据自己的电脑系 ...
- [转]window7下利用DockerToolbox安装Docker
本文转自:https://blog.csdn.net/qq2712193/article/details/54576313 版权声明:本文为博主原创文章,未经博主允许不得转载. https://blo ...
- java_完数
题目内容: 一个正整数的因子是所有可以整除它的正整数.而一个数如果恰好等于除它本身外的因子之和,这个数就称为完数.例如6=1+2+3(6的因子是1,2,3). 现在,你要写一个程序,读入两个正整数n和 ...
- 通过swagger将API业务版本号与Gitlab代码版本号绑定
1.调用Gitlab API获取项目commit ID 2.编辑 Swagger2.java @Configuration @EnableSwagger2 @EnableWebMvc public c ...
- Python 利用字典实现类似 java switch case 功能
def add(): print('add') def sub(): print('sub') def exit(): print('exit') choice = { '1' : add, '2' ...