
Adversarial Detection methods
- Kernel Density (KD)
- Local Intrinsic Dimensionality (LID)
- Gaussian Discriminant Analysis (GDA)
- Gaussian Mixture Model (GMM)
- SelectiveNet
- Combined Abstention Robustness Learning (CARL)
- Energy-based Out-of-distribution Detection
- Confidence-Calibrated Adversarial Training: Generalizing to Unseen Attacks (CCAT)
Kernel Density (KD)
作者认为普通样本的特征和对抗样本的特征位于不同的流形中, 故可以通过密度估计的方法, 估计出普通样本的密度函数, 然后求得样本各自的置信度, 选择合适的阈值(通过ROC-AUC之类的), 便有了区分普通样本和对抗样本的方法.
假设
\]
为将样本\(x\)提取为特征\(z\)
- 选取合适的样本数目\(x_1, \cdots, x_N\);
- 提取特征\(z_1, \cdots, z_N\);
- 构建核密度估计函数:
k_{\sigma}(z, z') = \frac{1}{(2\pi)^{\frac{d}{2}}\sigma^d}\exp (-\frac{\|z' - z\|^2}{2\sigma^2}).
\]
选择合适的阈值\(t\), 对于样本\(x\), 判定其为对抗样本, 若\(\hat{f}(x) < t\).
有些时候, 可以对每一类构建一个\(\hat{f}(x)\), 但这个情况也就只能用在ROC-AUC了.
Local Intrinsic Dimensionality (LID)
Gaussian Discriminant Analysis (GDA)
作者假设特征\(z=h(x)\)(所属类别为\(c\))满足后验分布:
\]
即
\]
注意到对于不同的\(c\), 协方差矩阵\(\Sigma\)是一致的(这个假设是为了便于直接用于分类, 但是与detection无关, 便不多赘述).
均值和协方差矩阵通过如下方式估计:
\]
故可以用
\]
来区分\(x\)是否为abnormal的样本(对抗的或者偏离训练分布的样本).
在文中用的是log化(且去掉比例系数)的指标:
\]
改方法可以进一步拓展(实际上光用这个指标看实验结果似乎并不理想):
- Input pre-processing:
对于输入的样本进行如下变换:
\]
有点像fgsm生成对抗样本, 但感觉这么做的原因是让\(\hat{f}(x)\)之间的区别大一点.
- Feature ensemble:
即对不同层的特征\(h_l(x)\)都进行如上的操作, 然后得到\(\hat{f}_1, \cdots, \hat{f}_L\), 并通过SVM来训练得到权重\(\alpha_l\), 最后的score为
\]
注: 文中实际为\(M_l(x)\).
Gaussian Mixture Model (GMM)
类似的, 对于特征\(z=h(x)\), 假设其服从GMM:
\]
并用EM算法来估计.
注: 对每一个类别都需要估计一个GMM模型.
于是
\]
当其小于给定的threshold的时候, 便认为其不属于类别\(c\).
问: 所以当所有的\(c\)都被拒绝的时候, 就可以认为是对抗样本了?
SelectiveNet
本文的模型解释起来有点复杂, 在一个普通的判别网络\(f\)的基础上:
\left \{
\begin{array}{ll}
f(x) & \text{if } g(x) = 1, \\
\text{don't know} & \text{if } g(x) = 0.
\end{array}
\right .
\]
其中\(g\)是一个用来选择是否判断的模块.
作者给出了两个指标:
Coverage:
\]
以及
Selective Risk:
\]
Coverage不能太低, 因为如果全部拒绝判断模型就没有意义了, 然后\(R(f, g)\)自然是越低越好, 但是注意到, 虽然一味拒绝回答能够使得分子接近0, 但是分母也会接近0, 所以需要一个平衡.
二者的经验估计如下:
\phi(g|S_N):= \frac{1}{N}\sum_{i=1}^N g(x_i).
\]
注: 在实际使用中, \(g\)的取值往往在\([0, 1]\)间, 此时可以选取threshold t来选择是否判断.
作者设计了一个结构如下:
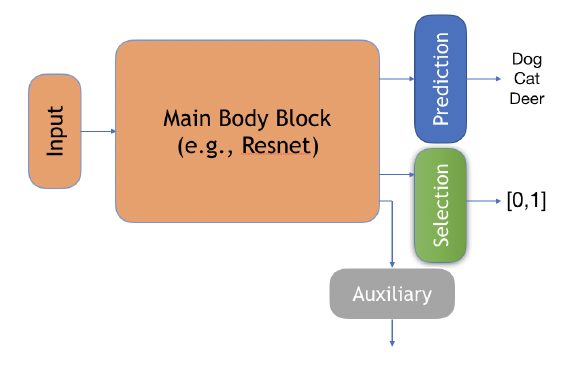
其中:
Prediction: \(f\);
Selection: \(g\);
Auxiliary: \(h\), 作者说此为别的任务来帮助训练的.
最后的损失:
\mathcal{L}_{(f, g)} = \hat{r}_{\ell} (f, g|S_N) + \lambda \Psi(c - \hat{\phi}(g | S_N)) \\
\Psi(a) = \max(0, a)^2 \\
\mathcal{L}_h = \hat{r}(h|S_N) = \frac{1}{N}\sum_{i=1}^N \ell (h(x_i), y_i).
\]
Combined Abstention Robustness Learning (CARL)
假设\(f\)将样本\(x\)映射为\(\mathcal{Y} \bigcup \{a\}\), 其中\(a\)表示弃权(don't know).
则我们可以定义:
\mathcal{R}_{adv}(f) := \mathbb{E}_{(x, y) \sim \mathcal{D}} \max_{\tilde{x} \in \mathcal{B}_{\epsilon}(x)} \mathbf{1}\{f(\tilde{x} \not = y \text{ and } f(\tilde{x}) \not = a\}.
\]
很自然的, 我们可以通过优化下列损失
\]
来获得一个带有弃权功能的判别器. 并且通过权重\(c\)我们可以选择更好的natural精度或者更保守但更加安全的策略.
直接优化上面的损失是困难的, 故选择损失来替换. 作者采用普通的交叉熵损失来代替nat:
\]
用下列之一替代adv:
\ell = \{\ell^{(1)}, \ell^{(2)}\} \\
\ell^{(1)} = -\log (p_y (\tilde{x}) + p_a (\tilde{x})) \\
\ell^{(2)} = (-\log (p_y (\tilde{x})) \cdot (-\log p_a (\tilde{x})) \\
\]
Adversarial Training with a Rejection Option
凸relax.
Energy-based Out-of-distribution Detection
普通的softmax分类网络可以从energy-based model的角度考虑:
E(x, y) = -f_y(x), \\
\]
Helmholtz free energy:
\]
实际上, 通过\(E(x;f)\)我们可以构建\(x\)的能量模型:
\]
故我们可以通过\(p(x)\)来判断一个样本是不是OOD的.
特别的, 由于对于所有的\(x\)
\]
都是一致的, 所以我们只需要比较
\]
的大小就可以了.
特别的, 作者指出为什么用\(p(y|x)\)来作为判断是否OOD的依据不合适:
\log \max_y p(y|x) &= \log \max_y \frac{e^{f_y(x)}}{\sum_i e^{f_i(x)}} \\
&= \log \frac{e^{f_{\max}(x)}}{\sum_i e^{f_i(x)}} \\
&= E(x;f(x) - f^{\max}(x)) \\
&= E(x;f) + f^{max}(x) \\
&= -\log p(x) + f^{max}(x) - \log Z \\
&\not\propto -\log p(x).
\end{array}
\]
WOW!
Confidence-Calibrated Adversarial Training: Generalizing to Unseen Attacks (CCAT)
假设\(f(x)\)为预测的概率向量, CCAT通过如下算法优化:
- 输入: \((x_1, y_1), \cdots, (x_B, y_B)\);
- 将其中一半用于对抗训练, 一半用于普通训练:
\]
- 其中
\tilde{y}_b = \lambda(\delta_b) \text{ one\_hot}(y_b) + (1 - \lambda(\delta_b)) \frac{1}{K}, \\
\delta_b = \mathop{\arg \max} \limits_{\delta_{\infty} \le \epsilon} \max_{k \not= y_b} f_k(x_b + \delta), \\
\lambda (\delta_b) := (1 - \min(1, \frac{\|\delta_b\|_{\infty}}{\epsilon}))^{\rho}. \\
\]
\(\tilde{y}\)是真实标签和均匀分布的一个凸组合, 这个还是挺有道理的.
最后, 倘若如果
\]
即置信度比较小的话, 拒绝判断(这个可靠的原因是目标函数让对抗样本趋于均匀分布).
Adversarial Detection methods的更多相关文章
- 论文解读(ARVGA)《Learning Graph Embedding with Adversarial Training Methods》
论文信息 论文标题:Learning Graph Embedding with Adversarial Training Methods论文作者:Shirui Pan, Ruiqi Hu, Sai-f ...
- [转]Jailbreak Detection Methods
Source: http://blog.spiderlabs.com/2014/10/jailbreak-detection-methods.html Many iOS applications co ...
- 生成对抗网络资源 Adversarial Nets Papers
来源:https://github.com/zhangqianhui/AdversarialNetsPapers AdversarialNetsPapers The classical Papers ...
- CVPR 2011 Global contrast based salient region detection
Two salient region detection methods are proposed in this paper: HC AND RC HC: Histogram based contr ...
- 文本分类实战(七)—— Adversarial LSTM模型
1 大纲概述 文本分类这个系列将会有十篇左右,包括基于word2vec预训练的文本分类,与及基于最新的预训练模型(ELMo,BERT等)的文本分类.总共有以下系列: word2vec预训练词向量 te ...
- Anomaly Detection
数据集中的异常数据通常被成为异常点.离群点或孤立点等,典型特征是这些数据的特征或规则与大多数数据不一致,呈现出“异常”的特点,而检测这些数据的方法被称为异常检测. 异常数据根据原始数据集的不同可以分为 ...
- PP: Time series clustering via community detection in Networks
Improvement can be done in fulture:1. the algorithm of constructing network from distance matrix. 2. ...
- (转) AdversarialNetsPapers
本文转自:https://github.com/zhangqianhui/AdversarialNetsPapers AdversarialNetsPapers The classical Pap ...
- [转]GAN论文集
really-awesome-gan A list of papers and other resources on General Adversarial (Neural) Networks. Th ...
随机推荐
- JuiceFS 性能评估指南
JuiceFS 是一款面向云原生环境设计的高性能 POSIX 文件系统,任何存入 JuiceFS 的数据都会按照一定规则拆分成数据块存入对象存储(如 Amazon S3),相对应的元数据则持久化在独立 ...
- A Child's History of England.23
King William, fearing he might lose his conquest, came back, and tried to pacify the London people b ...
- Ecshop 安装
参考 http://www.68ecshop.com/article-617.html ecshop的安装第一步:下载ecshop网店系统正式版安装包 我们可以来ecshop开发中心的官网(www.6 ...
- mystar01 nodejs MVC 公共CSS,JS设置
mystar01 nodejs MVC gulp 项目搭建 config/express.js中定义别名 //将下载的第三方库添加到静态资源路径当中,方便访问 app.use('/jquery', e ...
- 【Linux】【Services】【Cache】使用Sentinel搭建高可用Redis
1. 简介 1.1. 一些基础概念请参考 http://www.cnblogs.com/demonzk/p/7453494.html 1.2. 几种常用的集群方式. -- Redis Sentinel ...
- Linux:spool命令
格式调整有以下参数: set echo on/off--是否显示脚本中的需要执行的命令 set feedback on/off--是否显示 select 结果之后返回多少行的提示 set linesi ...
- 【JAVA】【Basic】概念
1. 历史 1.1. Sun, Green Project, 90年代初,为机顶盒提供一个统一的语言层,oak-->Java, James Gosling, Sun World 1995:JAV ...
- Springboot,SSM及SSH的概念、优点、区别及缺点
Springboot的概念: 是提供的全新框架,使用来简化Spring的初始搭建和开发过程,使用了特定的方式来进行配置,让开发人员不在需要定义样板化的配置.此框架不需要配置xml,依赖于像MAVEN这 ...
- 【C/C++】习题3-4 周期串/算法竞赛入门经典/数组和字符串
[题目] 如果某个字符串可以由长度为k的字符串重复多次得到,则称该串以k为周期. 输入一个长度不超过80的字符串,输出最小周期. [思路] 暴力求解.依次考察周期1~长度n. 筛选:周期一定是长度n的 ...
- [PROC FREQ] 单组率置信区间的计算
本文链接:https://www.cnblogs.com/snoopy1866/p/15674999.html 利用PROC FREQ过程中的binomial语句可以很方便地计算单组率置信区间,SAS ...