
flink---实时项目--day01--1. openrestry的安装 2. 使用nginx+lua将日志数据写入指定文件中 3. 使用flume将本地磁盘中的日志数据采集到的kafka中去
1. openrestry的安装
OpenResty = Nginx + Lua,是⼀一个增强的Nginx,可以编写lua脚本实现⾮非常灵活的逻辑
(1)安装开发库依赖
yum install -y pcre-devel openssl-devel gcc curl
(2)配置yum的依赖源
yum install yum-utils

yum-config-manager --add-repo https://openresty.org/package/centos/openresty.repo
(3)安装OpenResty
yum install openresty
安装过程中出现问题的解决办法
cd /etc/yum.repos.d

yum install wget

wget  https://openresty.org/package/centos/openresty.repo

vi openresty.repo

将https改成http(改两个地方)

yum install openresty
(4)openresty的默认安装⽬目录
/usr/local/openresty
(5)启动openresty(Nginx)
/usr/local/openresty/nginx/sbin/nginx
(6)通过浏览器器查看nginx的⻚页⾯面
2. 使用nginx+lua将日志数据写入指定文件中
需求:访问某个地址,nginx页面只显示1*1像素的空图片,然后将日志记录到指定的文件中去
(1)创建存放日志的目录并设置权限
mkdir /logs

chmod o+w /logs
为什么要设置权限呢,因为往logs的access.log文件写日志数据的用户是nobody,如下

(2)vi nginx.conf
location /log.gif{

            #伪装成gif文件

            default_type 'image/gif';

            #关闭access_log

            access_log off;

            # 使用lua将nginx接受的参数写入到日志文件中

            log_by_lua_file 'conf/log.lua';

            #返回空图片

            empty_gif;

        }
(3)在nginx的conf⽬目录下创建⼀一个log.lua⽂文件
vi /usr/local/openresty/nginx/conf/log.lua
log.lua脚本内容如下
-- 引⼊入lua所有解析json的库

local cjson = require "cjson"

-- 获取请求参数列列表

local request_args_tab = ngx.req.get_uri_args()

-- 使⽤用lua的io打开⼀一个⽂文件,如果⽂文件不不存在,就创建,a为append模式

local file = io.open("/logs/access.log", "a")

-- 定义⼀一个json对象

local log_json = {}

-- 将参数的K和V迭代出来,添加到json对象中

for k, v in pairs(request_args_tab) do

log_json[k] = v

end

-- 将json写⼊入到指定的log⽂文件,末尾追加换⾏行行

file:write(cjson.encode(log_json), "\n")

-- 将数据写⼊入

file:flush()
(4)在浏览器上请求feng05/log.gjf,能发现数据写入了/logs/access.log

上诉做法存在一个问题:如果一直往一个⽂件中写入数据,这个日志文件会过大,造成读写效率变低,现在按照小时生成文件
log.lua脚本内容修改如下所示
-- 引⼊入lua⽤用来解析json的库

local cjson = require "cjson"

-- 获取请求参数列列表

local request_args_tab = ngx.req.get_uri_args()

-- 获取当前系统时间

local time = os.date("%Y%m%d%H",unixtime)

-- 使⽤用lua的io打开⼀一个⽂文件,如果⽂文件不不存在,就创建,a为append模式

local path = "/mylog/access-" .. time .. ".log"

local file = io.open(path, "a")

-- 定义⼀一个json对象

local log_json = {}

-- 将参数的K和V迭代出来,添加到json对象中

for k, v in pairs(request_args_tab) do

log_json[k] = v

end

-- 将json写⼊入到指定的log⽂文件,末尾追加换⾏行行

file:write(cjson.encode(log_json), "\n")

-- 将数据写⼊入

file:flush()
这样就会按照时间滚动生成日志文件了
3. 使用flume将本地磁盘中的日志数据采集到的kafka中去
此处数据采集的架构为flume+kafka(taildir+kafkachannel), 这样既能实现负载均衡又能使用高可用
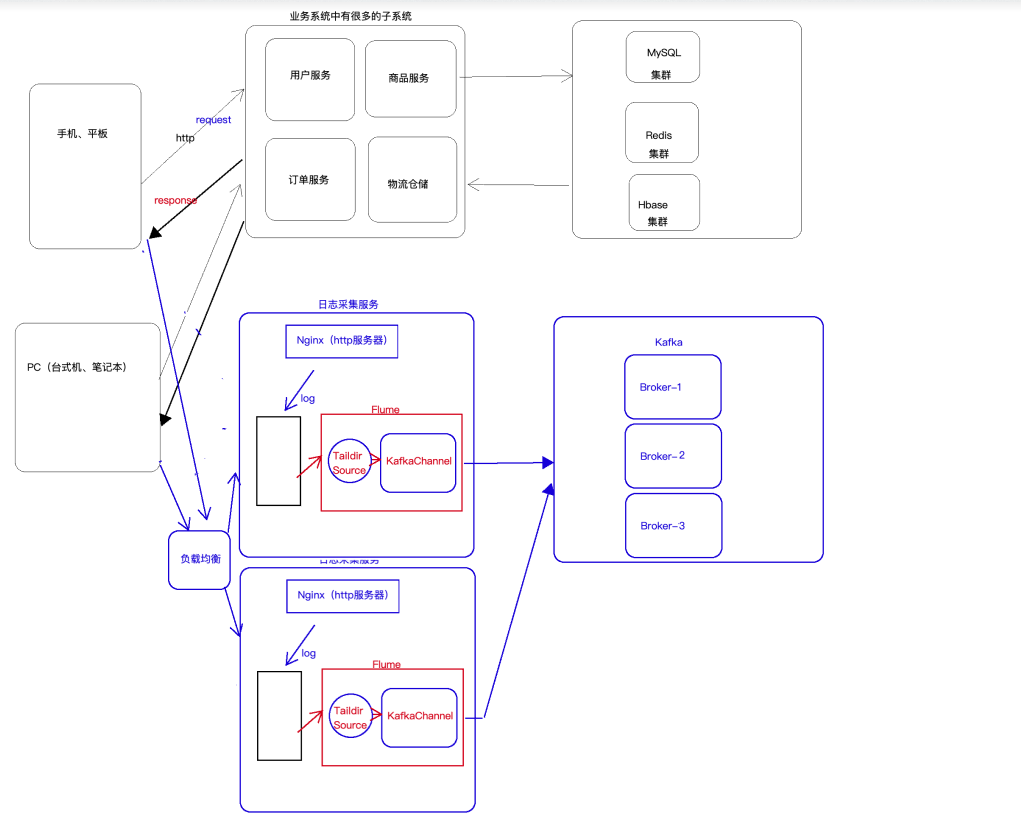
flume采集数据的配置文件如下所示:nginx-kafka.conf


a1.sources = r1

a1.channels = c1

a1.sources.r1.type = TAILDIR

a1.sources.r1.positionFile = /root/taildir_position.json    //此处表示taildir采集的记录,即偏移量

a1.sources.r1.filegroups = f1

a1.sources.r1.filegroups.f1 = /log/access-.*\.log

a1.channels.c1.type = org.apache.flume.channel.kafka.KafkaChannel

a1.channels.c1.kafka.bootstrap.servers = feng05:9092,feng06:9092,feng07:9092

a1.channels.c1.kafka.topic = access12

a1.channels.c1.parseAsFlumeEvent = false

a1.sources.r1.channels = c1
运行flume进行采集,数据即可采集至kafka中,命令如下
/usr/apps/apache-flume-1.9.0-bin/bin/flume-ng agent -n a1 -c conf \

-f myconf/nginx-kafka.conf \

-Dflume.root.logger=INFO,console

/usr/apps/kafka_2.11-2.4.0/bin/kafka-console-consumer.sh --bootstrap-server feng05:9092 --topic access --from-beginning
flink---实时项目--day01--1. openrestry的安装 2. 使用nginx+lua将日志数据写入指定文件中 3. 使用flume将本地磁盘中的日志数据采集到的kafka中去的更多相关文章
- PHP将数据写入指定文件中
首先创建一个空的txt文件,这里我们创建了一个1.txt的空文件. 第一种方法:fwrite函数 <?php $file=fopen('1.txt','rb+'); var_dump(fwrit ...
- 程序一 用记事本建立文件src.dat,其中存放若干字符。编写程序,从文件src.dat中读取数据,统计其中的大写字母、小写字母、数字、其它字符的个数,并将这些数据写入到文件test.dat中。
用记事本建立文件src.dat,其中存放若干字符.编写程序,从文件src.dat中读取数据,统计其中的大写字母.小写字母.数字.其它字符的个数,并将这些数据写入到文件test.dat中. #inclu ...
- Python:将爬取的网页数据写入Excel文件中
Python:将爬取的网页数据写入Excel文件中 通过网络爬虫爬取信息后,我们一般是将内容存入txt文件或者数据库中,也可以写入Excel文件中,这里介绍关于使用Excel文件保存爬取到的网页数据的 ...
- 10.Flink实时项目之订单维度表关联
1. 维度查询 在上一篇中,我们已经把订单和订单明细表join完,本文将关联订单的其他维度数据,维度关联实际上就是在流中查询存储在 hbase 中的数据表.但是即使通过主键的方式查询,hbase 速度 ...
- 1.Flink实时项目前期准备
1.日志生成项目 日志生成机器:hadoop101 jar包:mock-log-0.0.1-SNAPSHOT.jar gmall_mock |----mock_common |----mock ...
- 5.Flink实时项目之业务数据准备
1. 流程介绍 在上一篇文章中,我们已经把客户端的页面日志,启动日志,曝光日志分别发送到kafka对应的主题中.在本文中,我们将把业务数据也发送到对应的kafka主题中. 通过maxwell采集业务数 ...
- 3.Flink实时项目之流程分析及环境搭建
1. 流程分析 前面已经将日志数据(ods_base_log)及业务数据(ods_base_db_m)发送到kafka,作为ods层,接下来要做的就是通过flink消费kafka 的ods数据,进行简 ...
- 4.Flink实时项目之数据拆分
1. 摘要 我们前面采集的日志数据已经保存到 Kafka 中,作为日志数据的 ODS 层,从 kafka 的ODS 层读取的日志数据分为 3 类, 页面日志.启动日志和曝光日志.这三类数据虽然都是用户 ...
- 6.Flink实时项目之业务数据分流
在上一篇文章中,我们已经获取到了业务数据的输出流,分别是dim层维度数据的输出流,及dwd层事实数据的输出流,接下来我们要做的就是把这些输出流分别再流向对应的数据介质中,dim层流向hbase中,dw ...
随机推荐
- 牛客网 剑指Offer 索引
二维数组中的查找 替换空格 从尾到头打印链表 重建二叉树 用两个栈实现队列 旋转数组的最小数字 斐波那契数列 跳台阶 变态跳台阶 矩形覆盖 二进制中1的个数 数值的整数次方 调整数组顺序使奇数位于偶数 ...
- Luogu P1196 [NOI2002]银河英雄传说 | 并查集
题目链接 并查集,具体看注释. #include<iostream> #include<cstdio> #include<cmath> using namespac ...
- redis的一般使用和常规配置
https://www.cnblogs.com/HTLucky/p/12027889.html Redis(全称:Remote Dictionary Server 远程字典服务)是一个开源的使用ANS ...
- 『学了就忘』Linux基础命令 — 25、文件基本权限的管理
目录 1.文件和目录的默认权限 2.umask默认权限 (1)查看系统的umask权限 (2)用八进制数值显示umask权限 (3)umask权限的计算方法 (4)注意:umask默认权限的计算绝不是 ...
- 重装系统——联想window 10
大四了,读了四年大学,唉,混的,啥也不会,工作也找不到,真的不知道这大学四年到底干了什么.专业是计算机方向的,但居然,不敢,也不会装电脑系统,大学四年的文件都是乱放的,更那个的是,有些软件卸载不完全, ...
- uni-app视频组件设置圆角
无法实现,建议写个image在中间位置加个播放按钮,点击播放跳转新页面只需要在跳转参数里面把视频链接加上,在onLoad里面获取视频链接,自动播放视频,很多app目前都是这样做的,关闭页面后视频会自动 ...
- 常用的package.json以及React相关
常用的package.json以及React相关 前言 package.json 的简单介绍 简单版的 package.json 必备属性(name & version) name 字段 ve ...
- Are we ready for learned cardinality estimation?
Are we ready for learned Cardinality Estimation 摘要 文章包括三大部分: 对于一个静态的数据库,本文将五种基于学习的基数估计方法与九中传统的基数估计方法 ...
- vue中this.$set的用法
之前了解这个方法的时候,感觉这一辈子也用不到这个方法,因为当时没有应用场景,但是还真有用的时候,我相信你们也有用到时候. 从三个方面给大家说一下这个this.$set: 1.this.$set实现什么 ...
- 常见的yaml写法-CronJob
CronJob其实就是在Job的基础上加上了时间调度,我们可以:在给定的时间点运行一个任务,也可以周期性地在给定时间点运行.这个实际上和我们Linux中的crontab就非常类似了.一个CronJob ...