
最大匹配算法 (Maximum Matching)
之所以研究这个算法,是因为最近在研究NLP中文的分词,所谓分词就是将一个完整的句子,例如“计算语言学课程有意思”,分解成一些词组单元“计算语言学,课程,有,意思”。 “最大匹配法” 在中文分词中有所应用,因此这里介绍一下。
“最大匹配法” 分为正向匹配和逆向匹配,这里先看正向匹配。
算法思想:
正向最大匹配算法:从左到右将待分词文本中的几个连续字符与词表匹配,如果匹配上,则切分出一个词。但这里有一个问题:要做到最大匹配,并不是第一次匹配到就可以切分的 。我们来举个例子:
待分词文本: sentence[]={"计","算","语","言","学","课","程","有","意","思"}
词表: dict[]={"计算", "计算语言学", "课程", "有", "意思"} (真实的词表中会有成千上万个已经平时我们使用的分好的词语)
(1) 从sentence[1]开始,当扫描到sentence[2]的时候,发现"计算"已经在词表dict[]中了。但还不能切分出来,因为我们不知道后面的词语能不能组成更长的词(最大匹配)。
(2) 继续扫描content[3],发现"计算语"并不是dict[]中的词。但是我们还不能确定是否前面找到的"计算语"已经是最大的词了。因为"计算语"是dict[2]的前缀。
(3) 扫描content[4],发现"计算语言"并不是dict[]中的词。但是是dict[2]的前缀。继续扫描:
(3) 扫描content[5],发现"计算语言学"是dict[]中的词。继续扫描下去:
(4) 当扫描content[6]的时候,发现"计算语言学课"并不是词表中的词,也不是词的前缀。因此可以切分出前面最大的词——"计算语言学"。
由此可见,最大匹配出的词必须保证下一个扫描不是词表中的词或词的前缀才可以结束。
代码实现:
这里字典就临时这样简单写死,真实的情况需要构造一个hash,这样效率较高,我们看下算法的代码吧:
#include<iostream>

#include<string>

using namespace std;

// 宏,计算数组个数

#define GET_ARRAY_LEN(array,len){len=(sizeof(array)/sizeof(array[0]));}

string dict[] = {"计算", "计算语言学", "课程", "有", "意思"};

// 是否为词表中的词或者是词表中词的前缀

bool inDict(string str)

{

    bool res = false;

    int i;

    int len = ;

    GET_ARRAY_LEN(dict, len);

    for (i = ; i<len; i++)

    {

        // 是否和词表词相等或者是词表词前缀

        if( str == dict[i].substr(, str.length()))

        {

            res = true;

        }

    }

    return res;

}

int main()

{

    string sentence = "计算语言学课程有意思";

    string word = "一";

    int wordlen = word.length();

    int i;

    string s1 = "";

    for (i = ; i<sentence.length(); i = i+wordlen)

    {

        string tmp = s1 + sentence.substr(i, wordlen);

        if(inDict(tmp))

        {

            s1 = s1 + sentence.substr(i, wordlen);

        }

        else

        {

            cout<<"分词结果:"<<s1<<endl;

            s1 = sentence.substr(i, wordlen);

        }

    }

    cout<<"分词结果:"<<s1<<endl;

}
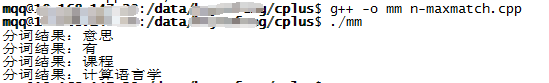
我在linux下运行的结果是:

可以看到分词的结果符合我们的预期,如果词表足够大,那么所有的句子都可以被分词。iao
接下来说下逆向的最大匹配算法。
算法思想:
逆向匹配算法大致思路是从右往左开始切分。我们还是用上面的例子:
待分词句子: sentence[]={"计算语言学课程有意思"}
词表: dict[]={"计算", "计算语言学", "课程", "有", "意思"}
首先我们定义一个最大分割长度5,从右往左开始分割:
(1) 首先取出来的候选词W是 “课程有意思”。
(2) 查词表,W不在词表中,将W最左边的第一个字去掉,得到W“程有意思”;
(3) 查词表,W也不在词表中,将W最左边的第一个字去掉,得到W“有意思”;
(4) 查词表,W也不在词表中,将W最左边的第一个字再去掉,得到W“意思”;
(5) 查词表,W在词表中,就将W从整个句子中拆分出来,此时原句子为“计算语言学课程有”
(6) 根据分割长度5,截取句子内容,得到候选句W是“语言学课程有”;
(7) 查词表,W不在词表中,将W最左边的第一个字去掉,得到W“言学课程有”;
(8) 查词表,W也不在词表中,将W最左边的第一个字去掉,得到W“学课程有”;
(9) 依次类推,直到W为“有”一个词的时候,这时候将W从整个句子中拆分出来,此时句子为“计算语言学课程”
(10) 根据分割长度5,截取句子内容,得到候选句W是“算语言学课程”;
(11) 查词表,W不在词表中,将W最左边的第一个字去掉,得到W“语言学课程”;
(12) 依次类推,直到W为“课程”的时候,这时候将W从整个句子中拆分出来,此时句子为“计算语言学”
(13) 根据分割长度5,截取句子内容,得到候选句W是“计算语言学”;
(14) 查词表,W在词表,分割结束。
代码实现:
#include<iostream>

#include<string>

using namespace std;

// 宏,计算数组个数

#define GET_ARRAY_LEN(array,len){len=(sizeof(array)/sizeof(array[0]));}

// 定义最大词长

#define MAX_WORD_LENGTH 5

string dict[] = {"计算", "计算语言学", "课程", "意思"};

// 是否为词表中的词

bool inDict(string str)

{

    bool res = false;

    int i;

    int len = ;

    GET_ARRAY_LEN(dict, len);

    for (i = ; i<len; i++)

    {

        if( str == dict[i])

        {

            res = true;

        }

    }

    return res;

}

int main()

{

    string sentence = "计算语言学课程有意思";

    string word = "一";

    int wordlen = word.length();

    int i;

    for (i = ; i<sentence.length(); )

    {

        int dealstrbegin = sentence.length()-wordlen*MAX_WORD_LENGTH-i;

        int dealstrlen = wordlen*MAX_WORD_LENGTH;

        // 截取的要处理的字符串

        string dealstr = sentence.substr(dealstrbegin, dealstrlen);

        int j;

        for (j = ; j<MAX_WORD_LENGTH; j++)

        {

            int fb = j*wordlen;

            int fl = wordlen*(MAX_WORD_LENGTH-j);

            // 去掉签名的j个字

            string tmp = dealstr.substr(fb, fl);

            if(inDict(tmp) || j==MAX_WORD_LENGTH- )

            {

                cout<<"分词结果:"<<tmp<<endl;

                i=i+fl;

                break;

            }

        }

    }

}
代码运行的结果是:
最大匹配算法 (Maximum Matching)的更多相关文章
- [Codeforces Round #508 (Div. 2)][Codeforces 1038E. Maximum Matching]
前几天给舍友讲这题的时候感觉挺有意思的,就贴上来吧... 题目链接:1038E - Maximum Matching 题目大意:有\(n\)个棒子,每个条两端有颜色\(c1,c2\)以及他的价值\(v ...
- Codeforces 1038 E - Maximum Matching
E - Maximum Matching 思路: 欧拉图 定理:一个度数为奇数的点的个数小于等于2的联通图存在欧拉回路 对于这道题目的图,点的个数为4,所以最坏的情况下4个点的度数都为奇数,在这种情况 ...
- Codeforces Round #508 (Div. 2) E. Maximum Matching(欧拉路径)
E. Maximum Matching 题目链接:https://codeforces.com/contest/1038/problem/E 题意: 给出n个项链,每条项链左边和右边都有一种颜色(范 ...
- [codeforces 508E]Maximum Matching
题目:Maximum Matching 传送门:http://codeforces.com/contest/1038/problem/E 分析: 一个块拥有{color1,val,color2},两个 ...
- SPOJ4206Fast Maximum Matching(hopcroft-karp)
题目请戳这里 题目大意:裸的二分匹配. 题目分析:数据比较强,用来测模版的.这题用hungry跑着会比较吃力,所以用hopcroft-karp算法.这个算法较hungry高效是因为每次bfs找到一个增 ...
- SPOJ 4206 Fast Maximum Matching (二分图最大匹配 Hopcroft-Carp 算法 模板)
题目大意: 有n1头公牛和n2头母牛,给出公母之间的m对配对关系,求最大匹配数.数据范围: 1 <= n1, n2 <= 50000, m <= 150000 算法讨论: 第一反应 ...
- CF1038E Maximum Matching 搜索/区间DP
题目传送门:http://codeforces.com/problemset/problem/1038/E 题意:给出$N$个方块,每个方块有左右两种颜色$a,b$(可以翻转使左右两种颜色交换)和一个 ...
- CF#508 1038E Maximum Matching
---题面--- 题解: 感觉还是比较妙的,复杂度看上去很高(其实也很高),但是因为n只有100,所以还是可以过的. 考虑一个很暴力的状态f[i][j][x][y]表示考虑取区间i ~ j的方格,左右 ...
- Codeforces 1038E Maximum Matching
可能写了个假算法 假设定义:含有一个欧拉路的图为类欧拉图 欧拉路的定义:一个无向连通图中,存在一条路径对所有边都遍历且仅遍历一次:判断方法:该连通图中度为奇数的点的个数不能超过2,即为0或者2 题目解 ...
随机推荐
- Lua的table库函数insert、remove、concat、sort详细介绍(转载)
函数列表: table.insert(table,[ pos,] value) table.remove(table[, pos]) table.concat(table[, sep[, i[, j] ...
- 找不到resources下的文件
今天发现一个很坑的问题,浪费了很长的时间排查问题,特此记录下.目录结构如下图所示: 结果加载文件的时候,一直报错: 找不到resource文件夹下的 conf/mybatis/logDb/ 路径下的文 ...
- git服务器-------》用户免密git操作
找到/etc/ssh/sshd_config文件 开启 RSAAuthentication yesPubkeyAuthentication yesAuthorizedKeysFile .ss ...
- JavaScript常用算法
一.排序算法 1.Array.sort(function)(JavaScript原生排序算法)参数:比较函数(可选)若无参数,则按照首字母的ASCII码排序,比较函数的作用为确定排序 function ...
- linux及安全第三周总结——20135227黄晓妍
总结部分: Linux内核源代码: Arch 支持不同cpu的源代码:主要关注x86 Init 内核启动的相关代码:主要关注main.c,整个Linux内核启动代码start_kernel函数 K ...
- react native 0.56.0版本在windows下有bug不能正常运行
react native的0.56.0版本在windows下有bug不能正常运行请init 0.55.4的版本 react-native init MyApp --version 0.55.4 注意v ...
- 从零开始玩转JMX(二)——Condition
Notification 一个MBean提供的管理接口允许代理对其管理资源进行控制和配置.然而,对管理复杂的分布式系统来说,这些接口知识提供了一部分功能.通常,管理应用程序需要对状态变化或者当特别情况 ...
- python的socket的tcp协议编程
服务端代码如下: # _*_ coding:utf-8 _*_import socketimport datetimeHOST='0.0.0.0'PORT=3434 s=socket.socket(s ...
- CentOS7下安装VLC
用最新的CentOS7发现没有视频播放器,于是在http://pkgs.org/上查找,发现了nux dextop仓库上有,于是到他的官网上http://li.nux.ro/repos.html查了下 ...
- DataStage系列教程 by Bluebreeze
突发奇想,用了这么久的DataStage,想要写点东西祭奠那逝去的岁月.希望可以坚持一直写完. DataStage系列教程 (Change Capture) DataStage系列教程 (Pivot_ ...