
[爬虫]用python的requests模块爬取糗事百科段子
虽然Python的标准库中 urllib2 模块已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 “HTTP for Humans”,说明使用更简洁方便。Requests 继承了urllib2的所有特性。Requests支持HTTP连接保持和连接池,支持使用cookie保持会话,支持文件上传,支持自动确定响应内容的编码,支持国际化的 URL 和 POST 数据自动编码。
爬取糗事百科网站https://www.qiushibaike.com/段子,需要分两步解析数据的过程。首先将html页面整体爬下来,然后再利用正则将不需要字符过滤。
第一步解析:
re.compile('<div class="content">.*?</div>', re.S) # 匹配出包含段子的标签
第二步解析:
re.compile(r'<.*?>|&(.*?);|\s| ') # 将除了汉字以外的所有字符去掉
整体代码为:
 # -*- coding:utf-8 -*-

 #  2018/9/13  12:00

 import requests

 import re

 import time

 from requests.packages.urllib3.poolmanager import PoolManager

 from requests.packages.urllib3.exceptions import InsecureRequestWarning,InsecurePlatformWarning

 requests.packages.urllib3.disable_warnings(InsecureRequestWarning)

 requests.packages.urllib3.disable_warnings(InsecurePlatformWarning)

 class Qiubai_spider(object):

     """糗事百科段子爬虫"""

     def __init__(self):

         self.base_url = "https://www.qiushibaike.com/hot/"

         self.headers = {"User-Agent" : "Mozilla/5.0 (Windows NT 10.0; WOW64; Trident/7.0; rv:11.0) like Gecko"}

         self.analysis_pattern = re.compile('<div class="content">.*?</div>', re.S)

         self.analysis_pattern_t = re.compile(r'<.*?>|&(.*?);|\s|  ')

     # 第一次解析 <div class ="content" >(.*?)</div>

     def send_request(self, url):

         """发送请求"""

         time.sleep(2)

         try:

             response = requests.get(url, headers=self.headers)

             return response.content

         except Exception, err:

             print err

     def write_file(self, data, page):

         """写入数据"""

         with open('qiushiduanzi1.txt', 'a') as f:

             filename = "第" + str(page) + "页的段子\n"

             print  filename

             f.write(filename)

             for content in data:

                 second_data = self.analysis_pattern_t.sub('', content)

                 f.write(second_data)

                 f.write("\n\n\n")

     def analysis_data(self, data):

         """数据分析提取"""

         analysis_list = self.analysis_pattern.findall(data)

         return analysis_list

     def start_work(self):

         """启动爬虫流程"""

         for page in range(1, 10):

             # 拼接url

             url = self.base_url + "page/" + str(page) + '/' + '.html'

             # 发送请求

             data = self.send_request(url)

             # 解析数据

             analysis_db = self.analysis_data(data)

             # 写入数据

             self.write_file(analysis_db, page)

 if __name__ == '__main__':

     tool = Qiubai_spider()

     tool.start_work()
糗事爬虫代码
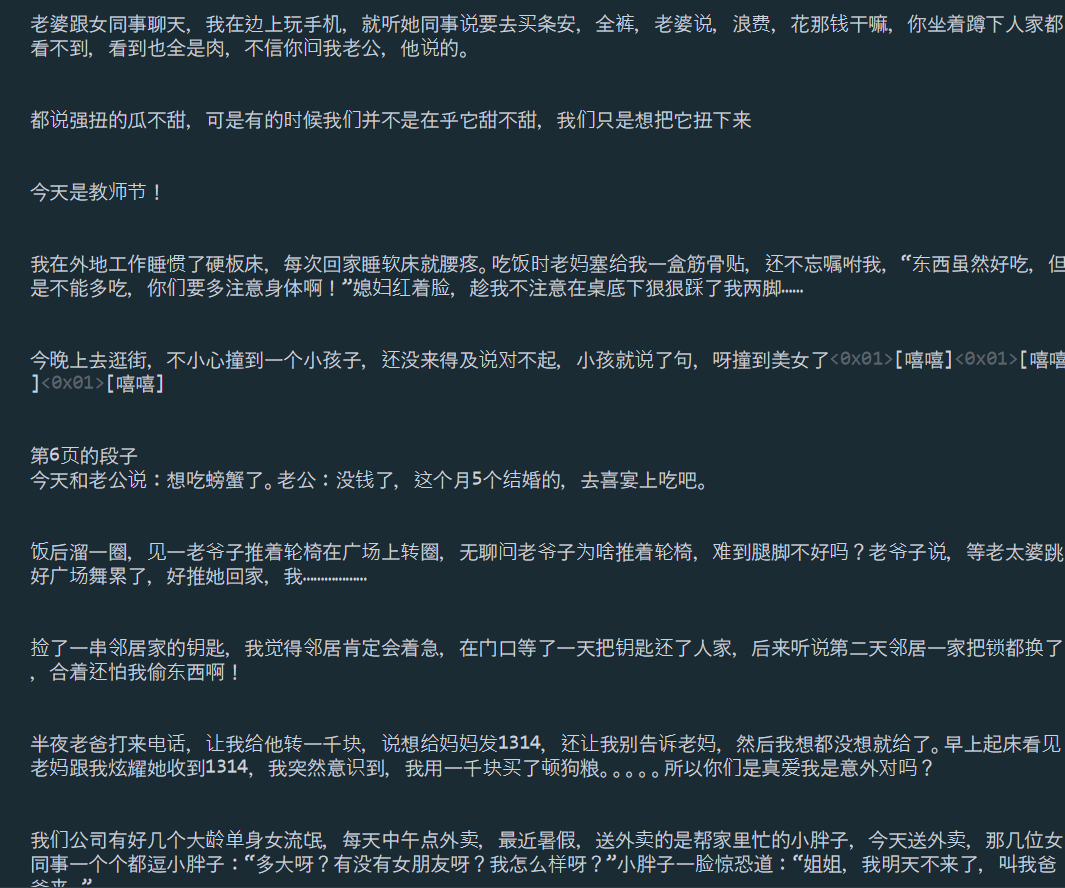
爬取后的效果:
[爬虫]用python的requests模块爬取糗事百科段子的更多相关文章
- 爬虫——URL模块爬取糗事百科段子
最简单的爬取网页找有用信息,难点应该是正则锁定有用信息部分,看了一些其他大神的正则,最后还是决定按照自己理解写一个,果然我头脑相对简单,写出来的粗糙而易理解,也完成了自己想要的需求,就这样了~ # - ...
- Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- 转 Python爬虫实战一之爬取糗事百科段子
静觅 » Python爬虫实战一之爬取糗事百科段子 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致 ...
- python学习(十六)写爬虫爬取糗事百科段子
原文链接:爬取糗事百科段子 利用前面学到的文件.正则表达式.urllib的知识,综合运用,爬取糗事百科的段子先用urllib库获取糗事百科热帖第一页的数据.并打开文件进行保存,正好可以熟悉一下之前学过 ...
- 8.Python爬虫实战一之爬取糗事百科段子
大家好,前面入门已经说了那么多基础知识了,下面我们做几个实战项目来挑战一下吧.那么这次为大家带来,Python爬取糗事百科的小段子的例子. 首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把 ...
- Python爬虫爬取糗事百科段子内容
参照网上的教程再做修改,抓取糗事百科段子(去除图片),详情见下面源码: #coding=utf-8#!/usr/bin/pythonimport urllibimport urllib2import ...
- python爬取糗事百科段子
初步爬取糗事百科第一页段子(发布人,发布内容,好笑数和评论数) #-*-coding:utf--*- import urllib import urllib2 import re page = url ...
- 芝麻HTTP:Python爬虫实战之爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- python 爬虫实战1 爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 本篇目标 抓取糗事百科热门段子 过滤带有图片的段子 实现每按一次回车显示一个段子的发布时间,发布人 ...
随机推荐
- JavaScript系列:高级函数篇
前言: 本篇主要是介绍 JavaScript使用函数的高级方法,函数是JavaSCript中最有趣的部分,利用Function特性可以编写出很多非常有意思的代码,本篇主要包括:函数回调,高阶函数以及函 ...
- FTP协议的主动模式和被动模式的区别
最近准备做一个<FtpCopy系列教程>,主要讲解Ftp协议主动模式和被动模式的区别.以及FTP服务器的安装部署,然后通过几个常用实例演示,详细讲解如何使用FtpCopy进行数据自动备份. ...
- github仓库添加MIT许可
俩种方法 1.新建仓库 直接在选择添加即可如下图: 2.为已创建仓库后添加MIT协议 直接在给工程根目录添加LICENSE文件提交即可,内容是 MIT License Copyright (c) 年份 ...
- Z-buffer算法
1.Z缓冲区(Z-Buffer)算法 1973年,犹他大学学生艾德·卡姆尔(Edwin Catmull)独 立开发出了能跟踪屏幕上每个像素深度的算法 Z-buffer Z-buffer让计算机生成复杂 ...
- 最简单的ArcGIS Engine应用程序(中)
上一篇中只能添加代码中指定的shp文件(最简单的ArcGIS Engine应用程序(上)) 为了让用户可以浏览磁盘加载指定的shp文件,需做一下调整. 从工具箱往窗体上添加一个OpenFileDial ...
- Bran的内核开发教程(bkerndev)-06 全局描述符表(GDT)
全局描述符表(GDT) 在386平台各种保护措施中最重要的就是全局描述符表(GDT).GDT为内存的某些部分定义了基本的访问权限.我们可以使用GDT中的一个索引来生成段冲突异常, 让内核终止执行异 ...
- 洛谷P1608 路径计数
题目简介 题目描述 给你一个N点M边的有向图,求第一个点到第n个点的最短路和最短路条数 题目分析 很明显直接Dijkstra求最短路,加一个最短路计数 如下: if(dis[y]>dis[x]+ ...
- 从源码的角度彻底搞懂 HandlerMapping 和 HandlerAdapter
彻底搞懂 HandlerMapping和HandlerAdapter 知识点的回顾: 当Tomcat接收到请求后会回调Servlet的service方法,一开始入门Servlet时,我们会让自己的Se ...
- Oracle报错注入总结
0x00 前言 在oracle注入时候出现了数据库报错信息,可以优先选择报错注入,使用报错的方式将查询数据的结果带出到错误页面中. 使用报错注入需要使用类似 1=[报错语句],1>[报错语句], ...
- PHP array_slice
1.函数的作用:返回数组中的部分区间的元素 2.函数的参数: @params array $array @params int $offset @params int $l ...