
Python 爬虫从入门到进阶之路(十五)
之前的文章我们介绍了一下 Python 的 json 模块,本章我们就介绍一下之前根据 Xpath 模块做的爬取《糗事百科》的糗事进行丰富和完善。
在 Xpath 模块的爬取糗百的案例中我们只是爬取了其中的糗事,然后存储到本地,并没有作者姓名,头像等信息,所有我们通过之前介绍的 path 模块讲获取到的完整信息以 json 的形式存储到本地。
我们要爬取的网站链接是 https://www.qiushibaike.com/text/page/1/ 。

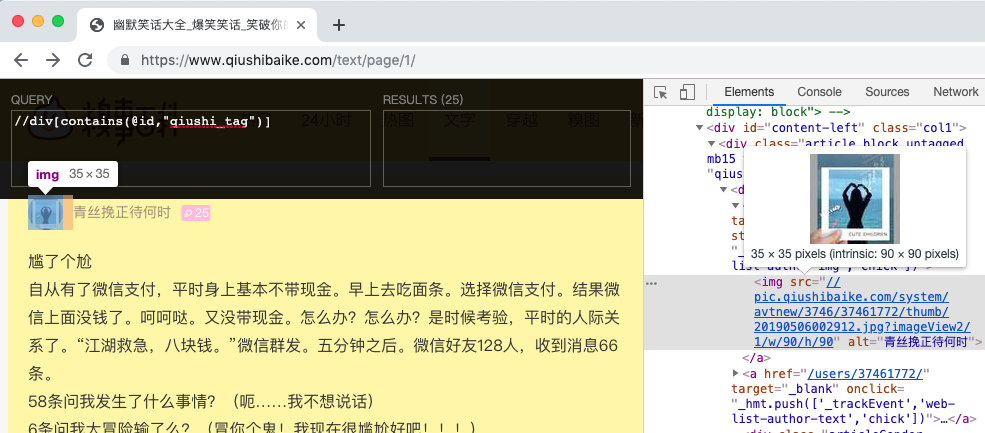
我们通过 Xpath Helper 的谷歌插件经过分析获取到我们想要的内容为: //div[contains(@id,"qiushi_tag")]
 import urllib.request

 from lxml import etree

 import ssl

 # 取消代理验证

 ssl._create_default_https_context = ssl._create_unverified_context

 url = "https://www.qiushibaike.com/text/page/1/"

 # User-Agent头

 user_agent = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.157 Safari/537.36'

 headers = {'User-Agent': user_agent}

 req = urllib.request.Request(url, headers=headers)

 response = urllib.request.urlopen(req)

 # 获取每页的HTML源码字符串

 html = response.read().decode('utf-8')

 # 解析html 为 HTML 文档

 selector = etree.HTML(html)

 content_list = selector.xpath('//div[contains(@id,"qiushi_tag")]')

 print(content_list)
输出结果为:

从上面的输出结果可以看出我们已经拿到了我们想要的数据,并且是一个列表类型,我们对列表进行操作扥别拿到糗事再存储到本地即可。
 items = {}

 for site in content_list:

     imgUrl = site.xpath('./div/a/img/@src')[0]  # 头像

     username = site.xpath('./div/a/img/@alt')[0]  # 作者

     content = site.xpath('.//div[@class="content"]/span[1]/text()')

     items = {

         "imgUrl": imgUrl,

         "username": username,

         "content": content,

     }

     with open("qiushi.json", "a") as f:

         f.write(json.dumps(items, ensure_ascii=False) + ",\n")
上面就可以实现一个获取 糗事百科 的糗事的简单爬虫,但是只能爬取单个页面的内容,通过分析 url 我们发现 https://www.qiushibaike.com/text/page/1/ 中最后的 1 即为页码,我们就可以根据这个页码逐一爬取更多页面的内容,最终的代码如下:
 import urllib.request

 from lxml import etree

 import json

 import ssl

 # 取消代理验证

 ssl._create_default_https_context = ssl._create_unverified_context

 class Spider:

     def __init__(self):

         # 初始化起始页位置

         self.page = 2

         # 爬取开关,如果为True继续爬取

         self.switch = True

     def loadPage(self):

         """

            作用:打开页面

         """

         url = "https://www.qiushibaike.com/text/page/" + str(self.page) + "/"

         # User-Agent头

         user_agent = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/74.0.3729.157 Safari/537.36'

         headers = {'User-Agent': user_agent}

         req = urllib.request.Request(url, headers=headers)

         response = urllib.request.urlopen(req)

         # 获取每页的HTML源码字符串

         html = response.read().decode('utf-8')

         # 解析html 为 HTML 文档

         selector = etree.HTML(html)

         content_list = selector.xpath('//div[contains(@id,"qiushi_tag")]')

         # 调用dealPage() 处理糗事里的杂七杂八

         self.dealPage(content_list)

     def dealPage(self, item_list):

         """

             @brief 处理得到的糗事列表

             @param item_list 得到的糗事列表

             @param page 处理第几页

         """

         for site in item_list:

             # 根据查询发现匿名用户和非匿名用户的标签不一样

             try:

                 # 非匿名用户

                 imgUrl = site.xpath('./div/a/img/@src')[0]  # 头像

                 username = site.xpath('./div/a/img/@alt')[0]  # 作者

             except Exception:

                 # 匿名用户

                 imgUrl = site.xpath('./div/span/img/@src')[0]  # 头像

                 username = site.xpath('./div/span/img/@alt')[0]  # 作者

             content = site.xpath('.//div[@class="content"]/span[1]/text()')

             items = {

                 "imgUrl": "https:" + imgUrl,

                 "username": username,

                 "content": content,

             }

             self.writePage(items)

     def writePage(self, items):

         """

             @brief 将数据追加写进文件中

             @param text 文件内容

         """

         myFile = open("./qiushi.json", 'a')  # 追加形式打开文件

         myFile.write(json.dumps(items, ensure_ascii=False) + ",\n")

         myFile.close()

     def startWork(self):

         """

             控制爬虫运行

         """

         # 循环执行,直到 self.switch == False

         while self.switch:

             # 用户确定爬取的次数

             self.loadPage()

             command = input("如果继续爬取,请按回车(退出输入quit)")

             if command == "quit":

                 # 如果停止爬取,则输入 quit

                 self.switch = False

             # 每次循环,page页码自增1

             self.page += 1

         print("爬取结束!")

 if __name__ == '__main__':

     # 定义一个Spider对象

     qiushiSpider = Spider()

     qiushiSpider.startWork()
程序启动后会在本地生成一个 city.json 的文件,结果如下:

Python 爬虫从入门到进阶之路(十五)的更多相关文章
- Python 爬虫从入门到进阶之路(五)
在之前的文章中我们带入了 opener 方法,接下来我们看一下 opener 应用中的 ProxyHandler 处理器(代理设置). 使用代理IP,这是爬虫/反爬虫的第二大招,通常也是最好用的. 很 ...
- Python 爬虫从入门到进阶之路(八)
在之前的文章中我们介绍了一下 requests 模块,今天我们再来看一下 Python 爬虫中的正则表达的使用和 re 模块. 实际上爬虫一共就四个主要步骤: 明确目标 (要知道你准备在哪个范围或者网 ...
- Python 爬虫从入门到进阶之路(二)
上一篇文章我们对爬虫有了一个初步认识,本篇文章我们开始学习 Python 爬虫实例. 在 Python 中有很多库可以用来抓取网页,其中内置了 urllib 模块,该模块就能实现我们基本的网页爬取. ...
- Python 爬虫从入门到进阶之路(六)
在之前的文章中我们介绍了一下 opener 应用中的 ProxyHandler 处理器(代理设置),本篇文章我们再来看一下 opener 中的 Cookie 的使用. Cookie 是指某些网站服务器 ...
- Python 爬虫从入门到进阶之路(九)
之前的文章我们介绍了一下 Python 中的正则表达式和与爬虫正则相关的 re 模块,本章我们就利用正则表达式和 re 模块来做一个案例,爬取<糗事百科>的糗事并存储到本地. 我们要爬取的 ...
- Python 爬虫从入门到进阶之路(十二)
之前的文章我们介绍了 re 模块和 lxml 模块来做爬虫,本章我们再来看一个 bs4 模块来做爬虫. 和 lxml 一样,Beautiful Soup 也是一个HTML/XML的解析器,主要的功能也 ...
- Python 爬虫从入门到进阶之路(十六)
之前的文章我们介绍了几种可以爬取网站信息的模块,并根据这些模块爬取了<糗事百科>的糗百内容,本章我们来看一下用于专门爬取网站信息的框架 Scrapy. Scrapy是用纯Python实现一 ...
- Python 爬虫从入门到进阶之路(十七)
在之前的文章中我们介绍了 scrapy 框架并给予 scrapy 框架写了一个爬虫来爬取<糗事百科>的糗事,本章我们继续说一下 scrapy 框架并对之前的糗百爬虫做一下优化和丰富. 在上 ...
- Python 爬虫从入门到进阶之路(七)
在之前的文章中我们一直用到的库是 urllib.request,该库已经包含了平常我们使用的大多数功能,但是它的 API 使用起来让人感觉不太好,而 Requests 自称 “HTTP for Hum ...
随机推荐
- 王立平--RemoteView
RemoteView它将在两个地方被使用:一个是在AppWidget,另外一个是在Notification. RemoteView是用来描写叙述一个垮进程显示的view 1.AppWidget---R ...
- POJ3723 Conscription 【并检查集合】
Conscription Time Limit: 1000MS Memory Limit: 65536K Total Submissions: 8071 Accepted: 2810 Desc ...
- Win8 Metro(C#)数字图像处理--2.56简单统计法图像二值化
原文:Win8 Metro(C#)数字图像处理--2.56简单统计法图像二值化 [函数名称] 简单统计法图像二值化 WriteableBitmap StatisticalThSegment(Wr ...
- asp.net文件流下载的代码摘要
try { var workbook = new XLWorkbook(); if (Workbook != null) { workbook = Workbook; } if (this.Expor ...
- codewars杂记: 寻找缺失的数
题目描述: 给出一个整数列表,找出该列表无法通过各种组合求和得到的最小的整数. 示例: solve([1,2,8,7]) = 4, because we can get 1, 2, 1+2=3. Bu ...
- GIS基础软件及操作(七)
原文 GIS基础软件及操作(七) 练习七.地形分析 地形分析:TIN及DEM的生成及应用 加深对TIN建立过程的原理.方法的认识: 熟练掌握ArcGIS中建立DEM.TIN的技术方法: 结合实际,掌握 ...
- 【转】编程之道 之 Rob Pike
1.你无法断定程序会在什么地方耗费运行时间.瓶颈经常出现在想不到的地方,所以别急于胡乱找个地方改代码,除非你已经证实那儿就是瓶颈所在. 2.估量.在你没对代码进行估量,特别是没找到最耗时的那部分之前, ...
- RxJava入门优秀博客推荐
RxJava用了快半年了,现在越来越离不开这个库,从使用到逐渐接触它的背后实现,突然想写点什么关于RxJava的内容.在酝酿如何组织内容的时候,就去看看自己关于RxJava的收藏,发现满满的干货! 1 ...
- RedHat 7.3+ORACLE 12c RAC 使用udev绑定磁盘
在RedHat 7中,很多命令发生了改变,其中使用udev对磁盘绑定的命令也发生了变更,不再使用start_udev,而是改为了udevadm,下面具体介绍如何使用udev对磁盘进行绑定,这里对6和7 ...
- MIPS开发板的“不二”选择——Creator Ci20单板计算机评测(芯片是君正JZ4780 ,也就是MIPS R3000,系统推荐Debian或深度,官网就有,其它语言有FreePascal和Go和Java和Python)
在MIPS架构的CPU上开发软件,当然需要使用MIPS专用的工具链来编译代码.不过一般的LINUX发行版内都有相应的配套工具链供用户使用.Ci20出厂时的LINUX发行版为DEBIAN 7.5,相应的 ...