
Hive 学习之路(五)—— Hive 分区表和分桶表
一、分区表
1.1 概念
Hive中的表对应为HDFS上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大。
分区为HDFS上表目录的子目录,数据按照分区存储在子目录中。如果查询的where字句的中包含分区条件,则直接从该分区去查找,而不是扫描整个表目录,合理的分区设计可以极大提高查询速度和性能。
这里说明一下分区表并Hive独有的概念,实际上这个概念非常常见。比如在我们常用的Oracle数据库中,当表中的数据量不断增大,查询数据的速度就会下降,这时也可以对表进行分区。表进行分区后,逻辑上表仍然是一张完整的表,只是将表中的数据存放到多个表空间(物理文件上),这样查询数据时,就不必要每次都扫描整张表,从而提升查询性能。
1.2 使用场景
通常,在管理大规模数据集的时候都需要进行分区,比如将日志文件按天进行分区,从而保证数据细粒度的划分,使得查询性能得到提升。
1.3 创建分区表
在Hive中可以使用PARTITIONED BY子句创建分区表。表可以包含一个或多个分区列,程序会为分区列中的每个不同值组合创建单独的数据目录。下面的我们创建一张雇员表作为测试:
 CREATE EXTERNAL TABLE emp_partition(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2)
    )
    PARTITIONED BY (deptno INT)   -- 按照部门编号进行分区
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_partition';
1.4 加载数据到分区表
加载数据到分区表时候必须要指定数据所处的分区:
# 加载部门编号为20的数据到表中
LOAD DATA LOCAL INPATH "/usr/file/emp20.txt" OVERWRITE INTO TABLE emp_partition PARTITION (deptno=20)
# 加载部门编号为30的数据到表中
LOAD DATA LOCAL INPATH "/usr/file/emp30.txt" OVERWRITE INTO TABLE emp_partition PARTITION (deptno=30)
1.5 查看分区目录
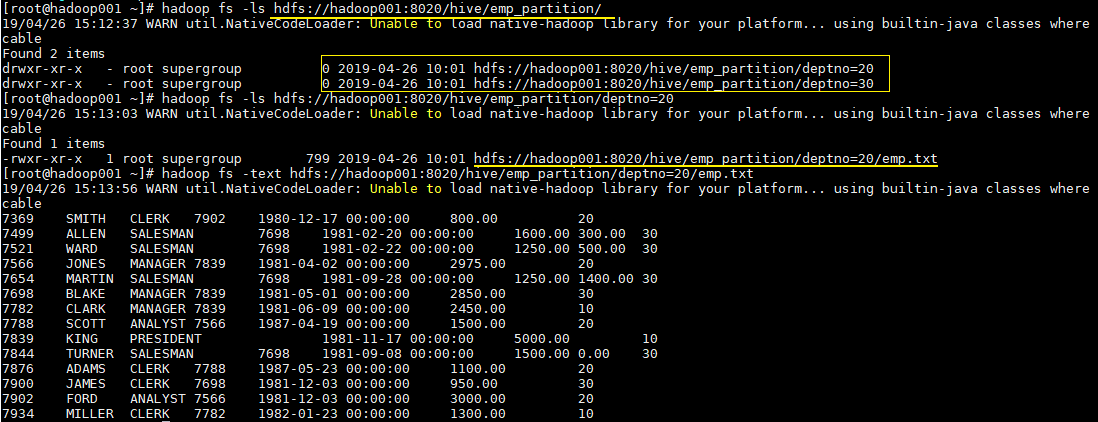
这时候我们直接查看表目录,可以看到表目录下存在两个子目录,分别是deptno=20和deptno=30,这就是分区目录,分区目录下才是我们加载的数据文件。
# hadoop fs -ls hdfs://hadoop001:8020/hive/emp_partition/
这时候当你的查询语句的where包含deptno=20,则就去对应的分区目录下进行查找,而不用扫描全表。
二、分桶表
1.1 简介
分区提供了一个隔离数据和优化查询的可行方案,但是并非所有的数据集都可以形成合理的分区,分区的数量也不是越多越好,过多的分区条件可能会导致很多分区上没有数据。同时Hive会限制动态分区可以创建的最大分区数,用来避免过多分区文件对文件系统产生负担。鉴于以上原因,Hive还提供了一种更加细粒度的数据拆分方案:分桶表(bucket Table)。
分桶表会将指定列的值进行哈希散列,并对bucket(桶数量)取余,然后存储到对应的bucket(桶)中。
1.2 理解分桶表
单从概念上理解分桶表可能会比较晦涩,其实和分区一样,分桶这个概念同样不是Hive独有的,对于Java开发人员而言,这可能是一个每天都会用到的概念,因为Hive中的分桶概念和Java数据结构中的HashMap的分桶概念是一致的。
当调用HashMap的put()方法存储数据时,程序会先对key值调用hashCode()方法计算出hashcode,然后对数组长度取模计算出index,最后将数据存储在数组index位置的链表上,链表达到一定阈值后会转换为红黑树(JDK1.8+)。下图为HashMap的数据结构图:
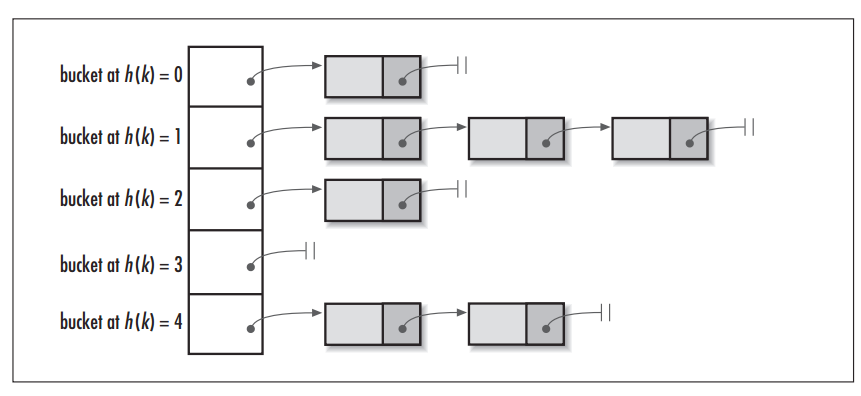
图片引用自:HashMap vs. Hashtable
1.3 创建分桶表
在Hive中,我们可以通过CLUSTERED BY指定分桶列,并通过SORTED BY指定桶中数据的排序参考列。下面为分桶表建表语句示例:
  CREATE EXTERNAL TABLE emp_bucket(
    empno INT,
    ename STRING,
    job STRING,
    mgr INT,
    hiredate TIMESTAMP,
    sal DECIMAL(7,2),
    comm DECIMAL(7,2),
    deptno INT)
    CLUSTERED BY(empno) SORTED BY(empno ASC) INTO 4 BUCKETS  --按照员工编号散列到四个bucket中
    ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t"
    LOCATION '/hive/emp_bucket';
1.4 加载数据到分桶表
这里直接使用Load语句向分桶表加载数据,数据时可以加载成功的,但是数据并不会分桶。
这是由于分桶的实质是对指定字段做了hash散列然后存放到对应文件中,这意味着向分桶表中插入数据是必然要通过MapReduce,且Reducer的数量必须等于分桶的数量。由于以上原因,分桶表的数据通常只能使用CTAS(CREATE TABLE AS SELECT)方式插入,因为CTAS操作会触发MapReduce。加载数据步骤如下:
1. 设置强制分桶
set hive.enforce.bucketing = true; --Hive 2.x不需要这一步
在Hive 0.x and 1.x版本,必须使用设置hive.enforce.bucketing = true,表示强制分桶,允许程序根据表结构自动选择正确数量的Reducer和cluster by column来进行分桶。
2. CTAS导入数据
INSERT INTO TABLE emp_bucket SELECT * FROM emp; --这里的emp表就是一张普通的雇员表
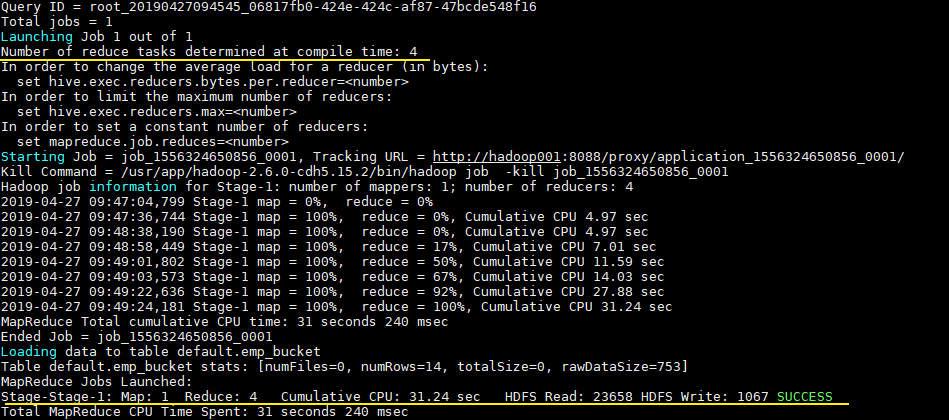
可以从执行日志看到CTAS触发MapReduce操作,且Reducer数量和建表时候指定bucket数量一致:
1.5 查看分桶文件
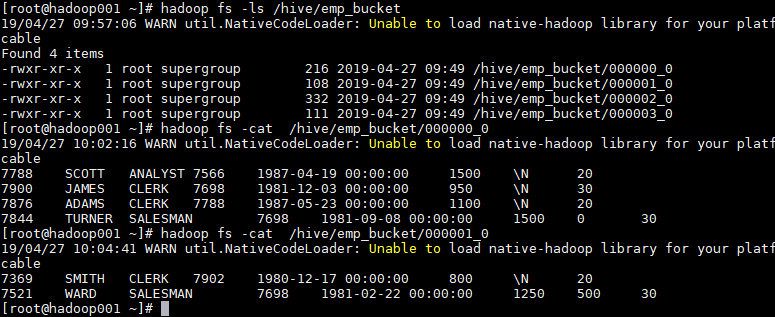
bucket(桶)本质上就是表目录下的具体文件:
三、分区表和分桶表结合使用
分区表和分桶表的本质都是将数据按照不同粒度进行拆分,从而使得在查询时候不必扫描全表,只需要扫描对应的分区或分桶,从而提升查询效率。两者可以结合起来使用,从而保证表数据在不同粒度上都能得到合理的拆分。下面是Hive官方给出的示例:
CREATE TABLE page_view_bucketed(
	viewTime INT,
    userid BIGINT,
    page_url STRING,
    referrer_url STRING,
    ip STRING )
 PARTITIONED BY(dt STRING)
 CLUSTERED BY(userid) SORTED BY(viewTime) INTO 32 BUCKETS
 ROW FORMAT DELIMITED
   FIELDS TERMINATED BY '\001'
   COLLECTION ITEMS TERMINATED BY '\002'
   MAP KEYS TERMINATED BY '\003'
 STORED AS SEQUENCEFILE;
此时导入数据时需要指定分区:
INSERT OVERWRITE page_view_bucketed
PARTITION (dt='2009-02-25')
SELECT * FROM page_view WHERE dt='2009-02-25';
参考资料
更多大数据系列文章可以参见个人 GitHub 开源项目: 程序员大数据入门指南
Hive 学习之路(五)—— Hive 分区表和分桶表的更多相关文章
- Hive 系列(五)—— Hive 分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- 一起学Hive——创建内部表、外部表、分区表和分桶表及导入数据
Hive本身并不存储数据,而是将数据存储在Hadoop的HDFS中,表名对应HDFS中的目录/文件.根据数据的不同存储方式,将Hive表分为外部表.内部表.分区表和分桶表四种数据模型.每种数据模型各有 ...
- hive 分区表和分桶表
1.创建分区表 hive> create table weather_list(year int,data int) partitioned by (createtime string,area ...
- 入门大数据---Hive分区表和分桶表
一.分区表 1.1 概念 Hive 中的表对应为 HDFS 上的指定目录,在查询数据时候,默认会对全表进行扫描,这样时间和性能的消耗都非常大. 分区为 HDFS 上表目录的子目录,数据按照分区存储在子 ...
- Hive(六)【分区表、分桶表】
目录 一.分区表 1.本质 2.创建分区表 3.加载数据到分区表 4.查看分区 5.增加分区 6.删除分区 7.二级分区 8.分区表和元数据对应得三种方式 9.动态分区 二.分桶表 1.创建分桶表 2 ...
- Hive 教程(四)-分区表与分桶表
在 hive 中分区表是很常用的,分桶表可能没那么常用,本文主讲分区表. 概念 分区表 在 hive 中,表是可以分区的,hive 表的每个区其实是对应 hdfs 上的一个文件夹: 可以通过多层文件夹 ...
- Hive SQL之分区表与分桶表
Hive sql是Hive 用户使用Hive的主要工具.Hive SQL是类似于ANSI SQL标准的SQL语言,但是两者有不完全相同.Hive SQL和Mysql的SQL方言最为接近,但是两者之间也 ...
- [转帖]Hive学习之路 (一)Hive初识
Hive学习之路 (一)Hive初识 https://www.cnblogs.com/qingyunzong/p/8707885.html 讨论QQ:1586558083 目录 Hive 简介 什么是 ...
- Hive学习之路 (一)Hive初识
Hive 简介 什么是Hive 1.Hive 由 Facebook 实现并开源 2.是基于 Hadoop 的一个数据仓库工具 3.可以将结构化的数据映射为一张数据库表 4.并提供 HQL(Hive S ...
随机推荐
- Android中使用sqlite3操作SQLite
SQLite库包含一个名字叫做sqlite3的命令行,它可以让用户手工输入并执行面向SQLite数据库的SQL命令.本文档提供一个样使用sqlite3的简要说明. 一.创建数据库: 1.将sqlit ...
- Adaptive device-initiated polling
A method includes periodically sending a polling call to an enterprise system outside the firewall a ...
- Qt图片自适应窗口控件大小(使用setScaledContents)
最近在用Qt设计一个小程序,想让一幅图片自适应窗口大小,由于本人比较笨,一直找不到好方法.找到了很多方法但都会出一些小问题, 刚刚摸索出解决办法了,在些记录. 思想: 1 显示图像是用QLabel2 ...
- android module 模块共用远程包
在项目有多模块,需要使用到同一个第三方包时,引入报错,个人解决方法如下 1. 在模块build.gradle 文件中配置maven远程地址 可从app下的build.gradle文件里复制 allpr ...
- [C++学习笔记14]动态创建对象(定义静态方法实现在map查找具体类名对应的创建函数,并返回函数指针,map真是一个万能类)good
[C++学习笔记14]动态创建对象 C#/Java中的反射机制 动态获取类型信息(方法与属性) 动态创建对象 动态调用对象的方法 动态操作对象的属性 前提:需要给每个类添加元数据 动态创建对象 实 ...
- Qt5.4.1在windows7配置Android开发环境(阳光柠檬_)
网上的说法有些时间比较久远,软件更新又快,配置路上总有一些坎坷. 自己亲自尝试了一遍,记录下来. 所需的软件: 1. qt-opensource-windows-x86-android-5.4.1.e ...
- WPF 获取 ListView DataTemplate 中控件值
原文:WPF 获取 ListView DataTemplate 中控件值 版权声明:本文为博主原创文章,未经博主允许可以随意转载 https://blog.csdn.net/songqingwei19 ...
- WinRAR 5.50 简体中文正式版发布(20多项改进)
感谢ikimi的投递 流行好用的压缩工具,支持鼠标拖放及外壳扩展,完美支持 ZIP 档案,内置程序可以解开 CAB.ARJ.LZH.TAR.GZ.ACE.UUE.BZ2.JAR.ISO 等多种类型的压 ...
- ESB (Enterprise Service Bus)
入门
在本文中,ESB相关技术概念和术语.其他需要了解的入门的基础知识,并介绍了一些初步的了解ESB产品.因为它是一个新的ESB.将自己的学习内容与过程,记录下来! 愿在这里与大家分享一下,共同进步与提高! ...
- 【转载】MySQL Replication 环境安装与配置
安装[root@msr01 ~]# yum install mysql-serverInstalled:mysql-server.x86_64 0:5.1.73-3.el6_5 Dependency ...