
SVM的代码实现-python
隔了好久木有更新了,因为发现自己numpy的很多操作都忘记了,加上最近有点忙.。。
接着上次
我们得到的迭代函数为
首先j != yi
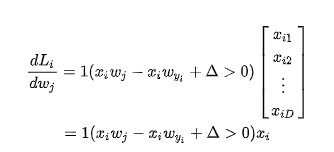
j = yi
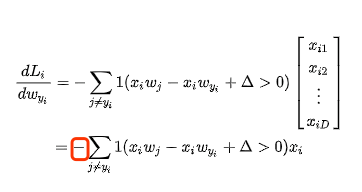
import numpy as np

def svm_loss_naive(W, X, y, reg):

    """

    Inputs:

    - W: A numpy array of shape (D, C) containing weights.

    - X: A numpy array of shape (N, D) containing a minibatch of data.

    - y: A numpy array of shape (N,) containing training labels; y[i] = c means

         that X[i] has label c, where 0 <= c < C.

    - reg: (float) regularization strength

    Returns a tuple of:

    - loss as single float

    - gradient with respect to weights W; an array of same shape as W

    """

    dW = np.zeros(W.shape)   # initialize the gradient as zero

    # compute the loss and the gradient

    num_classes = W.shape[1]

    num_train = X.shape[0]

    loss = 0.0

    for i in xrange(num_train):

        scores = X[i].dot(W)

        correct_class_score = scores[y[i]]

        for j in xrange(num_classes):

            if j == y[i]:    #根据公式,正确的那个不用算

                continue

            # 叠加margin

            margin = scores[j] - correct_class_score + 1   # note delta = 1

            if margin > 0:

                loss += margin

                dW[:, y[i]] += -X[i, :]     #  根据公式:∇Wyi Li = - xiT(∑j≠yi1(xiWj - xiWyi +1>0)) + 2λWyi

                dW[:, j] += X[i, :]         #  根据公式: ∇Wj Li = xiT 1(xiWj - xiWyi +1>0) + 2λWj , (j≠yi)

    # Right now the loss is a sum over all training examples, but we want it

    # to be an average instead so we divide by num_train.

    loss /= num_train

    dW /= num_train

    # Add regularization to the loss.

    loss += 0.5 * reg * np.sum(W * W)

    dW += reg * W

    return loss, dW

def svm_loss_vectorized(W, X, y, reg):

    """

    Structured SVM loss function, vectorized implementation.Inputs and outputs

    are the same as svm_loss_naive.

    """

    loss = 0.0

    dW = np.zeros(W.shape)   # initialize the gradient as zero

    scores = X.dot(W)        # N by C

    num_train = X.shape[0]

    num_classes = W.shape[1]

    scores_correct = scores[np.arange(num_train), y]   # 1 by N

    scores_correct = np.reshape(scores_correct, (num_train, 1))  # N by 1

    margins = scores - scores_correct + 1.0     # N by C

    margins[np.arange(num_train), y] = 0.0

    margins[margins <= 0] = 0.0

    loss += np.sum(margins) / num_train

    loss += 0.5 * reg * np.sum(W * W)

    # compute the gradient

    margins[margins > 0] = 1.0

    row_sum = np.sum(margins, axis=1)                  # 1 by N

    margins[np.arange(num_train), y] = -row_sum

    dW += np.dot(X.T, margins)/num_train + reg * W     # D by C

    return loss, dW
还没试一下,近期试一下这个的结果
SVM的代码实现-python的更多相关文章
- 编写高质量代码--改善python程序的建议(六)
原文发表在我的博客主页,转载请注明出处! 建议二十八:区别对待可变对象和不可变对象 python中一切皆对象,每一个对象都有一个唯一的标识符(id()).类型(type())以及值,对象根据其值能否修 ...
- 编写高质量代码--改善python程序的建议(八)
原文发表在我的博客主页,转载请注明出处! 建议四十一:一般情况下使用ElementTree解析XML python中解析XML文件最广为人知的两个模块是xml.dom.minidom和xml.sax, ...
- 抓取oschina上面的代码分享python块区下的 标题和对应URL
# -*- coding=utf-8 -*- import requests,re from lxml import etree import sys reload(sys) sys.setdefau ...
- 编写高质量代码改善python程序91个建议学习01
编写高质量代码改善python程序91个建议学习 第一章 建议1:理解pythonic的相关概念 狭隘的理解:它是高级动态的脚本编程语言,拥有很多强大的库,是解释从上往下执行的 特点: 美胜丑,显胜隐 ...
- 机器学习之支持向量机—SVM原理代码实现
支持向量机—SVM原理代码实现 本文系作者原创,转载请注明出处:https://www.cnblogs.com/further-further-further/p/9596898.html 1. 解决 ...
- 代码块: 以冒号作为开始,用缩进来划分作用域,这个整体叫做代码块,python的代码块可以提升整体的整齐度,提高开发效率
# ### 代码块: 以冒号作为开始,用缩进来划分作用域,这个整体叫做代码块 if 5 == 5: print(1) print(2) if True: print(3) print(4) if Fa ...
- 一行代码让python的运行速度提高100倍
python一直被病垢运行速度太慢,但是实际上python的执行效率并不慢,慢的是python用的解释器Cpython运行效率太差. “一行代码让python的运行速度提高100倍”这绝不是哗众取宠的 ...
- 编写高质量代码--改善python程序的建议(七)
原文发表在我的博客主页,转载请注明出处! 建议三十四:掌握字符串的基本用法 编程有两件事,一件是处理数值,另一件是处理字符串,在商业应用编程来说,处理字符串的代码超过八成,所以需要重点掌握. 首先有个 ...
- 编写高质量代码–改善python程序的建议(五)
原文发表在我的博客主页,转载请注明出处! 建议二十三:遵循异常处理的几点基本原则 python中常用的异常处理语法是try.except.else.finally,它们可以有多种组合,语法形式如下: ...
随机推荐
- O365 Manager Plus详解
- scope属性
scope属性 1.<bean>属性 2.作用:控制对象有效范围(单例.多例等) 3.<bean/> 标签对应的对象默认是单例的 3.1 无论获取多少次,都是同一个对象 4.s ...
- Hadoop3集群搭建之——虚拟机安装
现在做的项目是个大数据报表系统,刚开始的时候,负责做Java方面的接口(项目前端为独立的Java web 系统,后端也是Java web的系统,前后端系统通过接口传输数据),后来领导觉得大家需要多元化 ...
- Explain结果解读与实践
MySQL的EXPLAIN命令用于SQL语句的查询执行计划(QEP).这条命令的输出结果能够让我们了解MySQL 优化器是如何执行SQL 语句的.这条命令并没有提供任何调整建议,但它能够提供重要的信息 ...
- 2019.01.14 bzoj5343: [Ctsc2018]混合果汁(整体二分+权值线段树)
传送门 整体二分好题. 题意简述:nnn种果汁,每种有三个属性:美味度,单位体积价格,购买体积上限. 现在有mmm个询问,每次问能否混合出总体积大于某个值,总价格小于某个值的果汁,如果能,求所有方案中 ...
- PARSEC安环境配置、运行
1.getting started 2.run PARSEC on simulators Full-System Simulators: such as Simics, GEM5.Trace-Driv ...
- abaqus UMAT二次开发能用fortran90吗?
SUBROUTINE UMAT(STRESS,STATEV,DDSDDE,SSE,SPD,SCD,RPL,DDSDDT, # DRPLDE,DRPLDT,STRAN,DSTRAN,TIME,DTIME ...
- C语言三种方法调用数组
#include <stdio.h> /********************************* * 方法1: 第一维的长度可以不指定 * * 但必须指定第二维的长度 * *** ...
- SHELL脚本之awk妙用
对于一个sougou文本文件,解压后大概4G,要求在其基础上切出第一列时间年月日时分秒增加在列中,作为hive的一个索引.先将文件head一下展示格式: [root@Master date]# hea ...
- 添加网络ADB的方法(含以太网和无线)
将下面代码添加至packages/apps/Settings/src/com/android/settings/DevelopmentSettings.java 结合之前的添加wifi adb的博客 ...