
Hadoop系列(一):Hadoop集群搭建
环境:CentOS 7
JDK: 1.7.0_80
hadoop:2.8.5
两台机器:master(192.168.56.101) slave(192.168.56.102)
配置基础环境
1. 测试环境可以直接关闭selinux和防火墙(每个节点)
2. 每台主机添加hosts记录(每个节点)
# vim /etc/hosts

192.168.56.101   master

192.168.56.102   slave
3. 创建hadoop用户
# useradd hadoop

# passwd hadoop
4. 添加免密登陆(master节点本身也需要免密)
# su - hadoop

$ ssh-keygen -t rsa

$ ssh-copy-id hadoop@slave

$ ssh-copy-id hadoop@master

$ ssh hadoop@slave

$ ssh hadoop@master

其它节点也执行添加的过程...
安装JDK(每个节点都需要安装)
1. 卸载系统自带的openjdk
yum remove *openjdk*
2. 安装JDK
JDK下载地址:https://www.oracle.com/technetwork/java/javase/downloads/java-archive-downloads-javase7-521261.html
# tar zxvf jdk1.7.0_80.tgz -C /usr/local/

# vim /etc/profile

#添加

export JAVA_HOME=/usr/local/jdk1.7.0_80

export JAVA_BIN=$JAVA_HOME/bin

export PATH=$PATH:$JAVA_HOME/bin

export CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar

export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$PATH

# source /etc/profile

# java -version

java version "1.7.0_80"

Java(TM) SE Runtime Environment (build 1.7.0_80-b15)

Java HotSpot(TM) 64-Bit Server VM (build 24.80-b11, mixed mode)
部署Hadoop
在一台机器上配置,之后拷贝到其他节点主机
1. 安装Hadoop
# su - hadooop

$ wget https://www.apache.org/dyn/closer.cgi/hadoop/common/hadoop-2.8.5/hadoop-2.8.5.tar.gz

$ tar zxvf hadoop-2.8.5.tar.gz

$ mv hadoop-2.8.5 hadoop

#添加环境变量(每个节点都配置)

$ vim ~/.bashrc

export HADOOP_HOME=/home/hadoop/hadoop

export HADOOP_INSTALL=$HADOOP_HOME

export HADOOP_MAPRED_HOME=$HADOOP_HOME

export HADOOP_COMMON_HOME=$HADOOP_HOME

export HADOOP_HDFS_HOME=$HADOOP_HOME

export YARN_HOME=$HADOOP_HOME

export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native

export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin

$ source ~/.bashrc
2. 配置Hadoop
配置文件在`hadoop/etc/hadoop`目录下
$ cd hadoop/etc/hadoop

#1. 修改core-site.xml

$ vim core-site.xml

<configuration>

  <property>

    <name>fs.default.name</name>

    <value>hdfs://master:9000</value>

  </property>

  <property>

    <name>hadoop.tmp.dir</name>

    <value>file:/home/hadoop/hadoop/tmp</value>

  </property>

</configuration>

# 2. 修改hdfs-site.xml

$ vim hdfs-site.xml

<configuration>

    <property>

    <name>dfs.replication</name>

    <value>2</value>

  </property>

  <property>

    <name>dfs.namenode.name.dir</name>

    <value>file:/home/hadoop/hadoop/tmp/dfs/name</value>

  </property>

  <property>

    <name>dfs.datanode.data.dir</name>

    <value>file:/home/hadoop/hadoop/tmp/dfs/data</value>

  </property>

  <property>

    <name>dfs.namenode.secondary.http-address</name>

    <value>master:9001</value>

  </property>

</configuration>

# 3. 修改mapred-site.xml

$ cp  mapred-site.xml.template mapred-site.xml

$ vim mapred-site.xml

<configuration>

    <property>

    <name>mapreduce.framework.name</name>

    <value>yarn</value>

  </property>

</configuration>

# 4. 修改yarn-site.xml

$ vim yarn-site.xml

<configuration>

    <property>

    <name>yarn.resourcemanager.hostname</name>

    <value>master</value>

  </property>

   <property>

     <name>yarn.nodemanager.aux-services</name>

     <value>mapreduce_shuffle</value>

   </property>

  <property>

    <name>yarn.log-aggregation-enable</name>

    <value>true</value>

  </property>

  <property>

    <name>yarn.log-aggregation.retain-seconds</name>

    <value>604800</value>

  </property>

</configuration>

# 5. 修改slaves(此文件中指定slave节点)

$ vim slaves

slave

# 6. 修改hadoop-env.sh(如果不声明JAVA_HOME,在启动时会出现找不到JAVA_HOME 错误)

$ vim hadoop-env.sh

export JAVA_HOME=${JAVA_HOME}

改为

export JAVA_HOME=/usr/local/jdk1.7.0_80

# 7. 修改yarn-env.sh(如果不声明JAVA_HOME,在启动时会出现找不到JAVA_HOME 错误)

$ vim yarn-env.sh

在脚本前面添加

export JAVA_HOME=/usr/local/jdk1.7.0_80
3. 拷贝hadoop到slave节点,拷贝完成后修改yarn-site.xml文件要添加的内容
$ scp -r hadoop/ hadoop@slave:~/
4. 格式化HDFS
$ hadoop namenode -format
5. 启动服务
在Master上启动daemon,Slave上的服务会一起启动
$ sbin/start-dfs.sh

$ sbin/start-yarn.sh

或者

$ start-all.sh
查看启动情况
# master节点

$ jps

16321 NameNode

16658 ResourceManager

16511 SecondaryNameNode

16927 Jps

#slave节点

$ jps

16290 Jps

16167 NodeManager

16058 DataNode
浏览器中访问http://192.168.56.101:50070 查看管理页面
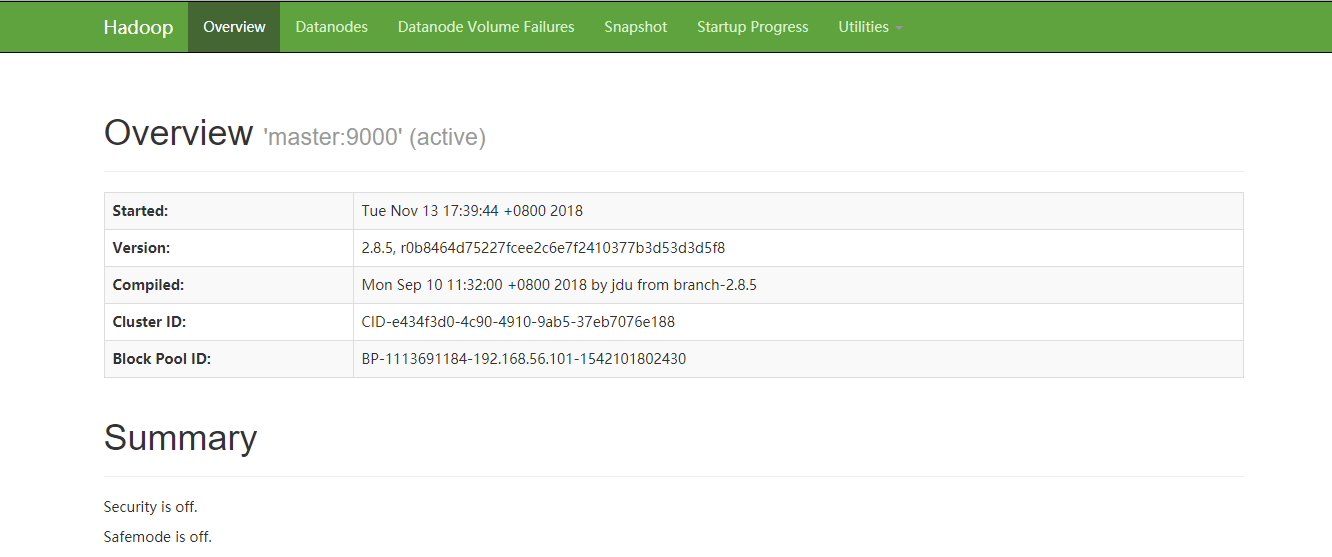
测试hadoop使用

Hadoop系列(一):Hadoop集群搭建的更多相关文章
- (五)hadoop系列之__集群搭建SSH无密访问多台机器
免密码ssh设置 现在确认能否不输入口令就用ssh登录localhost: $ ssh localhost 如果不输入口令就无法用ssh登陆localhost,执行下面的命令: . 并修改hosts映 ...
- Hadoop HA高可用集群搭建(Hadoop+Zookeeper+HBase)
声明:作者原创,转载注明出处. 作者:帅气陈吃苹果 一.服务器环境 主机名 IP 用户名 密码 安装目录 master188 192.168.29.188 hadoop hadoop /home/ha ...
- Ubuntu 12.04下Hadoop 2.2.0 集群搭建(原创)
现在大家可以跟我一起来实现Ubuntu 12.04下Hadoop 2.2.0 集群搭建,在这里我使用了两台服务器,一台作为master即namenode主机,另一台作为slave即datanode主机 ...
- 高可用Hadoop平台-HBase集群搭建
1.概述 今天补充一篇HBase集群的搭建,这个是高可用系列遗漏的一篇博客,今天抽时间补上,今天给大家介绍的主要内容目录如下所示: 基础软件的准备 HBase介绍 HBase集群搭建 单点问题验证 截 ...
- Hadoop初期学习和集群搭建
留给我学习hadoop的时间不多了,要提高效率,用上以前学的东西.hadoop要注重实战,把概念和原理弄清楚,之前看过一些spark,感觉都是一些小细节,对于理解hadoop没什么帮助.多看看资料,把 ...
- Hadoop HA高可用集群搭建(2.7.2)
1.集群规划: 主机名 IP 安装的软件 执行的进程 drguo1 192.168.80.149 j ...
- Zookeeper(四)Hadoop HA高可用集群搭建
一.高可就集群搭建 1.集群规划 2.集群服务器准备 (1) 修改主机名(2) 修改 IP 地址(3) 添加主机名和 IP 映射(4) 同步服务器时间(5) 关闭防火墙(6) 配置免密登录(7) 安装 ...
- hadoop HA+kerberos HA集群搭建
IP.主机名规划 hadoop集群规划: hostname IP hadoop 备注 hadoop1 110.185.225.158 NameNode,ResourceManager,DFSZKFai ...
- 第3章 Hadoop 2.x分布式集群搭建
目录 3.1 配置各节点SSH无密钥登录 1.将各节点的秘钥加入到同一个授权文件中 2.拷贝授权文件到各个节点 3.测试无秘钥登录 3.2 搭建Hadoop集群 1.上传Hadoop并解压 2.配置H ...
- 3.环境搭建-Hadoop(CDH)集群搭建
目录 目录 实验环境 安装 Hadoop 配置文件 在另外两台虚拟机上搭建hadoop 启动hdfs集群 启动yarn集群 本文主要是在上节CentOS集群基础上搭建Hadoop集群. 实验环境 Ha ...
随机推荐
- 斑马打印机的安装调试,生成PDF
1. 我使用的斑马打印机GK888T.有问题打客服,耐心等待.售后电话4006456456得到了解决. 2. 我遇到的问题是打印一张之后指示灯变为红灯,时好时坏.解决方案,长按指示键,待指示灯连续 ...
- C#知识拾遗
参数验证方式 1. 一般方法 1.1 手动验证 最为普遍常见,略. 1.2 使用扩展方法验证 在C#3.0 中,引入了扩展方法,可以以一种更优雅的方式来进行参数验证,如: //参数辅助类 pub ...
- java实现 批量转换文件编码格式
一.场景说明 不知道大家有没有遇到过之前项目是GBK,现在需要全部换成UTF-8的情况.反正我是遇到了. eclipse可以改变项目的编码格式,但是文件如果直接转换的话里面的中文就会全部乱码,需要先复 ...
- 对HTML5标签的认识(四)
这篇随笔讲讲HTML5中的表单和表单的一些元素 一.表单的作用是什么? 概念:表单在网页中主要是负责对数据信息的采取,表单一共分成三个部分: 1.表单的标签:这里面包含了处理表单的数据所用CGI程序以 ...
- C++系列总结——多态
前言 封装隐藏了类内部细节,通过继承加虚函数的方式,我们还可以做到隐藏类之间的差异,这就是多态(运行时多态).多态意味一个接口有多种行为,今天就来说说C++的多态是怎么实现的. 编译时多态感觉没什么好 ...
- 关于获取URL中传值的解决方法--升级版
这次页面之间的传值是升级版本,为什么是升级版本呢,因为这次页面的传值不一样了.大家可以看一下我原来的文章<关于获取URL中传值的解决方法> 其实上次就已经比较清楚的介绍了页面之间的传值,但 ...
- JavaScript是如何工作的:引擎,运行时和调用堆栈的概述!
摘要: 理解JS执行原理. 原文:JavaScript是如何工作的:引擎,运行时和调用堆栈的概述! 作者:前端小智 Fundebug经授权转载,版权归原作者所有. 本文是旨在深入研究JavaScrip ...
- 兹瓷查rank和kth的STL平衡树
兹瓷查rank和kth的STL平衡树 明天就是一轮省选了啊..这可能是退役前的最后一篇博文了吧(如果心情不好怕是连游记都会咕) 众周所知stl中有一个依靠红黑树实现的nb数据结构-std::set 但 ...
- Sharepoint 2013搜索服务配置总结(实战)
分享人:广州华软 星尘 一. 前言 SharePoint 2013集成了Fast搜索,相对于以前版本搜索的配置有了一些改变,在安装部署Sharepoint 2013时可以选择默认创建搜索服务,但有时候 ...
- UDK Stat命令
Stat命令(chs en)提供了游戏和引擎各个方面的实时统计信息,输入不同参数会在屏幕HUD上显示对应统计数据. 非Shipping版的UDK才会启用STATS宏,统计逻辑才会编译进exe,才能使 ...