
ansj人名识别
1、前言
1.1、asian_name_freq.data
1.2、person.dic
1.3、何时触发人名识别
public void setlocFreq(int[][] ints) {

	for (int i = 0; i < ints.length; i++) {

		if (ints[i][0] > 0) {

			flag = true;

			break ;

		}

	}

	locFreq = ints;

}
2、具体实现
2.1识别出可能的人名
Result terms = ToAnalysis.parse("罗毅虎和曹罗伟是高中同学");

System.out.println("分词结果:" + terms);
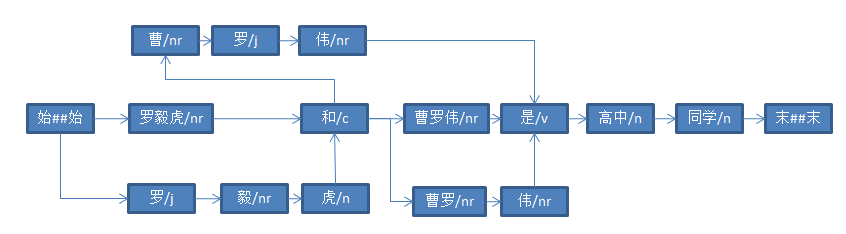
2.2、计算人名概率的一些理论基础
要想判断“曹罗伟”和“曹罗”哪个在此处更适合做人名,当然要计算二者存在的概率。
在谈到ansj的计算方法之前,我们先共同学习一下基于角色标注的中国人名自动识别研究这篇论文。(强烈建议读了这篇论文再往下看)
该论文将人名识别问题转化为了,对人名构成角色进行标注的问题。(详见论文的2.1、2.2)
我们要求解最终标注结果$T^{\#}=arg_{T}\,max\,P(T|W)$
论文中并不是直接求解$P(T|W)$,而是通过Bayes公式间接求解:
$P(T|W) = P(T)P(W|T)/P(W)$
没有直接求解,无非就是因为$P(T|W)$直接求解比较困难,或者根本无法直接求解。
我们先来看$P(t_{i}|w_{i})$是指:Token序列中的$w_{i}$,角色是$t_{i}$的概率。例如,对于人名识别前的Token序列:
$P(t_{i}|w_{i})$可以是指,“曹”这个$w_{i}$,角色是“三字姓名姓氏”的概率。
在大规模语料库训练的前提下,我们可以得到:
$P(t_{i}|w_{i})\approx C(t_{i},w_{i})/C(w_{i})$
其中,$C(t_{i},w_{i})$指角色$t_{i}$中出现$w_{i}$的次数,$C(w_{i})$是$w_{i}$出现的次数。
(1)、$C(w_{i})$是从大规模预料中统计出来,并保存在core词库中的,对该核心词库的整理,与人名识别无关,例如:
值得一提的是,$P(w_{i}|t_{i})$和$P(w_{i-1}|t_{i-1})$之间是相互独立的事件。
论文中提到,$P(W)$是一个常数。这确实是一个常数。并且,我们已经在现有核心词库(core.dic)的基础上,算得了这个数值。这正是上一节所讨论的内容。
2.3、计算人名概率
allFreq += Math.log(term.termNatures().allFreq + 1);

allFreq += -Math.log((freq));
但问题是,$C(w_{i})$ 和$C(t_{i},w_{i})$的统计来自不同的语料,所以这里的算法是没有理论依据的。
2.4、构造最短路径
计算完概率后,就可以使用Viterbi算法来求解最短路径,这与上一节类似。
以“陈颖超生前很和蔼”为例,将会得到以下结果:
2.5、人名消歧
2.6、用户自定义字典识别
// 用户自定义词典的识别

userDefineRecognition(graph, forests);
ansj人名识别的更多相关文章
- Hanlp实战HMM-Viterbi角色标注中国人名识别
这几天写完了人名识别模块,与分词放到一起形成了两层隐马模型.虽然在算法或模型上没有什么新意,但是胜在训练语料比较新,对质量把关比较严,实测效果很满意.比如这句真实的新闻“签约仪式前,秦光荣.李纪恒.仇 ...
- HanLP中人名识别分析
HanLP中人名识别分析 在看源码之前,先看几遍论文<基于角色标注的中国人名自动识别研究> 关于命名识别的一些问题,可参考下列一些issue: 名字识别的问题 #387 机构名识别错误 关 ...
- HanLP中人名识别分析详解
HanLP中人名识别分析详解 在看源码之前,先看几遍论文<基于角色标注的中国人名自动识别研究> 关于命名识别的一些问题,可参考下列一些issue: l ·名字识别的问题 #387 l ·机 ...
- HanLP中的人名识别分析详解
在看源码之前,先看几遍论文<基于角色标注的中国人名自动识别研究> 关于命名识别的一些问题,可参考下列一些issue: u u名字识别的问题 #387 u u机构名识别错误 u u关于层叠H ...
- ICTCLAS中的HMM人名识别
http://www.hankcs.com/nlp/segment/ictclas-the-hmm-name-recognition.html 本文主要从代码的角度分析标注过程中的细节,理论谁都能说, ...
- 【文智背后的奥秘】系列篇——基于CRF的人名识别
版权声明:本文由文智原创文章,转载请注明出处: 文章原文链接:https://www.qcloud.com/community/article/133 来源:腾云阁 https://www.qclou ...
- 基于分布式的短文本命题实体识别之----人名识别(python实现)
目前对中文分词精度影响最大的主要是两方面:未登录词的识别和歧义切分. 据统计:未登录词中中文姓人名在文本中一般只占2%左右,但这其中高达50%以上的人名会产生切分错误.在所有的分词错误中,与人名有关的 ...
- hanlp自然语言处理包的人名识别代码解析
HanLP发射矩阵词典nr.txt中收录单字姓氏393个.袁义达在<中国的三大姓氏是如何统计出来的>文献中指出:当代中国100个常见姓氏中,集中了全国人口的87%,根据这一数据我们只保留n ...
- HanLP-基于HMM-Viterbi的人名识别原理介绍
Hanlp自然语言处理包中的基于HMM-Viterbi处理人名识别的内容大概在年初的有分享过这类的文章,时间稍微久了一点,有点忘记了.看了 baiziyu 分享的这篇比我之前分享的要简单明了的多.下面 ...
随机推荐
- 一个操作cvs格式的c++类
经常需要使用excel,或者把有的数据用excel打开,程序可以生成cvs格式的文件,这样就可以excel打开并处理了,于是找了一个处理cvs的c++类跟大家分享 代码出处找不到了: 代码如下: St ...
- Linux常用命令(第二版) --Shell应用技巧
Shell应用技巧 小技巧: 1.命令补全功能: <Tab>键 2.清屏: Ctrl+l 3.删除光标前所有内容: Ctrl+u 4.命令历史记录: history 这时: !histo ...
- Sample Code for Qp_preq_pub.Price_request Api to Simulate an Ask for Promotion Modifier
DECLARE p_line_tbl QP_PREQ_GRP.LINE_TBL_TYPE; p_qual_tbl QP_PREQ_GRP.QUAL_TBL_TYPE; p_line_attr_tbl ...
- iOS监听模式系列之推送消息通知
推送通知 和本地通知不同,推送通知是由应用服务提供商发起的,通过苹果的APNs(Apple Push Notification Server)发送到应用客户端.下面是苹果官方关于推送通知的过程示意图: ...
- SharePoint 2013 新建网站集图解(绝对菜鸟篇)
前言:接触SharePoint的人可能是越来越多,但是很多人一接触就很迷茫,在技术群里问如何新建网站集,这样一篇图解,帮助新手学习在搭建好SharePoint环境之后,如何创建一个网站集,做一个基本的 ...
- Redis 协议为例谈简单的协议分析
怎样去研究一个协议的过程,协议的格式,好处,怎么样模拟发包等,下面是一个简单的过程记录. 研究的步骤: 协议相关的资料,RFC,官方文档等.弄清楚协议工作在4层还是7层,是二进制还是文本协议等 抓包, ...
- PLSQL Developer使用技巧
本文由liuyk80贡献 ·PL/SQL Developer 使用技巧 1.PL/SQL Developer 记住登陆密码 在使用 PL/SQL Developer 时,为了工作方便希望 PL/SQL ...
- jBPM4工作流应用开发指南
首先十分感谢作者给我这个机会在他的作品即将问世之前做一些感想,也正好让我能在忙碌中抽空回顾一下这么多年在技术平台方面走过的路以及在Workflow方面的点点滴滴.因为本书是介绍jBPM的专业书籍,所以 ...
- P3370 【模板】字符串哈希
题目描述 如题,给定N个字符串(第i个字符串长度为Mi,字符串内包含数字.大小写字母,大小写敏感),请求出N个字符串中共有多少个不同的字符串. 输入输出格式 输入格式: 第一行包含一个整数N,为字符串 ...
- No plugin found for prefix 'tomcat' in the current project and in the plugin groups和java.net.BindException: Address already in use: JVM_Bind <null>:8080的错误解决
错误报告:No plugin found for prefix 'tomcat' in the current project and in the plugin groups [org.apache ...