
python爬虫实战(2)--爬取百度贴吧
本篇目标
1.对百度贴吧的任意帖子进行抓取
2.指定是否只抓取楼主发帖内容
3.将抓取到的内容分析并保存到文件
1.URL格式的确定
先观察百度贴吧url格式,以中南财经政法大学迎新帖为例,URL我们划分基础部分是 http://tieba.baidu.com/p/5174106966,参数部分是 ?see_lz=1&pn=1
2.页面的抓取
一个初始化方法,一个获取页面的方法。另外,获取页面的方法我们需要知道一个参数就是帖子页码,所以这个参数的指定我们放在该方法中。
class Baidu_Spider:

    # 申明相关的属性

    def __init__(self, url):

        self.myUrl = url + '?see_lz=1'

        self.datas = []

        self.myTool = HTML_Tool()

        self.floor = 1

        print u'已经启动百度贴吧爬虫'

        # 初始化加载页面并将其转码储存

    def baidu_tieba(self):

        # 读取页面的原始信息并将其从utf-8转码

        myPage = urllib2.urlopen(self.myUrl).read().decode('utf-8')

        # 计算楼主发布内容一共有多少页

        endPage = self.page_counter(myPage)

        # 获取该帖的标题

        title = self.find_title(myPage)

        print u'文章名称:' + title

        # 获取最终的数据

        self.save_data(self.myUrl, title, endPage)

# 以中南财经政法大学迎新帖为例子

# bdurl = 'http://tieba.baidu.com/p/5174106966?see_lz=1&pn=1'

print u'请输入贴吧的地址最后的数字串:'

bdurl = 'http://tieba.baidu.com/p/' + str(raw_input(u'http://tieba.baidu.com/p/'))
初始代码
3.提取相关信息
1)提取帖子页数
        # 用来计算一共有多少页

    def page_counter(self, myPage):

        # 匹配 "共有<span class="red">12</span>页" 来获取一共有多少页

        myMatch = re.search(r'class="red">(\d+?)</span>', myPage, re.S)

        if myMatch:

            endPage = int(myMatch.group(1))

            print u'爬虫报告:发现楼主共有%d页的原创内容' % endPage

        else:

            endPage = 0

            print u'爬虫报告:无法计算楼主发布内容有多少页!'

        return endPage
提取页数
2)提取帖子标题
        # 用来寻找该帖的标题

    def find_title(self, myPage):

        # 匹配 <h1 class="core_title_txt" title="">xxxxxxxxxx</h1> 找出标题

        myMatch = re.search(r'<h1.*?>(.*?)</h1>', myPage, re.S)

        title = u'暂无标题'

        if myMatch:

            title = myMatch.group(1)

        else:

            print u'爬虫报告:无法加载文章标题!'

            # 文件名不能包含以下字符: \ / : * ? " < > |

        title = title.replace('\\', '').replace('/', '').replace(':', '').replace('*', '').replace('?', '').replace('"',

                                                                                                                    '').replace(

            '>', '').replace('<', '').replace('|', '')

        return title
提取标题
3)获取信息并保存
        # 用来存储楼主发布的内容

    def save_data(self, url, title, endPage):

        # 加载页面数据到数组中

        self.get_data(url, endPage)

        # 打开本地文件

        f = open(title + '.txt', 'w+')

        f.writelines(self.datas)

        f.close()

        print u'爬虫报告:文件已下载到本地并打包成txt文件'

        print u'请按任意键退出...'

        raw_input();

        # 获取页面源码并将其存储到数组中

    def get_data(self, url, endPage):

        url = url + '&pn='

        for i in range(1, endPage + 1):

            print u'爬虫报告:爬虫%d号正在加载中...' % i

            myPage = urllib2.urlopen(url + str(i)).read().decode('utf-8')

            # 将myPage中的html代码处理并存储到datas里面

            self.deal_data(myPage)

            # 将内容从页面代码中抠出来

    def deal_data(self, myPage):

        myItems = re.findall('id="post_content.*?>(.*?)</div>', myPage, re.S)

        for item in myItems:

            data = self.myTool.Replace_Char(item.encode('gbk'))

            myFloor = (str(self.floor) + "楼--------------------------------------").decode('utf-8').encode('gbk')

            self.datas.append(myFloor + '\n\n' + data + '\n\n')

            self.floor += 1
提取信息
4.完善代码
# -*- coding: utf-8 -*-

# ---------------------------------------

#   程序:百度贴吧爬虫

#   作者:lzhc

#   日期:2017-12-11

#   语言:Python 2.7

#   操作:输入网址后自动只看楼主并保存到本地文件

#   功能:将楼主发布的内容打包txt存储到本地。

# ---------------------------------------

import string

import urllib2

import re

# ----------- 处理页面上的各种标签 -----------

class HTML_Tool:

    # 用非 贪婪模式 匹配 \t 或者 \n 或者 空格 或者 超链接 或者 图片

    BgnCharToNoneRex = re.compile("(\t|\n| |<a.*?>|<img.*?>)")

    # 用非 贪婪模式 匹配 任意<>标签

    EndCharToNoneRex = re.compile("<.*?>")

    # 用非 贪婪模式 匹配 任意<p>标签

    BgnPartRex = re.compile("<p.*?>")

    CharToNewLineRex = re.compile("(<br>|</p>|<tr>|<div>|</div>)")

    CharToNextTabRex = re.compile("<td>")

    def Replace_Char(self, x):

        x = self.BgnCharToNoneRex.sub("", x)

        x = self.BgnPartRex.sub("\n    ", x)

        x = self.CharToNewLineRex.sub("\n", x)

        x = self.CharToNextTabRex.sub("\t", x)

        x = self.EndCharToNoneRex.sub("", x)

        return x

class Baidu_Spider:

    # 申明相关的属性

    def __init__(self, url):

        self.myUrl = url + '?see_lz=1'

        self.datas = []

        self.myTool = HTML_Tool()

        self.floor = 1

        print u'已经启动百度贴吧爬虫'

        # 初始化加载页面并将其转码储存

    def baidu_tieba(self):

        # 读取页面的原始信息并将其从utf-8转码

        myPage = urllib2.urlopen(self.myUrl).read().decode('utf-8')

        # 计算楼主发布内容一共有多少页

        endPage = self.page_counter(myPage)

        # 获取该帖的标题

        title = self.find_title(myPage)

        print u'文章名称:' + title

        # 获取最终的数据

        self.save_data(self.myUrl, title, endPage)

        # 用来计算一共有多少页

    def page_counter(self, myPage):

        # 匹配 "共有<span class="red">12</span>页" 来获取一共有多少页

        myMatch = re.search(r'class="red">(\d+?)</span>', myPage, re.S)

        if myMatch:

            endPage = int(myMatch.group(1))

            print u'爬虫报告:发现楼主共有%d页的原创内容' % endPage

        else:

            endPage = 0

            print u'爬虫报告:无法计算楼主发布内容有多少页!'

        return endPage

        # 用来寻找该帖的标题

    def find_title(self, myPage):

        # 匹配 <h1 class="core_title_txt" title="">xxxxxxxxxx</h1> 找出标题

        myMatch = re.search(r'<h1.*?>(.*?)</h1>', myPage, re.S)

        title = u'暂无标题'

        if myMatch:

            title = myMatch.group(1)

        else:

            print u'爬虫报告:无法加载文章标题!'

            # 文件名不能包含以下字符: \ / : * ? " < > |

        title = title.replace('\\', '').replace('/', '').replace(':', '').replace('*', '').replace('?', '').replace('"',

                                                                                                                    '').replace(

            '>', '').replace('<', '').replace('|', '')

        return title

        # 用来存储楼主发布的内容

    def save_data(self, url, title, endPage):

        # 加载页面数据到数组中

        self.get_data(url, endPage)

        # 打开本地文件

        f = open(title + '.txt', 'w+')

        f.writelines(self.datas)

        f.close()

        print u'爬虫报告:文件已下载到本地并打包成txt文件'

        print u'请按任意键退出...'

        raw_input();

        # 获取页面源码并将其存储到数组中

    def get_data(self, url, endPage):

        url = url + '&pn='

        for i in range(1, endPage + 1):

            print u'爬虫报告:爬虫%d号正在加载中...' % i

            myPage = urllib2.urlopen(url + str(i)).read().decode('utf-8')

            # 将myPage中的html代码处理并存储到datas里面

            self.deal_data(myPage)

            # 将内容从页面代码中抠出来

    def deal_data(self, myPage):

        myItems = re.findall('id="post_content.*?>(.*?)</div>', myPage, re.S)

        for item in myItems:

            data = self.myTool.Replace_Char(item.encode('gbk'))

            myFloor = (str(self.floor) + "楼--------------------------------------").decode('utf-8').encode('gbk')

            self.datas.append(myFloor + '\n\n' + data + '\n\n')

            self.floor += 1

            # -------- 程序入口处 ------------------

print u"""#---------------------------------------

#   程序:百度贴吧爬虫

#   作者:lzhc

#   日期:2017-12-11

#   语言:Python 2.7

#   操作:输入网址后自动只看楼主并保存到本地文件

#   功能:将楼主发布的内容打包txt存储到本地。

#---------------------------------------

"""

# 以中南财经政法大学迎新帖为例子

# bdurl = 'http://tieba.baidu.com/p/5174106966?see_lz=1&pn=1'

print u'请输入贴吧的地址最后的数字串:'

bdurl = 'http://tieba.baidu.com/p/' + str(raw_input(u'http://tieba.baidu.com/p/'))

# 调用

mySpider = Baidu_Spider(bdurl)

mySpider.baidu_tieba()
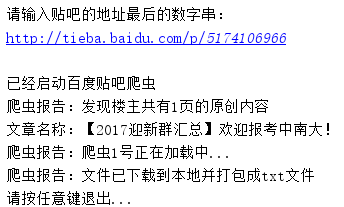
运行结果:
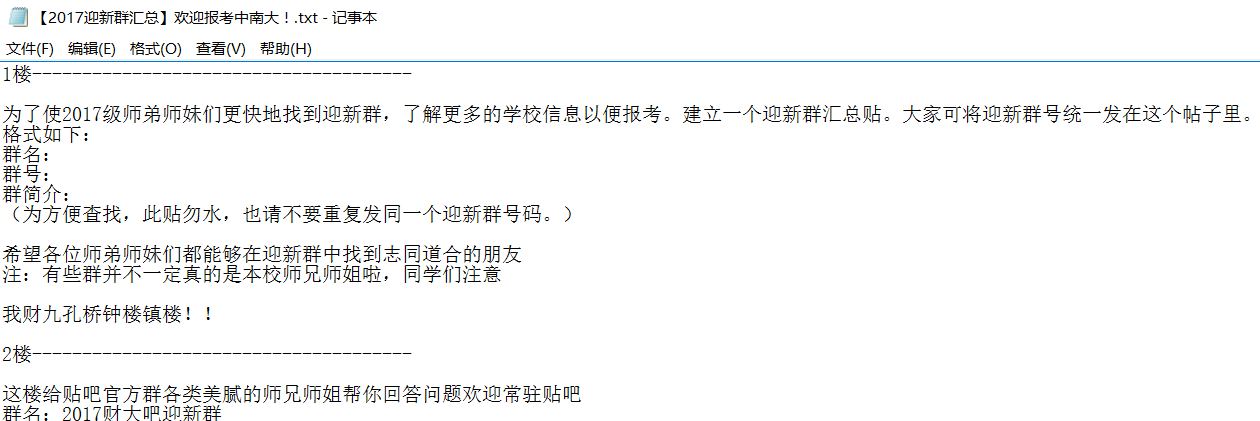
记入记事本中的内容:
python爬虫实战(2)--爬取百度贴吧的更多相关文章
- Python爬虫实战之爬取百度贴吧帖子
大家好,上次我们实验了爬取了糗事百科的段子,那么这次我们来尝试一下爬取百度贴吧的帖子.与上一篇不同的是,这次我们需要用到文件的相关操作. 本篇目标 对百度贴吧的任意帖子进行抓取 指定是否只抓取楼主发帖 ...
- 芝麻HTTP:Python爬虫实战之爬取百度贴吧帖子
本篇目标 1.对百度贴吧的任意帖子进行抓取 2.指定是否只抓取楼主发帖内容 3.将抓取到的内容分析并保存到文件 1.URL格式的确定 首先,我们先观察一下百度贴吧的任意一个帖子. 比如:http:// ...
- Python爬虫实战:爬取腾讯视频的评论
前言 本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理. 作者: 易某某 PS:如有需要Python学习资料的小伙伴可以加点击下方链 ...
- Python 爬虫练习: 爬取百度贴吧中的图片
背景:最近开始看一些Python爬虫相关的知识,就在网上找了一些简单已与练习的一些爬虫脚本 实现功能:1,读取用户想要爬取的贴吧 2,读取用户先要爬取某个贴吧的页数范围 3,爬取每个贴吧中用户输入的页 ...
- Python爬虫实战之爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- Python爬虫实战之爬取糗事百科段子【华为云技术分享】
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- python爬虫实战之爬取智联职位信息和博客文章信息
1.python爬取招聘信息 简单爬取智联招聘职位信息 # !/usr/bin/env python # -*-coding:utf-8-*- """ @Author ...
- 芝麻HTTP:Python爬虫实战之爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 友情提示 糗事百科在前一段时间进行了改版,导致之前的代码没法用了,会导致无法输出和CPU占用过高的 ...
- python 爬虫实战1 爬取糗事百科段子
首先,糗事百科大家都听说过吧?糗友们发的搞笑的段子一抓一大把,这次我们尝试一下用爬虫把他们抓取下来. 本篇目标 抓取糗事百科热门段子 过滤带有图片的段子 实现每按一次回车显示一个段子的发布时间,发布人 ...
- python 爬虫实战4 爬取淘宝MM照片
本篇目标 抓取淘宝MM的姓名,头像,年龄 抓取每一个MM的资料简介以及写真图片 把每一个MM的写真图片按照文件夹保存到本地 熟悉文件保存的过程 1.URL的格式 在这里我们用到的URL是 http:/ ...
随机推荐
- js 图片加载失败处理方法
在项目中不可避免会用到图片,尤其是列表,有时候图片会加载失败:这样就会显示一个很难看的坏图片缩略图:下面介绍两种方法,解决这个问题: 1.如果在你的项目中有引入jQuery插件,你可以使用error( ...
- numpy函数:[6]arange()详解
arange函数用于创建等差数组,使用频率非常高,arange非常类似range函数,会python的人肯定经常用range函数,比如在for循环中,几乎都用到了range,下面我们通过range来学 ...
- web 程序中的编码
比如字符串 <script type="text/javascript">alert('跨站攻击鸟')</script> 1.html encode ...
- Announcing the Release of ASP.NET MVC 5.1, ASP.NET Web API 2.1 and ASP.NET Web Pages 3.1 for VS2012
The NuGet packages for ASP.NET MVC 5.1, ASP.NET Web API 2.1 and ASP.NET Web Pages 3.1 are now live o ...
- Memcache 笔记(2)
一.Memcache概述出现的原因:随着数据量的增大,访问的集中,使得数据库服务器的负担加重,数据库响应恶化,网站显示延迟等 memcache:是高性能的分布式内存缓存服务器.通过缓存数据库的查询结果 ...
- POJ - 2195 最小费用最大流
题意:每个人到每个房子一一对应,费用为曼哈顿距离,求最小的费用 题解:单源点汇点最小费用最大流,每个人和房子对于建边 #include<map> #include<set> # ...
- hdu 3410 单调栈
http://acm.hdu.edu.cn/showproblem.php?pid=3410 Passing the Message Time Limit: 2000/1000 MS (Java/Ot ...
- 使用Spring MVC表单标(转)
概述 在低版本的Spring中,你必须通过JSTL或<spring:bind>将表单对象绑定到HTML表单页面中,对于习惯了Struts表单标签的开发者来说,Spring MVC的 ...
- nohup+命令+& 【退出终端后,程序依然在后台运行】
[ 如果你正在运行一个进程,而且你觉得在退出帐户时该进程还不会结束,那么可以使用nohup命令. 该命令可以忽略所有挂断(SIGHUP)信号,在你退出帐户/关闭终端之后继续运行相应的进程. nohup ...
- Linux下tar命令的各种参数选项和他们的作用整理
1.建立TAR包(打包)命令格式:tar cvf TAR包文件名.tar 所备份的文件或目录功能描述:tar cvf命令用于把指定的目录或文件打包到指定的文件中.“c”指定建立(或压缩)TAR包,“v ...