
Elasticsearch基础但非常有用的功能之一:别名
1、别名分类
别名在Elasticsearch中有两种分类。
1.1 索引别名
官方释义: 索引别名可以指向一个或多个索引,并且可以在任何需要索引名称的API中使用。 别名为我们提供了极大的灵活性。它们允许我们执行以下操作:
1)在正在运行的集群上的一个索引和另一个索引之间透明切换;
2)对多个索引进行分组组合(例如,lastthreemonths的索引别名:是过去3个月索引 logstash201903, logstash201904, logstash_201905的组合);
3)在索引中的文档子集上创建“视图”(结合业务场景,会提升检索效率)。
通俗解释: 索引别名类似:windows的快捷方式,linux的软链接,mysql的视图。
前提:Elasitcsearch创建索引后,索引名不允许改。很多业务场景下单一索引可能无法满足要求。

场景1:PB级别增量数据,借助rollover api实现,由基于日期的n个索引组成,显然,对外提供服务使用别名会很便捷。

场景2:试想,线上提供服务的某个索引出了问题,比如:某字段分词定义不准确,如何保证对外提供服务不停止(不更改业务代码)的前提下更换索引,显然,别名更合适。
注意:实际业务场景使用别名会很方便、灵活、快捷、业务松耦合!!
1.2 字段别名
在Elasticsearch Mapping定义的6.4+版本才有的字段类型。
通俗解释:
试想一下有一种业务场景。比如在实际的业务开发中:需要对Facebook、twitter行采集,采集入库的是两个业务团队。
他们对content,分别使用了两个字段。其中一个是,content。另外一个是cont。 这时候存储到elasticsearch会有两个字段。
这样如果我们在检索、写业务代码的时候,是不是要写两个不同的字段来处理呢? 如果有可能写成一个字段,代码方面就很避开业务耦合,就很方便了。
我认为这是字段别名的由来。
2、索引别名实践
2.1 假设没有别名,如何处理多索引检索?
方式一:多索引逗号分隔检索。

POST visitor_logs_2017,visitor_logs_2018/_search

方式二:通配符索引检索。

POST visitor_logs_*/_search
2.2 有了别名后,操作变得简单
实战中,我们不需要知道操作的实际索引名称,我们可以透明地更改别名引用的索引而不会影响使用别名的用户。
步骤1:别名关联已有索引。

POST /_aliases?pretty

{

  "actions": [

    {

      "add": {

        "index": "visitor_logs_2017",

        "alias": "visitor_logs"

      }

    },

    {

      "add": {

        "index": "visitor_logs_2018",

        "alias": "visitor_logs"

      }

    }

  ]

}

步骤2:使用别名检索

GET /visitor_logs/_search
3、索引别名的好处
3.1 大数据量的管理
场景: 实战中,可能需要基于时间的数据保留策略(利用rollover机制实现),并从系统中删除旧数据。 使用索引别名:
好处1:来简化从Elasticsearch中删除数据的过程。

好处2:在没有任何停机时间的情况下从Elasticsearch中删除最旧的数据,不会出现任何查询中断,也不会进行任何客户端更改。

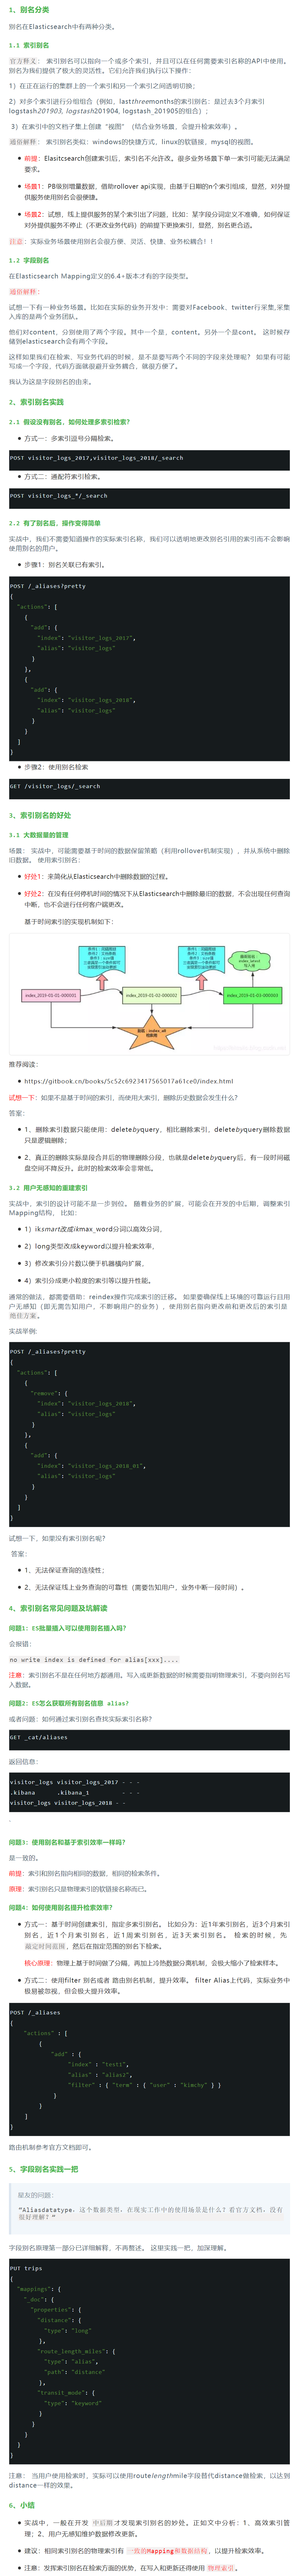
基于时间索引的实现机制如下:
推荐阅读:
https://gitbook.cn/books/5c52c6923417565017a61ce0/index.html
试想一下:如果不是基于时间的索引,而使用大索引,删除历史数据会发生什么?
答案:
1、删除索引数据只能使用:deletebyquery,相比删除索引,deletebyquery删除数据只是逻辑删除;

2、真正的删除实际是段合并后的物理删除分段,也就是deletebyquery后,有一段时间磁盘空间不降反升。此时的检索效率会非常低。
3.2 用户无感知的重建索引
实战中,索引的设计可能不是一步到位。 随着业务的扩展,可能会在开发的中后期,调整索引Mapping结构, 比如:
1)iksmart改成ikmax_word分词以高效分词,

2)long类型改成keyword以提升检索效率,

3)修改索引分片数以便于机器横向扩展,

4)索引分成更小粒度的索引等以提升性能。
通常的做法,都需要借助:reindex操作完成索引的迁移。 如果要确保线上环境的可靠运行且用户无感知(即无需告知用户,不影响用户的业务),使用别名指向更改前和更改后的索引是 绝佳方案。
实战举例:
POST /_aliases?pretty

{

  "actions": [

    {

      "remove": {

        "index": "visitor_logs_2018",

        "alias": "visitor_logs"

      }

    },

    {

      "add": {

        "index": "visitor_logs_2018_01",

        "alias": "visitor_logs"

      }

    }

  ]

}
试想一下,如果没有索引别名呢?
答案:
1、无法保证查询的连续性;

2、无法保证线上业务查询的可靠性(需要告知用户,业务中断一段时间)。
4、索引别名常见问题及坑解读
问题1:ES批量插入可以使用别名插入吗?
会报错:
no write index is defined for alias[xxx]....
注意:索引别名不是在任何地方都通用。写入或更新数据的时候需要指明物理索引,不要向别名写入数据。
问题2:ES怎么获取所有别名信息 alias?
或者问题:如何通过索引别名查找实际索引名称?
GET _cat/aliases
返回信息:
visitor_logs visitor_logs_2017 - - -

.kibana      .kibana_1         - - -

visitor_logs visitor_logs_2018 - -
`
问题3:使用别名和基于索引效率一样吗?
是一致的。
前提:索引和别名指向相同的数据,相同的检索条件。
原理:索引别名只是物理索引的软链接名称而已。
问题4:如何使用别名提升检索效率?
方式一:基于时间创建索引,指定多索引别名。 比如分为:近1年索引别名,近3个月索引别名,近1个月索引别名,近1周索引别名,近3天索引别名。 检索的时候,先 敲定时间范围,然后在指定范围的别名下检索。

核心原理:物理上基于时间做了分隔,再加上冷热数据分离机制,会极大缩小了检索样本。

方式二:使用filter 别名或者 路由别名机制,提升效率。 filter Alias上代码,实际业务中极易被忽视,但会极大提升效率。

POST /_aliases

{

    "actions" : [

        {

            "add" : {

                 "index" : "test1",

                 "alias" : "alias2",

                 "filter" : { "term" : { "user" : "kimchy" } }

            }

        }

    ]

}
路由机制参考官方文档即可。
5、字段别名实践一把
星友的问题:

“Aliasdatatype,这个数据类型,在现实工作中的使用场景是什么?看官方文档,没有很好理解?”
字段别名原理第一部分已详细解释,不再赘述。 这里实践一把,加深理解。
PUT trips

{

  "mappings": {

    "_doc": {

      "properties": {

        "distance": {

          "type": "long"

        },

        "route_length_miles": {

          "type": "alias",

          "path": "distance"

        },

        "transit_mode": {

          "type": "keyword"

        }

      }

    }

  }

}
注意: 当用户使用检索时,实际可以使用routelengthmile字段替代distance做检索,以达到distance一样的效果。
6、小结
实战中,一般在开发 中后期才发现索引别名的妙处。正如文中分析:1、高效索引管理;2、用户无感知维护数据修改更新。

建议:相同索引别名的物理索引有 一致的Mapping和数据结构,以提升检索效率。

注意:发挥索引别名在检索方面的优势,在写入和更新还得使用 物理索引。
Elasticsearch基础但非常有用的功能之一:别名的更多相关文章
- Elasticsearch基础但非常有用的功能之二:模板
文章转载自: https://mp.weixin.qq.com/s?__biz=MzI2NDY1MTA3OQ==&mid=2247484584&idx=1&sn=accfb65 ...
- Elasticsearch 基础介绍
# Elasticsearch简介 ## 基础概念 Elasticsearch由Shay banon在2004年进行初步开发,并且在2010年2月发布第一个版本. 此后Shay banon在2 ...
- ELK(elasticsearch+kibana+logstash)搜索引擎(二): elasticsearch基础教程
1.elasticsearch的结构 首先elasticsearch目前的结构为 /index/type/id id对应的就是存储的文档ID,elasticsearch一般将数据以JSON格式存储. ...
- ipython, 一个 python 的交互式 shell,比默认的python shell 好用得多,支持变量自动补全,自动缩进,支持 bash shell 命令,内置了许多很有用的功能和函数
一个 python 的交互式 shell,比默认的python shell 好用得多,支持变量自动补全,自动缩进,支持 bash shell 命令,内置了许多很有用的功能和函数. 若用的是fish s ...
- XMind十大最有用的功能
XMind十大最有用的功能 XMind是一款顶级商业品质的思维导图软件和头脑风暴软件,在企业和教育领域都有很广泛的应用,XMind功能全面,易上手,在此小编给大家整理出了XMind十大最有用的功能以供 ...
- RAC和单节点数据库的区别有哪些?RAC最有用的功能是什么?
区别 (1)RAC有2个以上的实例,单节点只有1个实例 (2)RAC具有实例级别的高可用 (3)实例与实例之间通过内联网络交换数据,单节点不可 (4)RAC每个节点都有自己套SGA.后台进程.redo ...
- 第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能
第三百六十九节,Python分布式爬虫打造搜索引擎Scrapy精讲—elasticsearch(搜索引擎)用Django实现搜索功能 Django实现搜索功能 1.在Django配置搜索结果页的路由映 ...
- Elasticsearch 基础入门
原文地址:Elasticsearch 基础入门 博客地址:http://www.extlight.com 一.什么是 ElasticSearch ElasticSearch是一个基于 Lucene 的 ...
- ElasticSearch 基础 1
ElasticSearch 基础=============================== 索引创建 ========================== 1. RESTFUL APIAPI 基本 ...
随机推荐
- MYSQL--安装2(命令行连接到数据库)
使用命令行窗口连接 MYSQL 数据库[操作示意图]
- day03_2_流程控制
# 流程控制 学习目标: ~~~txt1. idea安装与使用2. 流程控制if...else结构3. 流程控制switch结构4. 流程控制循环结构5. 流程控制关键字~~~ # 一.流程控制概述 ...
- Webpack干货系列 | 在 Webpack 5 集成 ESLint 的方法
程序员优雅哥(youyacoder)简介:十年程序员,呆过央企外企私企,做过前端后端架构.分享vue.Java等前后端技术和架构. 本文摘要:主要讲解运用Webpack 5 中集成 ESLint 的方 ...
- 市面上的工业ERP系统如何区别?存在什么样的不同?
工业发展当中所要涉及到的管理是繁琐而复杂的,在ERP系统的拓展开发中,市面上出现了很多的工业ERP系统来让企业选择.这是近年来非常受欢迎的一种管理手段,依靠计算机系统的强大功能,来实现数据化的管理,企 ...
- “杀死” App 上的疑难崩溃
在移动应用性能方面,崩溃带来的影响是最为严重的,程序崩了可以打断用户正在进行的操作体验,造成关键业务中断.用户留存率下降.品牌口碑变差.生命周期价值下降等影响.很多公司将崩溃率作为优先级最高的技术指标 ...
- 有一种密码学专用语言叫做ASN.1
目录 简介 ASN.1的例子 ASN.1中的内置类型 ASN.1中的限制语法 总结 简介 ASN.1是一种跨平台的数据序列化的接口描述语言.可能很多人没有听说过ASN.1, 但是相信有过跨平台编程经验 ...
- Mybatis的使用(2)
1 :模糊查询 #{}占位符和¥{}的区别 #{}占位符:传参大部分用#{}传参,它的底层是PreparedStatement对象,是安全的数据库访问,它能够防止sql注入 1.1:如果parmete ...
- Nginx 集群部署(Keepalived)
# Nginx集群部署 # 当我们的用户同时访问量达到一定量的时候,一台服务器是不够用的 # 这个时候我们需要解决这个问题肯定是要添加新的服务器去处理用户访问 # 多台服务器处理用户访问就需要我们集群 ...
- LyScript 实现对内存堆栈扫描
LyScript插件中提供了三种基本的堆栈操作方法,其中push_stack用于入栈,pop_stack用于出栈,而最有用的是peek_stack函数,该函数可用于检查指定堆栈位置处的内存参数,利用这 ...
- SDK和API的直接区别
狭义的说法,在实际工作中, 如果对方需要你提供一个api,是指一个工程提供给另外一个工程的接口(一般是基于http协议). 如果对方需要你提供一个sdk,是指基于对方工程的编程语言,提供一个代码包.在 ...