
一次spark任务提交参数的优化
起因
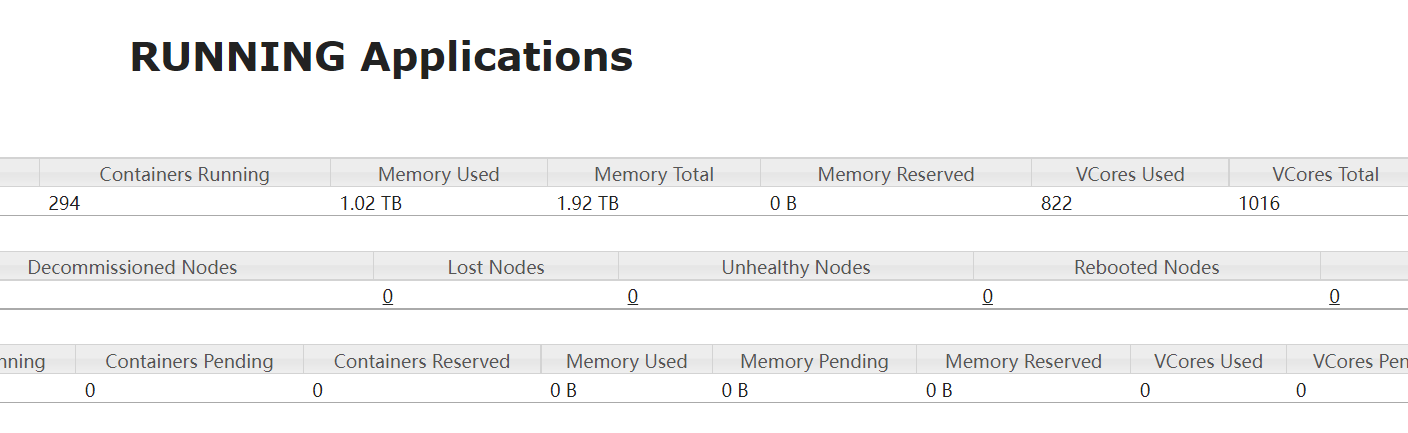
新接触一个spark集群,明明集群资源(core,内存)还有剩余,但是提交的任务却申请不到资源。
分析
环境
spark 2.2.0
基于yarn集群
参数
spark任务提交参数中最重要的几个:
spark-submit --master yarn --driver-cores 1 --driver-memory 5G --executor-cores 2 --num-executors 16 --executor-memory 4G
driver-cores driver端核数
driver-memory driver端内存大小
executor-cores 每个执行器的核数
num-executors 此任务申请的执行器总数
executor-memory 每个执行器的内存大小
那么,该任务将申请多少资源呢?
申请的执行器总内存数大小=num-executor * (executor-memory +spark.yarn.executor.memoryOverhead) = 16 * (4 + 2) = 96
申请的总内存=执行器总内存+dirver端内存=101
申请的总核数=num-executor*executor-core + yarn.AM(默认为1)=33
运行的总容器(contanier) = num-executor + yarn.AM(默认为1) = 17
所以这里还有一个关键的参数 spark.yarn.executor.memoryOverhead
这个参数是什么意思呢?
堆外内存,每个executor归spark 计算的内存为executor-memory,每个executor是一个单独的JVM,这个JAVA虚拟机本向在的内存大小即为spark.yarn.executor.memoryOverhead,不归spark本身管理。在spark集群中配置。也可在代码中指定
spark.set("spark.yarn.executor.memoryOverhead", 1)
这部份实际上是存放spark代码本身的究竟,在executor-memory内存不足的时候也能应应急顶上。
问题所在
假设一个节点16G的内存,每个executor-memory=4,理想情况下4x4=16,那么该节点可以分配出4个节点供spark任务计算所用。
1.但应考虑到spark.yarn.executor.memoryOverhead.
如果spark.yarn.executor.memoryOverhead=2,那么每个executor所需申请的资源为4+2=6G,那么该节点只能分配2个节点,剩余16-6x2=4G的内存,无法使用。
如果一个集群共100个节点,用户将在yarn集群主界面看到,集群内存剩余400G,但一直无法申请到资源。
2.core也是一样的道理。
很多同学容易忽略spark.yarn.executor.memoryOverhead此参数,然后陷入怀疑,怎么申请的资源对不上,也容易陷入优化的误区。
优化结果
最终优化结果,将spark.yarn.executor.memoryOverhead调小,并根据node节点资源合理优化executor-memory,executor-core大小,将之前经常1.6T的内存占比,降到1.1左右。并能较快申请到资源。
一次spark任务提交参数的优化的更多相关文章
- spark作业提交参数设置(转)
来源:https://www.cnblogs.com/arachis/p/spark_parameters.html 摘要 1.num-executors 2.executor-memory 3.ex ...
- Spark on Yarn:任务提交参数配置
当在YARN上运行Spark作业,每个Spark executor作为一个YARN容器运行.Spark可以使得多个Tasks在同一个容器里面运行. 以下参数配置为例子: spark-submit -- ...
- Spark性能调优篇一之任务提交参数调整
问题一:有哪些资源可以分配给spark作业使用? 答案:executor个数,cpu per exector(每个executor可使用的CPU个数),memory per exector(每个exe ...
- spark源码分析以及优化
第一章.spark源码分析之RDD四种依赖关系 一.RDD四种依赖关系 RDD四种依赖关系,分别是 ShuffleDependency.PrunDependency.RangeDependency和O ...
- Spark 3.x Spark Core详解 & 性能优化
Spark Core 1. 概述 Spark 是一种基于内存的快速.通用.可扩展的大数据分析计算引擎 1.1 Hadoop vs Spark 上面流程对应Hadoop的处理流程,下面对应着Spark的 ...
- Spark学习(四) -- Spark作业提交
标签(空格分隔): Spark 作业提交 先回顾一下WordCount的过程: sc.textFile("README.rd").flatMap(line => line.s ...
- Spark集群模式&Spark程序提交
Spark集群模式&Spark程序提交 1. 集群管理器 Spark当前支持三种集群管理方式 Standalone-Spark自带的一种集群管理方式,易于构建集群. Apache Mesos- ...
- 【Spark-core学习之四】 Spark任务提交
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 scala-2.10.4(依赖jdk1.8) spark ...
- spark任务提交到yarn上命令总结
spark任务提交到yarn上命令总结 1. 使用spark-submit提交任务 集群模式执行 SparkPi 任务,指定资源使用,指定eventLog目录 spark-submit --class ...
- Spark开发常用参数
Driver spark.driver.cores driver端分配的核数,默认为1,thriftserver是启动thriftserver服务的机器,资源充足的话可以尽量给多. spark.dri ...
随机推荐
- jmeter转义
/reportDetail?md5Key%3De7beff4c73ccd8f1cb01c383eda7fed0%26cid%3D1344500703825739777%26isShow%3Dfalse ...
- 贪心算法_Leetcode刷题_7/100
贪心算法 采用贪心策略,保证每次操作是局部最优的,从而使随后结果是全局最优的. 455.分配饼干 贪心策略:尽量把最小的饼干分配给胃口最小的孩子. 我的代码: 算法描述: 将孩子的胃口值g和拥有的饼干 ...
- 第12章 使用 Entity Framework Core 保存数据(ASP.NET Core in Action, 2nd Edition)
本章包括(请点击这里阅读其他章节) 什么是实体框架核心以及为什么应该使用它 向 ASP.NET Core 应用程序添加实体框架核心 构建数据模型并使用它创建数据库 使用实体框架核心查询.创建和更新数据 ...
- PVE联网及更换国内源
一.PVE联网 第一次安装PVE,正常情况下PVE的IP是在我们上网的网段的.没有网络有可能是没有配置DNS服务器地址或DNS地址是软路由网关地址.解决方法有3种: 1:设置DHCP自动获取网络地址和 ...
- springboot配置类@ConfigurationProperties报错Not registered via @EnableConfigurationProperties or marked as Spring component
添加一个@Component可以解决此问题,只有这个组件是容器中的组件,才能使用容器提供的@ConfigurationProperties功能.
- pytorch卷积模块
nn.Conv2d() 常用的参数有in_channels,out_channels,kernel_size,stride,padding; 除此之外还有参数dilation,groups,bias ...
- MySQL查询和事务
数据库关联查询 内连接查询(inner join) SELECT * FROM tb1 INNER JOIN tb2 ON 条件 左表查询(左关联查询)(left join) 查询两个表共有的数据,和 ...
- [读书笔记]FDTD与YEE晶胞
截图选自Understanding the Finite-Difference Time-Domain Metho 作者是John B. Schneider 有限差分时域(FDTD)方法使用有限差分 ...
- UG二次开发-CAM-获取修改路径参数
项目中要获取路径参数,网上大多是C++的例子,而本项目是用C#写的,探索了下,记录下. 以获取某条路径的刀具号为例,其他参数依此类推. using System; using System.Colle ...
- elasticsearch开发学习及踩坑实录
1.elasticsearch7.+需要jdk11 / elasticsearch6.+需要jdk8 , 如果是Java开发的同学本地开发使用jdk8 , 可以下载一个解压版的jdk11 , 然后修改 ...