
【论文解读】[目标检测]retinanet
作为单阶段网络,retinanet兼具速度和精度(精度是没问题,速度我持疑问),是非常耐用的一个检测器,现在很多单阶段检测器也是以retinanet为baseline,进行各种改进,足见retinanet的重要,我想从以下几个方面出发将retinanet解读下,尽己所能。
- retinanet出发点,目的,为什么
- retinanet解决方案,做法,干什么
- retinanet的效果,缺点,改什么
- retinanet中的疑点(我个人的)
【出发点】
retinanet的出发点,作为一款单阶段检测器,开个玩笑,它其实是想为yolo,ssd等前辈找回牌面,毕竟在速度上是达到实时了,但是精度上依然被faster rcnn等两阶段检测器吊打,着实没面子,那既然痛点在精度上,本文的重点也在于此,作者认为单阶段的精度差在于单阶段检测器中样本的失衡,负样本比例远远大于正样本,占据样本中多数,影响网络的优化(如何解释会妨碍网络优化,我还解释不清),而两阶段就没有这样的问题么,我觉得不是没有,但问题小很多,因为第一阶段会剔除掉大量负样本,所以在第二阶段训练时候,正负样本比例失衡并不严重,尽管第一阶段也会面临这样的问题。也许可以将focal loss(retinanet采用的采样方案或者说损失形式)用于RPN,按道理来讲会提升的
既然负样本太多,那我们也不是没办法,之前已有相关的处理方法,比如OHEM,专门挑比较难分类的负样本进行分类,其余的负样本不参与训练,效果也是不错的,大方向思路也没问题,就是降低易分类样本的影响,OHEM的思路是让它们的影响为0,直接弃用,而本文的思路是降低它们的权重,提高难分类样本的权重,如果再加上另一种方案,即所有样本原封不动,参与训练,那么这三种方案,OHEM属于激进派,retinanet属于温和派,原封不动属于保守派,最后的实验结果表明 温和派>激进派>保守派
【解决方案】
retinanet的解决方案十分的简洁,简洁到令人发指,就是在原本的分类损失上进行改动,加上权重因子,减小易分类样本的权重,加大难分类样本的权重(相对而言,不是绝对的变大了),至于回归损失,保持不变
首先看原来的分类损失,以二分类为例(多分类基本是一样的)
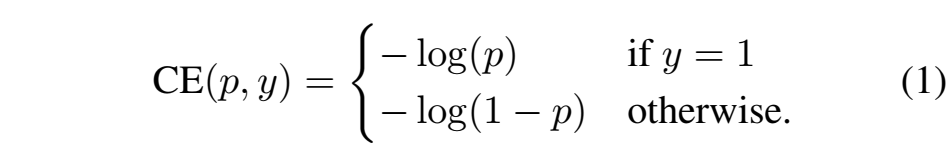
这就是标准的交叉熵损失,稍微变换一下

有下面公式

对于这个公式,Pt越大,代表越容易分类,也就是越接近target,
于是我们应该在Pt变大时,权重变小, 变小时,权重变大, 怎么做,加一个权重因子即可,我先来一个乞丐版的,在原公式前面乘以1-Pt。就成了
当然了,论文中稍微高大上一些,

γ(gamma,不是Y),是一个指数因子,论文里设为2
上面的公式就是focal loss,但还不是最终版,在类别不平衡中有一种做法,是给损失加上常数项正负样本平衡因子,α,这个平衡因子是用来对正负样本的损失进行平衡,并不能区分易分类样本和难分类样本哦,最终版focal loss也加入了这一项,于是变成(下标t与P的下标一个意思,针对两种类别),相比公式4,效果轻微提升
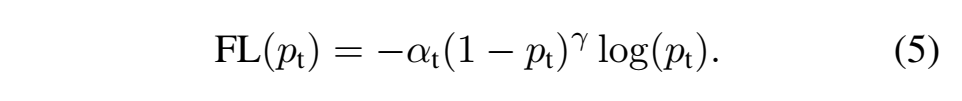
论文中给出了,Focal loss和CE的对比图,CE的loss在最上面,可以看到,越易分类的样本,Focal loss损失越小

上面就是核心,下面我来讲一下实现细节,网络结构,anchor的设置,FPN的设置,等等
网络结构
作者采用的网络与faster rcnn或者FPN一样,也是resnet50,101,然后加上FPN的结构,如下图所示
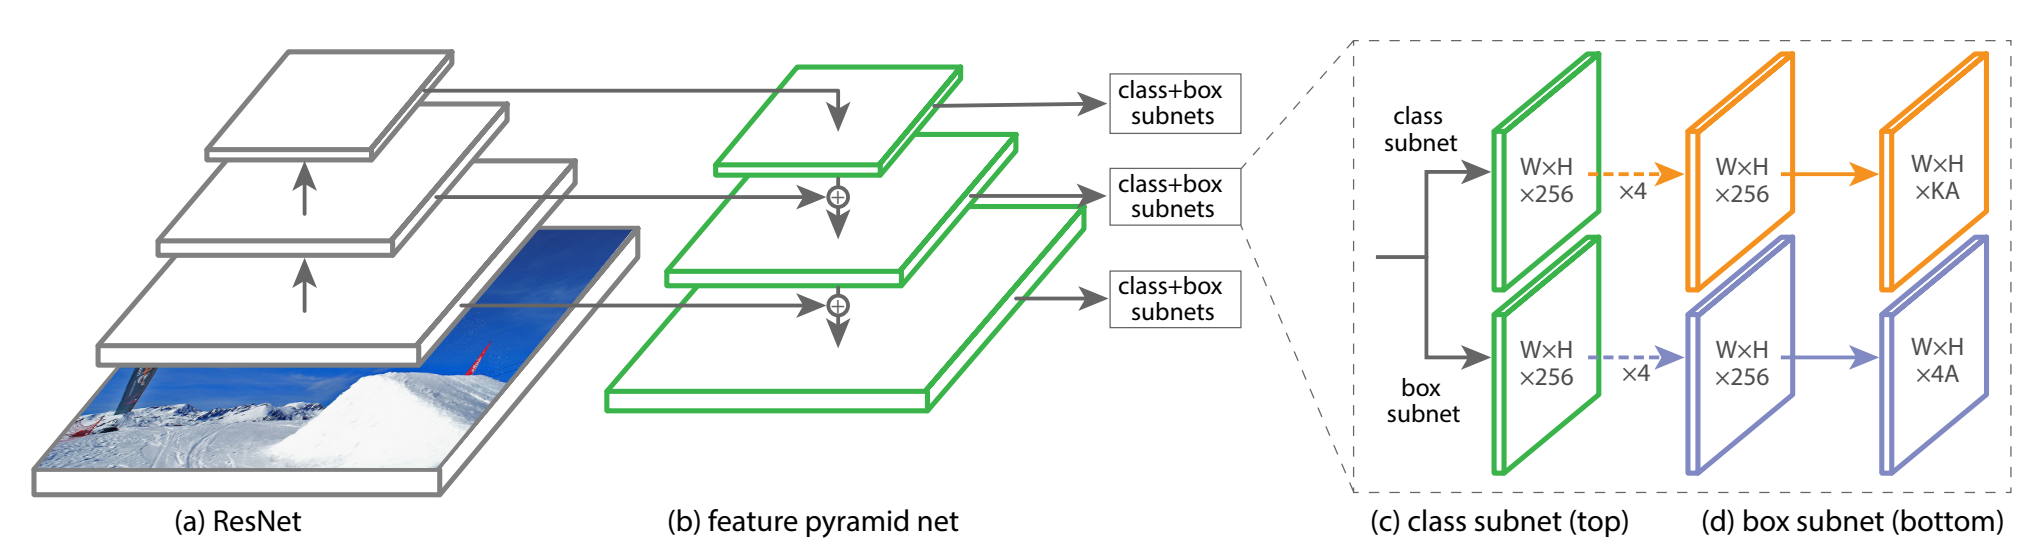
对于金字塔的每一层,都有两个分支,分类和回归,A是每个预测位置的anchor数量,以该位置为中心,K是要预测的目标类别数,4是与类别无关的坐标回归,也可以设置成与类别相关的,那就是4K个通道输出了,论文中作者说这两种设置效果相同,但类别无关的显然参数更少。
另外需要注意的一点是不同金字塔级别的分类分支参数共享,就是使用同一个卷积组合,回归分支,作者没说是否参数共享
inference:前向推理阶段,即测试阶段,作者对金字塔每层特征图都使用0.05的置信度阈值进行筛选,然后取置信度前1000的候选框(不足1000更好) ,接下来收集所有层的候选框,进行NMS,阈值0.5
train:训练时,与GT的IOU大于0.5为正样本,小于0.4为负样本,否则忽略
anchor:anchor的设置与FPN论文略有不同,FPN中每一层一种尺度,三种比例,而retinanet中,每一层三种尺度,三种比例,在FPN中,5层金字塔,anchor尺度范围是322到5122,而本文为每一层的尺度设置三种,20, 21/3, 22/3.比例依旧是1:1, 1:2,2:1,于是有9种anchor。
以输入为800X800,五层金字塔尺度分别为100X100,50X50,25X25,12X12,6X6,算一下anchor数量,119745, 10几万anchor覆盖在整张图像中,密密麻麻,让你知道什么是密集检测,哈哈,插句话,10几万anchor中绝大多数都是负样本,无用的计算太多,这也是现在anchor free的一个出发点。
网络初始化:这一点本来没什么可说的,大家都一样,但是retinanet做了一点设置
【效果】
论文中给了好多对比试验,也给出了好多map值,简单贴一下,都是coco test-dev数据集的
37.8 resnet101-FPN 800
39.1 resnet101-FPN 800,scale jitter, longer train time
40.8 resNext101-FPN 800
还有好多对比试验结果, 就不一一贴出来了
【缺点】
如果要说retinanet的缺点,其实不好讲,因为人家设计的主要是一种损失函数,而且很有效,非要挑毛病,那就是密集检测本身的毛病,大量无用anchor,造成计算和存储上的不必要
【疑点】
scale jitter是具体怎么实现的,训练时候使用多种尺度?
如果类别输出采用softmax激活函数,而不是sigmoid,那么可以不设置背景类吗?
retinanet的训练太慢了,跟大量anchor肯定相关,能提提速吗?
好,就是这些。
【论文解读】[目标检测]retinanet的更多相关文章
- 经典论文系列 | 目标检测--CornerNet & 又名 anchor boxes的缺陷
前言: 目标检测的预测框经过了滑动窗口.selective search.RPN.anchor based等一系列生成方法的发展,到18年开始,开始流行anchor free系列,CornerNe ...
- Comparison of SIFT Encoded and Deep Learning Features for the Classification and Detection of Esca Disease in Bordeaux Vineyards(分类MobileNet,目标检测 RetinaNet)
识别葡萄的一种虫害,比较了传统SIFT和深度学习分类,最后还做了目标检测 分类用的 MobileNet,目标检测 RetinaNet MobileNet 是将传统深度可分离卷积分成了两步,深度卷积和逐 ...
- 目标检测 | RetinaNet:Focal Loss for Dense Object Detection
论文分析了one-stage网络训练存在的类别不平衡问题,提出能根据loss大小自动调节权重的focal loss,使得模型的训练更专注于困难样本.同时,基于FPN设计了RetinaNet,在精度和速 ...
- 带你读AI论文丨用于目标检测的高斯检测框与ProbIoU
摘要:本文解读了<Gaussian Bounding Boxes and Probabilistic Intersection-over-Union for Object Detection&g ...
- 【目标检测】Cascade R-CNN 论文解析
目录 0. 论文链接 1. 概述 2. 网络结构的合理性 3. 网络结构 4. 参考链接 @ 0. 论文链接 Cascade R-CNN 1. 概述 这是CVPR 2018的一篇文章,这篇文章也为 ...
- 目标检测(六)YOLOv2__YOLO9000: Better, Faster, Stronger
项目链接 Abstract 在该论文中,作者首先介绍了对YOLOv1检测系统的各种改进措施.改进后得到的模型被称为YOLOv2,它使用了一种新颖的多尺度训练方法,使得模型可以在不同尺寸的输入上运行,并 ...
- [目标检测] 从 R-CNN 到 Faster R-CNN
R-CNN 创新点 经典的目标检测算法使用滑动窗法依次判断所有可能的区域,提取人工设定的特征(HOG,SIFT).本文则预先提取一系列较可能是物体的候选区域,之后仅在这些候选区域上用深度网络提取特征, ...
- AAAI2019 | 基于区域分解集成的目标检测 论文解读
Object Detection based on Region Decomposition and Assembly AAAI2019 | 基于区域分解集成的目标检测 论文解读 作者 | 文永亮 学 ...
- CVPR2020论文解读:3D Object Detection三维目标检测
CVPR2020论文解读:3D Object Detection三维目标检测 PV-RCNN:Point-Voxel Feature Se tAbstraction for 3D Object Det ...
随机推荐
- 大数据笔记(三十)——一篇文章读懂SparkSQL
Spark SQL:类似Hive ======================================================= 一.Spark SQL基础 1.什么是Spark SQ ...
- pymysql 处理数据的几种方式
1.表中提取数据 sql = "SELECT * FROM table WHERE name='%s'AND time='%s'" % (name,time)多个选择条件用AND连 ...
- 20165218 《网络对抗技术》 Exp8 Web基础
Exp8 Web基础 基础问题回答 (1)什么是表单 表单可以收集用户的信息和反馈意见,是网站管理者与浏览者之间沟通的桥梁. 一个表单有三个基本组成部分: 表单标签 表单域:包含了文本框.密码框.隐藏 ...
- Spring boot 自定义一个starter pom
用过springboot的自动配置会觉得非常方便,我们完全可以自己写一个starter pom,这样不仅可以有自动配置功能,而且具有更通用的的耦合度低的配置, 新建一个starter的maven项目, ...
- HAProxy & Keepalived L4-L7 高可用负载均衡解决方案
目录 文章目录 目录 HAProxy 负载均衡器 应用特性 性能优势 会话保持 健康检查 配置文件 负载均衡策略 ACL 规则 Web 监控平台 Keepalived 虚拟路由器 核心组件 VRRP ...
- OpenStack Rally 质量评估与自动化测试利器
目录 文章目录 目录 问题描述 Rally 简介 应用场景 应用案例 Rally 安装 Rally 使用 Rally 架构 Rally Plugin 分析与实现 程序入口 执行 rally task ...
- 系统分析与设计HW2
简答题 1. 简述瀑布模型.增量模型.螺旋模型(含原型方法)的优缺点. 瀑布模型 优点: 定义了软件开发基本流程与活动. 为项目提供了按阶段划分的检查点. 当前一阶段完成后,只需关注后续阶段. 缺点: ...
- oracle expdp/impdp/可传输表空间
oracle expdp/impdp/可传输表空间/及一些参数 Oracle data pump 导出操作能够将表.索引.约束.权限.PLSQL包.同义词等对象从数据库导出,并将它们保存在一种非文本格 ...
- nslookup、dig、host
1.作用:查询域名对应的地址或者地址对应的域名 2.nslookup已经不建议使用,慢慢就会废弃,建议使用dig和host代替 3.格式 dig: dig @NameServer 域名 Type ho ...
- 【Airtest】由于Airtest中long_click无法实现长按,教你如何在Airtest中实现长按的方法
Airtest中我们想要实现长按操作,poco中有一个方法long_click,但是实际使用了一下,发现并没有卵用,仍然是单击操作,如下图 那我们要如何进行长按操作呢?其实可以利用swipe实现,以长 ...