
Hive explain执行计划详解
简介:HIVE提供了EXPLAIN命令来展示一个查询的执行计划,这个执行计划对于我们了解底层原理,hive 调优,排查数据倾斜等很有帮助
一、EXPLAIN 参数介绍
语法 :
EXPLAIN [EXTENDED|CBO|AST|DEPENDENCY|AUTHORIZATION|LOCKS|VECTORIZATION|ANALYZE] querySql二、简单sum例子
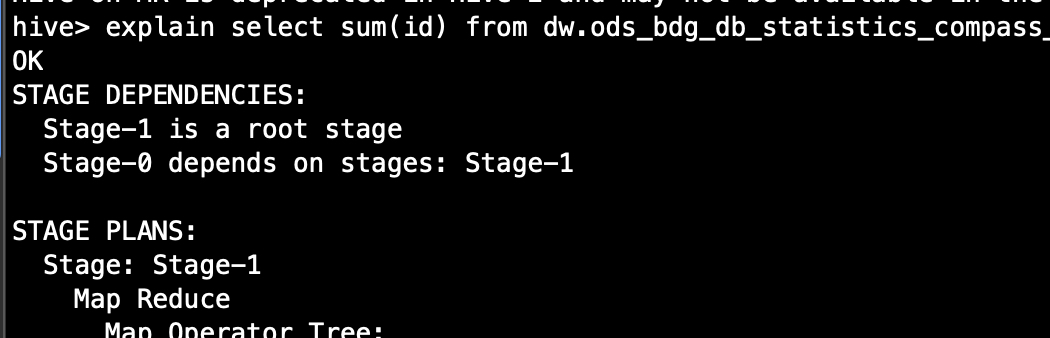
2.1 执行计划查询Sql和结果
explain select sum(id) from dw.ods_bdg_db_statistics_compass_property  where dt='20220627';

STAGE DEPENDENCIES:

  Stage-1 is a root stage

  Stage-0 depends on stages: Stage-1

STAGE PLANS:

  Stage: Stage-1

    Map Reduce

      Map Operator Tree:

          TableScan

            alias: ods_bdg_db_statistics_compass_property

            Statistics: Num rows: 7794 Data size: 31177 Basic stats: COMPLETE Column stats: NONE

            Select Operator

              expressions: id (type: int)

              outputColumnNames: id

              Statistics: Num rows: 7794 Data size: 31177 Basic stats: COMPLETE Column stats: NONE

              Group By Operator

                aggregations: sum(id)

                mode: hash

                outputColumnNames: _col0

                Statistics: Num rows: 1 Data size: 8 Basic stats: COMPLETE Column stats: NONE

                Reduce Output Operator

                  sort order:

                  Statistics: Num rows: 1 Data size: 8 Basic stats: COMPLETE Column stats: NONE

                  value expressions: _col0 (type: bigint)

      Reduce Operator Tree:

        Group By Operator

          aggregations: sum(VALUE._col0)

          mode: mergepartial

          outputColumnNames: _col0

          Statistics: Num rows: 1 Data size: 8 Basic stats: COMPLETE Column stats: NONE

          File Output Operator

            compressed: true

            Statistics: Num rows: 1 Data size: 8 Basic stats: COMPLETE Column stats: NONE

            table:

                input format: org.apache.hadoop.mapred.SequenceFileInputFormat

                output format: org.apache.hadoop.hive.ql.io.HiveSequenceFileOutputFormat

                serde: org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe

  Stage: Stage-0

    Fetch Operator

      limit: -1

      Processor Tree:

        ListSink
2.2 执行计划最外层
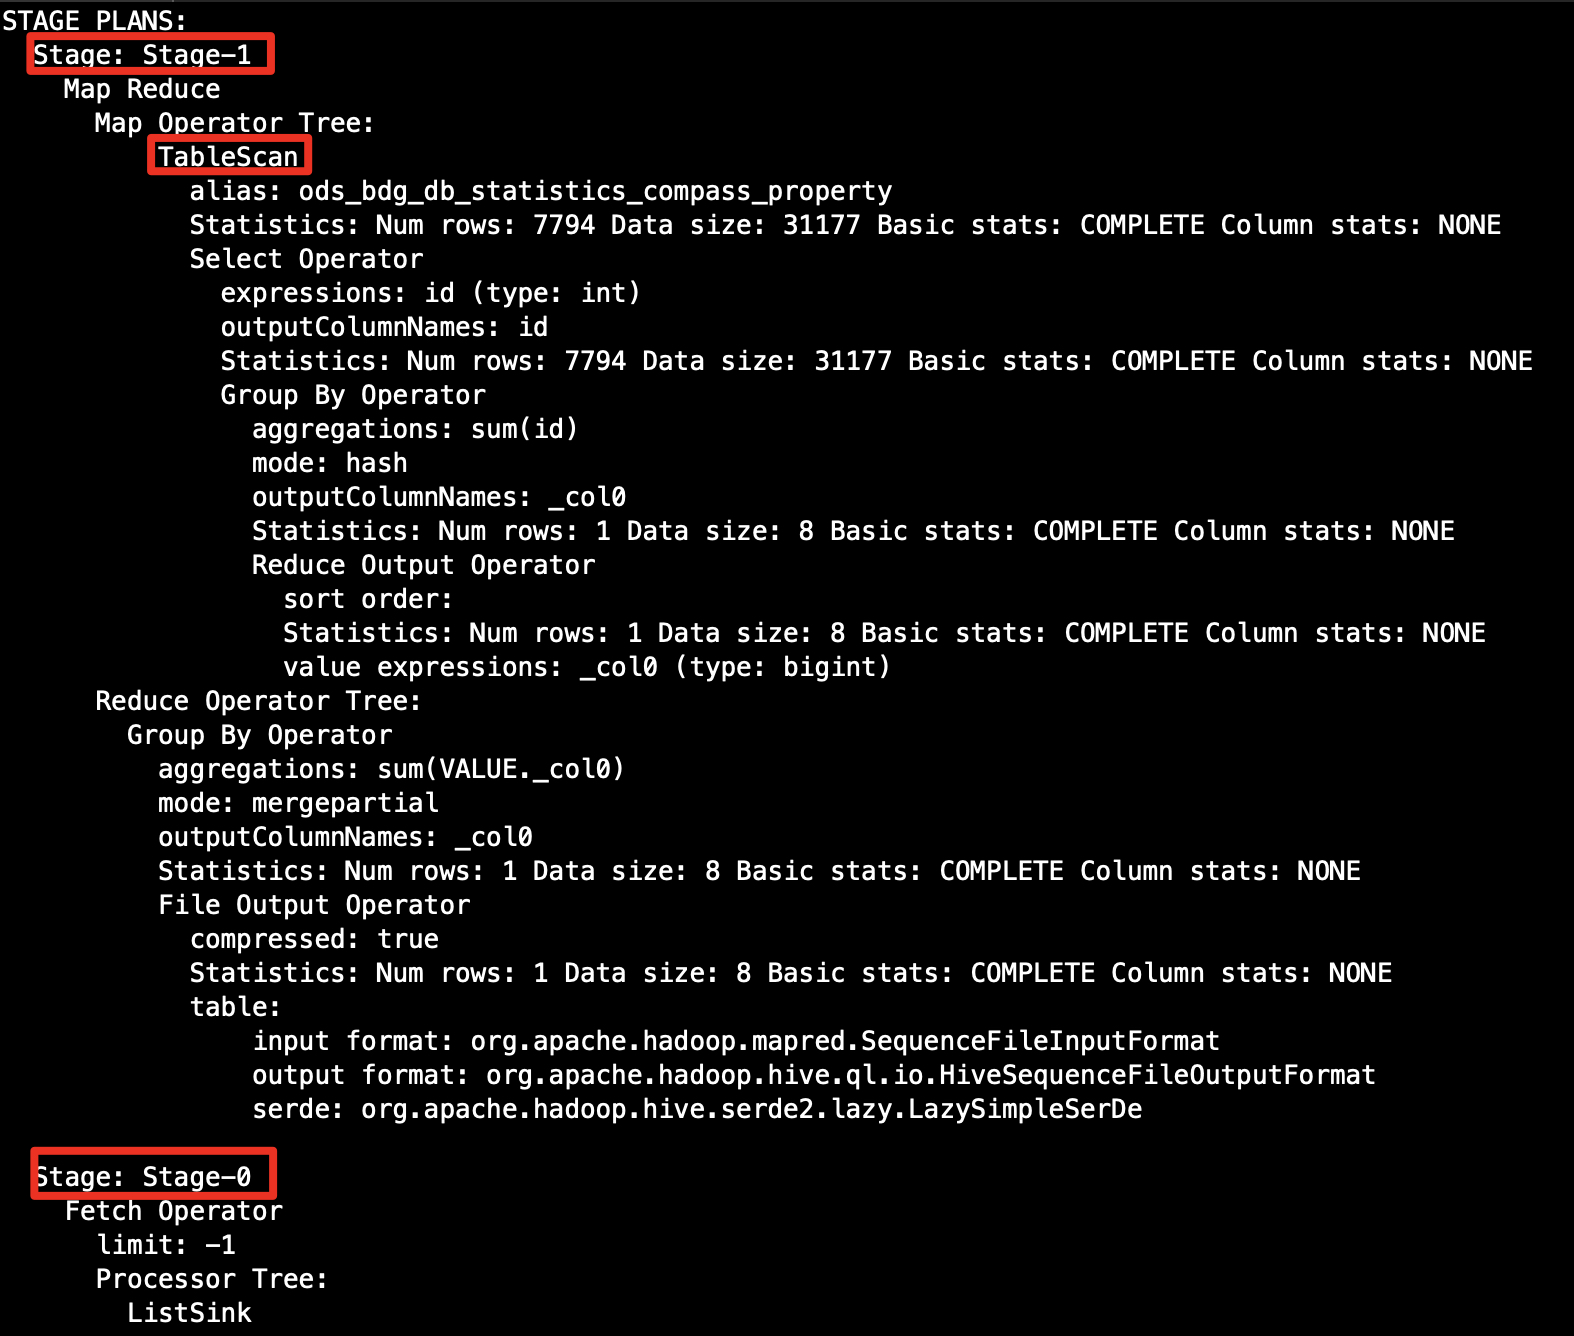
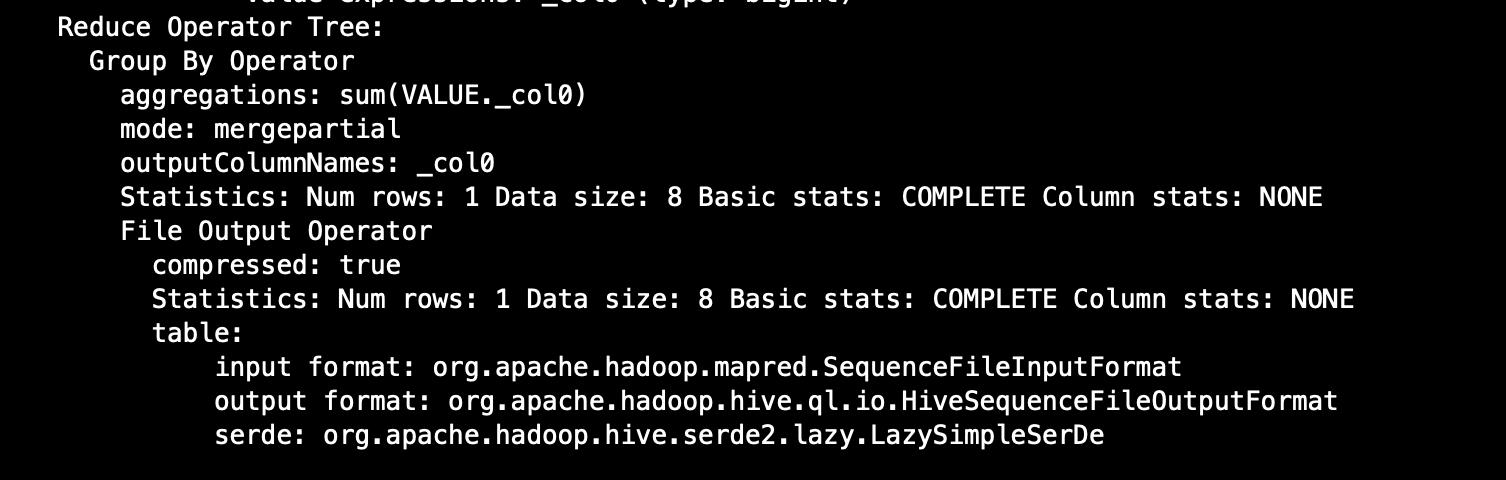
sql是sum,所以算子是group by
2.2.2.1.3 其它操作
例1

explain

SELECT

    tab1.event_id,

    tab2.id

from dw.ods_bdg_db_statistics_tab1 tab1

LEFT JOIN dw.ods_bdg_db_statistics_tab2 tab2

ON tab1.property_id = tab2.id and tab1.dt=tab2.dt

WHERE tab1.dt = '20220627'

and tab1.property_id=983

例2

explain

SELECT tab1.event_id,tab2.id

FROM (select  dt,event_id,property_id from dw.ods_bdg_db_statistics_tab1 where dt = '20220627' and property_id=983) tab1

LEFT JOIN  dw.ods_bdg_db_statistics_tab2  tab2

ON tab1.property_id = tab2.id and tab1.dt=tab2.dt

WHERE tab1.dt = '20220627'
生成的执行计划,该例子不带子查询性能要好些
left join不带子查询例子,tab2自动带筛选条件性能还高。子查询tab2没筛选,扫描数据量大一些

STAGE DEPENDENCIES:

  Stage-1 is a root stage

  Stage-0 depends on stages: Stage-1

STAGE PLANS:

  Stage: Stage-1

    Map Reduce

      Map Operator Tree:

          TableScan

            alias: tab1

            Statistics: Num rows: 789 Data size: 82063 Basic stats: COMPLETE Column stats: NONE

            Filter Operator

              predicate: (property_id = 983) (type: boolean)

              Statistics: Num rows: 394 Data size: 40979 Basic stats: COMPLETE Column stats: NONE

              Reduce Output Operator

                key expressions: property_id (type: int), dt (type: string)

                sort order: ++

                Map-reduce partition columns: property_id (type: int), dt (type: string)

                Statistics: Num rows: 394 Data size: 40979 Basic stats: COMPLETE Column stats: NONE

                value expressions: event_id (type: string)

          TableScan

            alias: tab2

            Statistics: Num rows: 7794 Data size: 31177 Basic stats: COMPLETE Column stats: NONE

            Filter Operator

              predicate: (id = 983) (type: boolean)

              Statistics: Num rows: 3897 Data size: 15588 Basic stats: COMPLETE Column stats: NONE

              Reduce Output Operator

                key expressions: id (type: int), dt (type: string)

                sort order: ++

                Map-reduce partition columns: id (type: int), dt (type: string)

                Statistics: Num rows: 3897 Data size: 15588 Basic stats: COMPLETE Column stats: NONE

      Reduce Operator Tree:

        Join Operator

          condition map:

               Left Outer Join0 to 1

          keys:

            0 property_id (type: int), dt (type: string)

            1 id (type: int), dt (type: string)

          outputColumnNames: _col1, _col10

          Statistics: Num rows: 4286 Data size: 17146 Basic stats: COMPLETE Column stats: NONE

          Select Operator

            expressions: _col1 (type: string), _col10 (type: int)

            outputColumnNames: _col0, _col1

            Statistics: Num rows: 4286 Data size: 17146 Basic stats: COMPLETE Column stats: NONE

            File Output Operator

              compressed: true

              Statistics: Num rows: 4286 Data size: 17146 Basic stats: COMPLETE Column stats: NONE

              table:

                  input format: org.apache.hadoop.mapred.SequenceFileInputFormat

                  output format: org.apache.hadoop.hive.ql.io.HiveSequenceFileOutputFormat

                  serde: org.apache.hadoop.hive.serde2.lazy.LazySimpleSerDe

  Stage: Stage-0

    Fetch Operator

      limit: -1

      Processor Tree:

        ListSink
Hive explain执行计划详解的更多相关文章
- MySQL性能分析, mysql explain执行计划详解
MySQL性能分析 MySQL性能分析及explain用法的知识是本文我们主要要介绍的内容,接下来就让我们通过一些实际的例子来介绍这一过程,希望能够对您有所帮助. 1.使用explain语句去查看分析 ...
- MySql——Explain执行计划详解
使用explain关键字可以模拟优化器执行SQL查询语句,从而知道MySQL是如何处理你的SQL语句的,分析你的查询语句或是表结构的性能瓶颈. explain执行计划包含的信息 其中最重要的字段为:i ...
- ( 转 ) MySQL高级 之 explain执行计划详解
使用explain关键字可以模拟优化器执行SQL查询语句,从而知道MySQL是如何处理你的SQL语句的,分析你的查询语句或是表结构的性能瓶颈. explain执行计划包含的信息 其中最重要的字段为:i ...
- MySQL高级 之 explain执行计划详解
使用explain关键字可以模拟优化器执行SQL查询语句,从而知道MySQL是如何处理你的SQL语句的,分析你的查询语句或是表结构的性能瓶颈. explain执行计划包含的信息 其中最重要的字段为:i ...
- MySQL高级 之 explain执行计划详解(转)
使用explain关键字可以模拟优化器执行SQL查询语句,从而知道MySQL是如何处理你的SQL语句的,分析你的查询语句或是表结构的性能瓶颈. explain执行计划包含的信息 其中最重要的字段为:i ...
- Mysql探索之Explain执行计划详解
前言 如何写出效率高的SQL语句,提到这必然离不开Explain执行计划的分析,至于什么是执行计划,如何写出高效率的SQL,本篇文章将会一一介绍. 执行计划 执行计划是数据库根据 SQL 语句和相关表 ...
- Hive底层原理:explain执行计划详解
不懂hive中的explain,说明hive还没入门,学会explain,能够给我们工作中使用hive带来极大的便利! 理论 本节将介绍 explain 的用法及参数介绍 HIVE提供了EXPLAIN ...
- 【夯实Mysql基础】mysql explain执行计划详解
原文地址 1).id列数字越大越先执行,如果说数字一样大,那么就从上往下依次执行,id列为null的就表是这是一个结果集,不需要使用它来进行查询. 2).select_type列常见的有: A ...
- mysql explain执行计划详解
1).id列数字越大越先执行,如果说数字一样大,那么就从上往下依次执行,id列为null的就表是这是一个结果集,不需要使用它来进行查询. 2).select_type列常见的有: A:simp ...
- explain 执行计划详解
id:id是一组数字,表示查询中执行select子句或操作表的顺序,如果id相同,则执行顺序从上至下,如果是子查询,id的序号会递增,id越大则优先级越高,越先会被执行. id列为null的就表是这是 ...
随机推荐
- AI让照片跳舞,人人都能是舞王!Swan下载介绍
最近,兵马俑.马斯克以及各地网友跳科目三和网红舞的视频陆续在社交媒体和朋友圈刷屏,这些大约10秒左右的视频都不是真人出镜,均由大模型生成,这种低门槛的跳舞方式引发了网友的广泛体验,掀起了一波斗舞狂潮「 ...
- 使用canal将数据同步到ROCKETMQ
概述 我们需要将数据从MYSQL写入到rocketmq.实现步骤如下: 安装canal.admin 修改配置 server: port: 8849 spring: jackson: date-form ...
- Winform窗体控件双向绑定数据模拟读写PLC数据
1.用Modbus工具模拟PLC 2.创建一个实体类 点击查看代码 internal class Data : INotifyPropertyChanged { ushort[] ushorts = ...
- 高精度计算库math.js使用踩坑记
前情 最近在做一个后端需求,需求中需要前端做一些金额数字计算,前端对于小数的计算一直都有精度问题,如0.1+0.2计算的结果并不是0.3,而是0.30000000000000004,于是引入高精度计算 ...
- Nuget Reference 丢失问题
现象 在 Visual Studio 2017 中创建一个控制台项目.创建出来的项目如下所示. 通过 NuGet 管理器,添加 Newtonsoft.Json 的 NuGet 包,安装之后,项目中添加 ...
- 【MyBatis】学习笔记11:解决字段名和属性的映射关系
[Mybatis]学习笔记01:连接数据库,实现增删改 [Mybatis]学习笔记02:实现简单的查 [MyBatis]学习笔记03:配置文件进一步解读(非常重要) [MyBatis]学习笔记04:配 ...
- Qt开源作品30-农历控件
一.前言 农历控件在国产linux中必备的控件之一,毕竟要适应国人的习惯,你看win10系统的日历,现在点开来直接就有农历在上面,非常方便人性化,所以在很多用Qt做的项目中,也有农历控件的应用场景,而 ...
- Qt音视频开发1-vlc解码播放
一.前言 最开始接触视频监控这块的时候,用的就是vlc作为解码的内核,主要是因为vlc使用简单方便,直接传入一个句柄即可,简单几行代码就可以实现一个视频流播放,很适合初学者使用,也推荐初学者用qt+v ...
- C#中串口类SerialPort类的详细用法
原文链:serialport控件的详细用法
- TIBCO Jaspersoft Studio-6.12.2连接mysql时显示时区问题
TIBCO Jaspersoft Studio-6.12.2创建mysql型的Data Adapter, 在进行连接test时弹出显示时区问题,如下图所示: 解决办法: 在Data Adapter W ...