
hdu3068-最长回文-马拉车(Manacher)算法
http://acm.hdu.edu.cn/showproblem.php?pid=3068
脑子转个弯总算看懂马拉车算法了。记录一下思路和模板。
马拉车算法是在O(n)的时间内求出最大回文子串。
一、变量和定义
为了对奇偶回文串统一处理,每个字符之间都加上一个字符,加上一个不会出现在原字符串的,
如"abba"变成"#a#b#b#a#";"aba"变成"#a#b#a#";无论是奇偶原串都变成了奇数新串,接下来对新串处理。
在一次遍历字符的过程中,变量名及意义
i:表示当前遍历到哪一个下标的字符
p[idx]:表示下标为idx的字符的回文半径,包括自身
id:目前遍历过程中能延展到最右的回文的中心点
mx:目前遍历过程中能延展到最右的下标位置,姑且称之为探测的最远长度
j:以id为中心的关于i对称的字符,在id的左边,已经遍历过了,p[j]已经确定了的
二、为何要记录每个遍历字符的回文半径呢?利用已有的信息为后面的遍历铺垫,否则就和中心扩展一样是O(n2)复杂度
1."abcecbd"加上'#'后变成"#a#b#c#e#c#b#d#"
下标 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14
内容 # a # b # c # e # c # b # d #
p[i] 1 2 1 2 1 2 1 6 1 2 1 2 1 2 1
最长回文子串"#b#c#e#c#b#"的中心字符为e,下标为7,减去p[7]之后等于1,表示最长回文子串"bcecb"在原串"abcecbd"中的下标为1(从0算起)
2."abbc"加上'#'后变成"#a#b#b#c#"
下标 0 1 2 3 4 5 6 7 8
内容 # a # b # b # c #
p[i] 1 2 1 2 3 2 1 2 1
最长回文子串"#b#b#"的中心字符为#,下标为4,减去p[4]=3之后等于1,表示最长回文子串"bb"在原串"abbc"中的下标为1(从0算起)
3."aba"加上'#'后变成"#a#b#a#"
下标 0 1 2 3 4 5 6
内容 # a # b # a #
p[i] 1 2 1 4 1 2 1
最长回文子串"#a#b#a#"的中心字符为b,下标为3,减去p[3]=4之后等于-1,与前面不一致。原串最长回文子串应该是下标从0开始,则需要向右移动1位
4.在最左边加一个字符'$'(不会在原串中出现),则变成"$#a#b#a#"
下标 0 1 2 3 4 5 6 7
内容 $ # a # b # a #
p[i] 1 1 2 1 4 1 2 1
则最长回文子串"#a#b#a#"的中心字符为b,下标为4,减去p[3]=4之后等于0,与"aba"在"aba"的起始位置一致。
再回顾前2个例子
5."#a#b#c#e#c#b#d#"在首位加上'$'
下标 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15
内容 $ # a # b # c # e # c # b # d #
p[i] 1 1 2 1 2 1 2 1 6 1 2 1 2 1 2 1
最长回文子串"#b#c#e#c#b#"的中心字符为e,下标为8,减去p[8]=6之后等于2,但是最长回文子串"bcecb"在原串"abcecbd"中的下标为1,除以2可以得到,对于上一个例子0没有影响,再通过另一个例子验证。
6."#a#b#a#"在首位加上'$'
下标 0 1 2 3 4 5 6 7 8 9
内容 $ # a # b # b # c #
p[i] 1 1 2 1 2 3 2 1 2 1
最长回文子串"#b#b#"的中心字符为#,下标为5,减去p[5]=3之后等于2,但是最长回文子串"bb"在原串"abbc"中的下标为1,除以2可以得到
7.经过多方尝试都能通过验证。
首位加上一个不相干的字符后,原串的最长回文子串起始位置=(新串的最长回文中心id-p[id])/2
三、算法过程
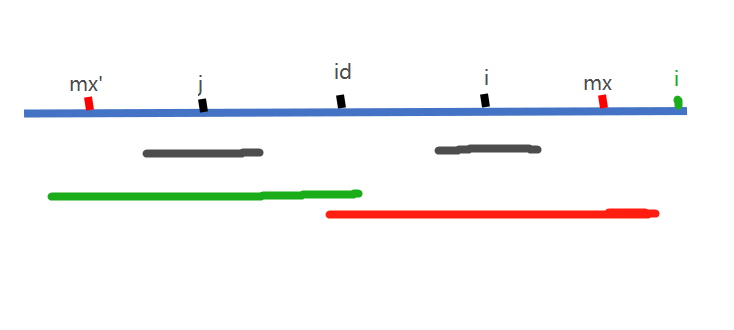
1.如果i在mx左边,则i在以id为中心的回文子串内部,则与j对称;以j为中心的回文,i必然也有,对于j的回文情况p[j],再分两种情况讨论
(1)i+p[j]使得i右边大于等于mx,即(i+p[j])>=mx,则p[i]取(mx-i)即可
(2)(i+p[j])<mx,则p[i]=p[j]
2.如果i再mx右边,则先设p[i]=1
3.暂定了p[i],仍需要中心扩展。(马拉车的精髓就在这里,一次性可能定了一个巨大的p[i],而不是每次都从1慢慢中心扩展,节省时间)
4.防止中心扩展时候某一边会越界,尾部也加个乱七八糟的字符堵住,例如'!'
#include<stdio.h>

#include<iostream>

#include<algorithm>

#include<cstring>

#include<math.h>

#include<string>

#include<map>

#include<queue>

#include<stack>

#include<set>

#include<ctime>

#define ll long long

#define inf 0x3f3f3f3f

const double pi=3.1415926;

using namespace std;

int p[*+];

int Manacher(string s)

{

    int ans=;

    int id=,mx=;

    memset(p,,sizeof(p));

    int len=s.size();

    for(int i=;i<len;i++)

    {

        int j=*id-i;///对称点

        if(mx>i) ///i在已探测的范围内

        {

            if(mx-i>=p[j])

                p[i]=p[j];

            else

                p[i]=mx-i;

        }

        else

            p[i]=;

        ///暂定了p[i],还是有可能更大,中心扩展

        while( s[ i+p[i] ] == s[ i-p[i] ] )///前后加入不相干字符,不会越界

            p[i]++;

        if(i+p[i]>mx)///更新最右点和对应的id

        {

            id=i;

            mx=id+p[id];

        }

        ans=max(ans,p[i]);

    }

    return ans-;

}

int main()

{

    ios::sync_with_stdio(false);//加速

    string str,s;

    while(cin>>str)

    {

        s="$#";

        int len=str.size();

        for(int i=;i<len;i++)

        {

            s += str[i];

            s += "#";

        }

        s=s+"!";

        cout<<Manacher(s)<<endl;

    }

    return ;

}
运用了马拉车算法,本题还有2个可能出现的坑
- 坑1:如果同c++的string输入字符串,需要加速
- 坑2:string的拼接:str =str+ "a"加的运算产生的是一个新的对象,再把结果返回,而str += "a" 涉及到的应该是对象的引用,操作之后直接返回引用,避免了产生新的对象。因此,两者的性能有一定的差距。+=的写法更快。
真的是被坑得神不知鬼不觉,T了十几发才找到错误
hdu3068-最长回文-马拉车(Manacher)算法的更多相关文章
- hdu3068 最长回文(manacher 算法)
题意: 给定字符串.求字符串中的最长回文序列 解题思路: manacher 算法 时间复杂度:O(N) 代码: #include <cstdio> #include <cstring ...
- 九度OJ 1528 最长回文子串 -- Manacher算法
题目地址:http://ac.jobdu.com/problem.php?pid=1528 题目描述: 回文串就是一个正读和反读都一样的字符串,比如"level"或者"n ...
- HDU3068:最长回文(Manacher模板)
最长回文 Time Limit: 4000/2000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Others)Total Submis ...
- lintcode最长回文子串(Manacher算法)
题目来自lintcode, 链接:http://www.lintcode.com/zh-cn/problem/longest-palindromic-substring/ 最长回文子串 给出一个字符串 ...
- 最长回文字符串(manacher算法)
偶然看见了人家的博客发现这么一个问题,研究了一下午, 才发现其中的奥妙.Stupid. 题目描述: 回文串就是一个正读和反读都一样的字符串,比如“level”或者“noon”等等就是回文串. ...
- Palindrome(最长回文串manacher算法)O(n)
Palindrome Time Limit:15000MS Memory Limit:65536KB 64bit IO Format:%I64d & %I64u Submit ...
- 最长回文子串—Manacher 算法 及 python实现
最长回文子串问题:给定一个字符串,求它的最长回文子串长度.如果一个字符串正着读和反着读是一样的,那它就是回文串. 给定一个字符串,求它最长的回文子串长度,例如输入字符串'35534321',它的最 ...
- hihocoder #1032 : 最长回文子串 Manacher算法
题目链接: https://hihocoder.com/problemset/problem/1032?sid=868170 最长回文子串 时间限制:1000ms内存限制:64MB 问题描述 小Hi和 ...
- 第5题 查找字符串中的最长回文字符串---Manacher算法
转载:https://www.felix021.com/blog/read.php?2040 首先用一个非常巧妙的方式,将所有可能的奇数/偶数长度的回文子串都转换成了奇数长度:在每个字符的两边都插入一 ...
随机推荐
- java - mybatis:java.lang.IllegalArgumentException: Mapped Statements collection does not contain value for
当遇见java.lang.IllegalArgumentException: Mapped Statements collection does not contain value for 错误的时候 ...
- JVM&NIO&HashMap简单问
JVM&NIO&HashMap简单问 背景:前几天在网上看到关于JVM&NIO&HashMap的一些连环炮的面试题,整理下以备不时之需. 一.JVM Java的虚拟机的 ...
- client-go客户端自定义开发Kubernetes及源码分析
介绍 client-go 是一种能够与 Kubernetes 集群通信的客户端,通过它可以对 Kubernetes 集群中各资源类型进行 CRUD 操作,它有三大 client 类,分别为:Clien ...
- springboot2 中Druid和ibatis(baomidou) 遇到org.apache.ibatis.binding.BindingException: Invalid bound statement (not found): com.iflytek.pandaai.service.multi.mapper.TanancyMapper
调用mapper中任何方法都会出现类似的错误 org.apache.ibatis.binding.BindingException: Invalid bound statement (not foun ...
- 七、Spring之深入理解AOP源码
Spring之深入理解AOP源码 在上一篇博文中,我们对AOP有了初步的了解,那么接下来我们就对AOP的实现原理进行深入的分析. 在之前写的那个AOP示例代码当中有这样一个注解:@Enable ...
- axios 源码分析(上) 使用方法
axios是一个基于Promise 用于浏览器和 nodejs 的 HTTP 客户端,它可以在浏览器和node环境下运行,在github上已经有六七万个星了,axios使用很方便,很多人在使用他,vu ...
- 大咖云集!Kubernetes and Cloud Native Meetup 深圳站开始报名!
由阿里技术生态联合 CNCF 官方共同出品的 Kubernetes & Cloud Native Meetup 将在 8 月 31 日来到深圳.届时,阿里云.蚂蚁金服高级技术专家将携手来自国内 ...
- 机器学习(九)-------- 聚类(Clustering) K-均值算法 K-Means
无监督学习 没有标签 聚类(Clustering) 图上的数据看起来可以分成两个分开的点集(称为簇),这就是为聚类算法. 此后我们还将提到其他类型的非监督学习算法,它们可以为我们找到其他类型的结构或者 ...
- 5种IO模型、阻塞IO和非阻塞IO、同步IO和异步IO
POSIX 同步IO.异步IO.阻塞IO.非阻塞IO,这几个词常见于各种各样的与网络相关的文章之中,往往不同上下文中它们的意思是不一样的,以致于我在很长一段时间对此感到困惑,所以想写一篇文章整理一下. ...
- 简单ALV得演示(用到了ALV可编辑及保存后修改数据库)
*&---------------------------------------------------------------------* *& Report YPMRP010_ ...