
【java爬虫】利用webmagic框架实战demo
webmagic框架:http://webmagic.io/
WebMagic的结构分为Downloader、PageProcessor、Scheduler、Pipeline四大组件
PageProcessor主要分为三个部分,分别是爬虫的配置、页面元素的抽取和链接的发现。
Pipeline用于保存结果的组件,下面我们实现自定义Pipeline,可以实现保存结果到文件、数据库等一系列功能
很多功能自己进去慢慢研究哈,这里就不一一赘述了。
下面直接进入主题,爬我的博客首页的数据:https://www.cnblogs.com/loaderman/
查看首页的源码研究一下下:

第一步:maven配置webmagic 详见:http://webmagic.io/docs/zh/posts/ch2-install/with-maven.html
第二步:直接根据文档进行编码实战:
定义实体类
public class LoadermanModel {

    private String title;

    private String detailUrl;

    private String content;

    private String date;

    public LoadermanModel() {

    }

    public LoadermanModel(String title, String detailUrl, String content, String date) {

        this.title = title;

        this.detailUrl = detailUrl;

        this.content = content;

        this.date = date;

    }

    public String getTitle() {

        return title;

    }

    public void setTitle(String title) {

        this.title = title;

    }

    public String getDetailUrl() {

        return detailUrl;

    }

    public void setDetailUrl(String detailUrl) {

        this.detailUrl = detailUrl;

    }

    public String getContent() {

        return content;

    }

    public void setContent(String content) {

        this.content = content;

    }

    public String getDate() {

        return date;

    }

    public void setDate(String date) {

        this.date = date;

    }

}
自定义PageProcessor
import us.codecraft.webmagic.Page;

import us.codecraft.webmagic.Site;

import us.codecraft.webmagic.processor.PageProcessor;

import us.codecraft.webmagic.selector.Html;

import java.util.ArrayList;

import java.util.List;

public class LoadermanPageProcessor implements PageProcessor {

    // 部分一:抓取网站的相关配置,包括编码、抓取间隔、重试次数等

    private Site site = Site.me().setRetryTimes(5).setUserAgent("User-Agent: Mozilla/5.0 (Windows NT 6.1; Win64; x64; rv:70.0) Gecko/20100101 Firefox/70.0");

    @Override

    public void process(Page page) {

        List<String> pageItemList = page.getHtml().xpath("//div[@class='post']").all();

        ArrayList<LoadermanModel> list = new ArrayList<>();

        for (int i = 0; i < pageItemList.size(); i++) {

            Html html = Html.create(pageItemList.get(i));

            LoadermanModel loadermanModel=new LoadermanModel();

            loadermanModel.setTitle(html.xpath("//a[@class='postTitle2']/text()").toString() );

            loadermanModel.setDetailUrl(html.xpath("//a[@class='postTitle2']").links().toString());

            loadermanModel.setContent(html.xpath("//div[@class='c_b_p_desc']/text()").toString() );

            loadermanModel.setDate(html.xpath("//p[@class='postfoot']/text()").toString() );

            list.add(loadermanModel);

        }

        page.putField("data", list);

        if (page.getResultItems().get("data") == null) {

            //skip this page

            page.setSkip(true);

        }

    }

    @Override

    public Site getSite() {

        return site;

    }

}
自定义Pipeline,,对爬取后的数据提取和处理
import com.alibaba.fastjson.JSON;

import us.codecraft.webmagic.ResultItems;

import us.codecraft.webmagic.Task;

import us.codecraft.webmagic.pipeline.Pipeline;

import us.codecraft.webmagic.utils.FilePersistentBase;

import java.io.FileWriter;

import java.io.IOException;

import java.io.PrintWriter;

public class LoadermanlPipeline extends FilePersistentBase implements Pipeline {

    public LoadermanlPipeline(String path) {

        this.setPath(path);

    }

    public void process(ResultItems resultItems, Task task) {

        String path = "LoadermanlPipelineGetData";

        try {

            PrintWriter printWriter = new PrintWriter(new FileWriter(this.getFile(path+ ".json")));

            printWriter.write(JSON.toJSONString(resultItems.get("data")));

            printWriter.close();

        } catch (IOException var5) {

        }

    }

}
开启爬虫:
    Spider.create(new LoadermanPageProcessor())

                .addUrl("https://www.cnblogs.com/loaderman/")

                //自定义Pipeline,保存json文件到本地

                .addPipeline(new LoadermanlPipeline("D:\\loaderman\\"))

                //开启5个线程抓取

                .thread(5)

                //启动爬虫

                .run();
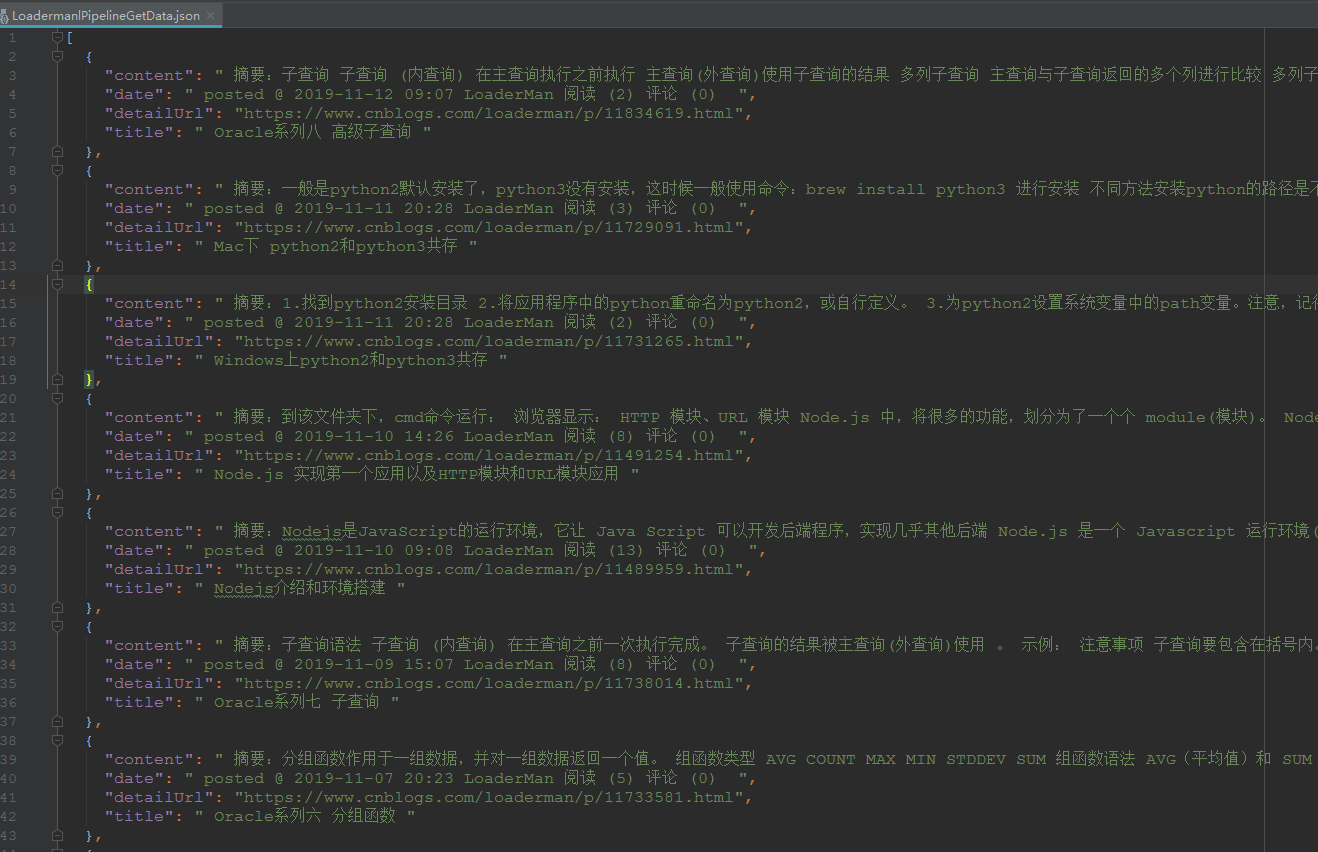
效果如下:
搞定!
【java爬虫】利用webmagic框架实战demo的更多相关文章
- 学校实训作业:Java爬虫(WebMagic框架)的简单操作
项目名称:java爬虫 项目技术选型:Java.Maven.Mysql.WebMagic.Jsp.Servlet 项目实施方式:以认知java爬虫框架WebMagic开发为主,用所学java知识完成指 ...
- Java 爬虫之Webmagic
1. 一个框架,一个领域 一个好的框架必然凝聚了领域知识.WebMagic的设计参考了业界最优秀的爬虫Scrapy,而实现则应用了HttpClient.Jsoup等Java世界最成熟的工具,目标就是做 ...
- JAVA 爬虫框架webmagic 初步使用Demo
一想到做爬虫大家第一个想到的语言一定是python,毕竟python比方便,而且最近也非常的火爆,但是python有一个全局锁的概念新能有瓶颈,所以用java还是比较牛逼的, webmagic 官网 ...
- Java爬虫框架WebMagic——入门(爬取列表类网站文章)
初学爬虫,WebMagic作为一个Java开发的爬虫框架很容易上手,下面就通过一个简单的小例子来看一下. WebMagic框架简介 WebMagic框架包含四个组件,PageProcessor.Sch ...
- JAVA爬虫实践(实践三:爬虫框架webMagic和csdnBlog爬虫)
WebMagic WebMagic是一个简单灵活的Java爬虫框架.基于WebMagic,你可以快速开发出一个高效.易维护的爬虫. 采用HttpClient可以实现定向的爬虫,也可以自己编写算法逻辑来 ...
- Java爬虫框架WebMagic入门——爬取列表类网站文章
初学爬虫,WebMagic作为一个Java开发的爬虫框架很容易上手,下面就通过一个简单的小例子来看一下. WebMagic框架简介 WebMagic框架包含四个组件,PageProcessor.Sch ...
- Java爬虫框架之WebMagic
一.介绍 WebMagic是一个简单灵活的Java爬虫框架.基于WebMagic,你可以快速开发出一个高效.易维护的爬虫. 二.如何学习 1.查看官网 官网地址为:http://webmagic.io ...
- Java爬虫框架 | 爬小说
Jsoup,Java爬虫解决方案,中文文档:jsoup 不得不说Java的生态真的好,原来我以为爬虫是只能用Pyhton来写的,结果发现Java的爬虫框架不要太多…… 一分钟你就可以写 ...
- webmagic的设计机制及原理-如何开发一个Java爬虫
之前就有网友在博客里留言,觉得webmagic的实现比较有意思,想要借此研究一下爬虫.最近终于集中精力,花了三天时间,终于写完了这篇文章.之前垂直爬虫写了一年多,webmagic框架写了一个多月,这方 ...
随机推荐
- golang读写文件之Scan和Fprintf
1. 标准输入输出 os提供了标准输入输出: Stdin = NewFile(uintptr(syscall.Stdin), "/dev/stdin") Stdout = NewF ...
- vue 父组件与子组件的三生三世
父组件和子组件相互传值:https://www.cnblogs.com/cxscode/p/11187989.html vue父组件触发子组件方法:https://www.cnblogs.com/cx ...
- MySQL/MariaDB数据库的用户和权限管理
MySQL/MariaDB数据库的用户和权限管理 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.元数据数据库(mysql) 系统授权表(均在mysql数据库中): db hos ...
- Pure C static coding analysis tools
Cppcheck - A tool for static C/C++ code analysiscppcheck.sourceforge.netCppcheck is a static analysi ...
- 微信小程序~上拉加载onReachBottom
代码: //页面上拉触底事件的处理函数 onReachBottom(e) { console.log("底部")// 滚动到页面执行 该 方法 wx.showToast({ tit ...
- .NET下各种可用的HTML解析组件
做数据抓取,网络爬虫方面的开发,自然少不了解析HTML源码的操作.那么问题来了,到底.NET如何来解析HTML,有哪些解析HTML源码的好用的,有效的组件呢? 作者在开始做这方面开发的时候就被这些 ...
- python开发笔记-如何做数据准备
时间格式: >>> from datetime import date >>> firstday = date.fromtimestamp(1464010200) ...
- session内置对象
SimpleDateFormat sdf = new SimpleDateFormat(yyyy年MM月dd日) //处理日期格式 session.getCreationDate() 是获取sess ...
- linux 出错 “INFO: task java: xxx blocked for more than 120 seconds.” 的3种解决方案
1 问题描述 最近搭建的一个linux最小系统在运行到241秒时在控制台自动打印如下图信息,并且以后每隔120秒打印一次. 仔细阅读打印信息发现关键信息是“hung_task_timeout_secs ...
- Minidumps 和 modules匹配
简介 调试应用程序时,调试器必须加载可执行模块的符号,以便能够显示有意义的调用堆栈.当前源代码行.变量值等.如果您曾经调试过在另一个系统上创建的小型转储,那么您已经知道除了符号之外,调试器还需要访问创 ...