
ClustrixDB-new数据库
ClustrixDB是一种集群式RDBMS,可确保事务处理符合ACID特性,同时可轻松的提供可扩展性和容错能力。 ClustrixDB集群由三个或更多节点(联网的同构服务器)组成。
ClustrixDB使用无共享架构。集群中的每个节点可以执行任何读取或写入操作。如果要扩充数据库容量,只需添加更多节点即可。
ClustrixDB的主要组件有助于实现性能和规模:
1) 全局事务管理器(GTM),协调给定事务的处理。
2) Rebalancer,它在集群中自动分配数据。
3) Sierra数据库引擎,确定最佳查询执行计划,然后在分布式数据节点上执行该计划。
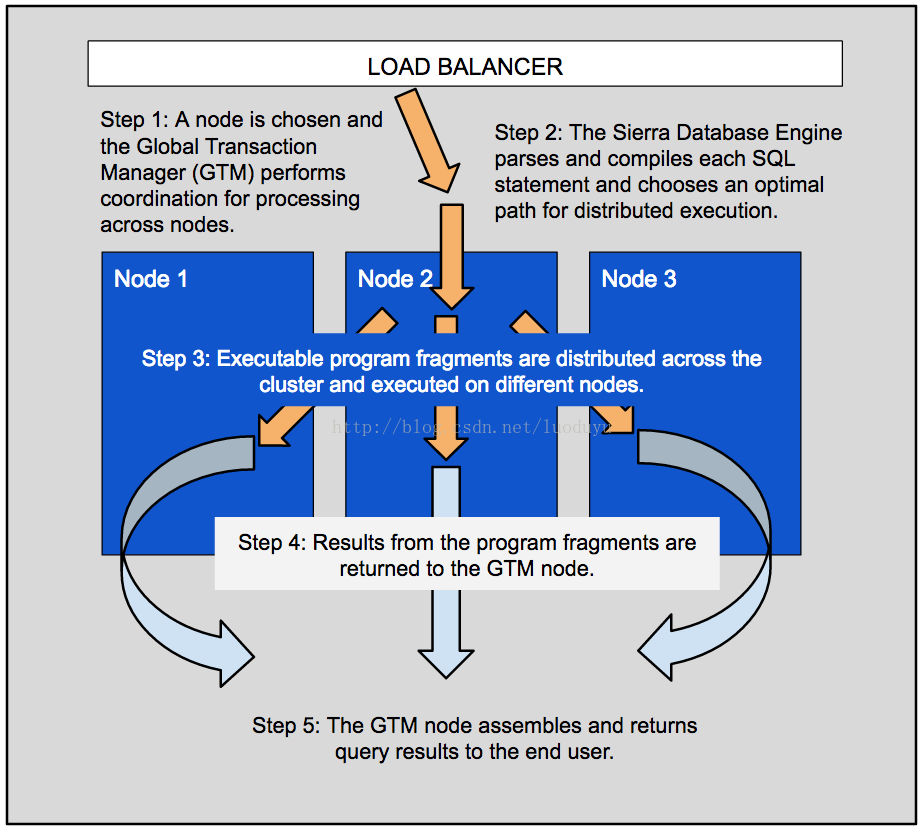
下图显示了ClustrixDB如何处理典型的查询。
全局事务管理器
通常通过横跨集群上分布式连接的负载均衡器,选择集群中的一个节点作为全局事务管理器(GTM)来开始处理ClustrixDB中的查询。然后在返回结果给调用者之前,GTM通过控制执行查询的每个一步、确认每一步成功完成、收集和确定执行结果等来全面管理事务。
ClustrixDB将查询编译为可执行查询片段,GTM将其分发到适当的节点以供执行。当中间结果可用时,它们将返回给GTM。一旦所有查询片段都已成功执行,GTM就完成结果并将它们返回给客户端,应用程序或用户。
Rebalancer
如果ClustrixDB的数据以前未在整个集群中分布,则不可能进行分布式处理。为了实现这一点,ClustrixDB使用了由其Rebalancer管理的专利数据分配方法。Rebalancer在集群中编排数据,以确保读取和写入始终平衡。它还保证在整个集群中维护数据的多个副本(副本)以确保容错。如果节点由于意外故障而丢失,则不会丢失任何数据。Rebalancer将自动确保创建和维护冗余副本。它还通过在添加新节点时将数据重新平衡到新节点并且在数据库保持在线的同时将数据从标记为要移除的节点移开而适应集群集大小的改变。
Rebalancer使用一致的散列算法将每个表行分配给该表的给定“切片”,并提供所有切片到每个节点的映射。这允许ClustrixDB快速轻松地确定相关数据的位置。Rebalancer在后台连续运行,不会影响正在进行的数据处理。
虽然数据被切片并分发到集群的许多节点,但是数据库表将始终作为应用程序的单个逻辑单元出现。Clustrix使用简单的SQL接口,并且不需要特殊的应用程序编程来访问分布在整个ClustrixDB集群中的数据。
如果ClustrixDB的数据以前未在整个集群中分布,则不可能进行分布式处理。为了实现这一点,ClustrixDB使用由其Rebalancer管理的专利数据分配方法。Rebalancer在集群中安排数据,以确保读取和写入始终平衡。它还保证在整个集群中维护数据的多个副本(副本)以确保容错。如果节点由于意外故障而丢失,则不会丢失任何数据。重新平衡器将自动确保创建和维护冗余副本。它还通过在添加新节点时将数据重新平衡到新节点并且在数据库保持在线的同时将数据从标记为要移除的节点移开而适应群集的改变大小。
Rebalancer使用一致的散列算法将每个表行分配给该表的给定“切片”,并提供所有切片到每个节点的映射。这允许ClustrixDB快速轻松地确定相关数据的位置。再平衡器在后台连续运行,不会影响正在进行的生产加工。
下面这张图片展示了Rebalancer如何横跨各个节点的的'切片'和表复制。请注意表的复制是如何分散在整个集群中的,以确保容错。在不同节点上的每个表切片至少是按时及复制的。
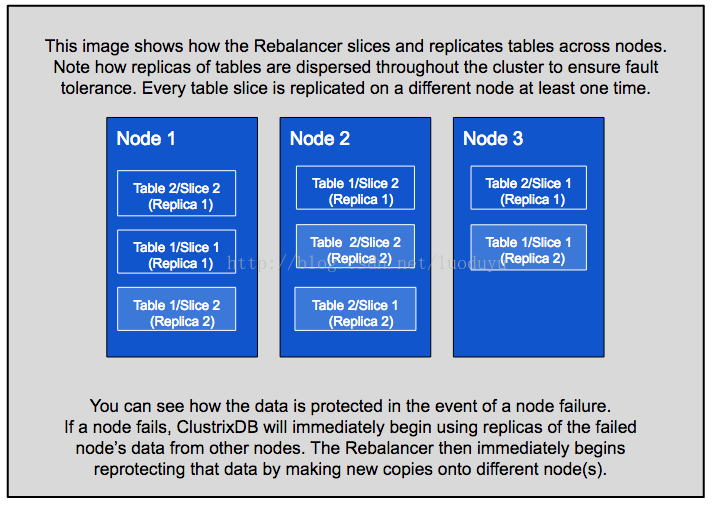
您可以看到在节点故障的情况下如何保护数据。如果节点故障,ClustrixDB将立即开始使用来自其他节点的故障节点数据的副本。然后Rebalancer立即开始通过将新副本复制到不同的节点上来重新定位该数据节点。
欲知详情请移步ClustrixDB’s Rebalancer。
Sierra数据库引擎
Sierra是处理查询计划和执行的ClustrixDB的SQL引擎。它专门设计用于在分布式、无共享(shared nothing)环境中工作,同时尽可能高效地访问分布式数据。Sierra数据库引擎由两部分组成:
1)Sierra Parallel Planner 确定SQL语句的最佳执行计划。
2)Sierra分布式执行引擎 根据计划执行查询片段,并提供中间结果。
Sierra Parallel Planner是一种基于成本的优化器,它使用概率统计,数据量,索引和查询运算符的开销来确定最有效的查询计划。 ClustrixDB Planner 的一个关键区别功能是它确定此计划,同时考虑数据在集群中的分布。

有关演示此查询分段如何工作的其他示例,请参阅ClustrixDB Sierra Database Engine.
Sierra分布式执行引擎
一旦Sierra Planner确定了查询的最佳计划,它就被编译成机器可执行的查询片段。然后,这些编译的查询片段在集群中的不同节点上执行,提供了效率和增加的执行并发性。一旦每个节点上的执行完成,结果就返回到GTM节点,GTM节点然后组合部分结果并将最终结果集返回给用户。
ClustrixDB如何能够独特地利用其分布式执行以实现更快的结果的一个示例是分布式聚合处理。除了首先对每个节点的分布式数据上的数据计算部分聚合(SUM,MAX,MIN,AVG等)之外,计算类似于其它查询被分段和分布。中间结果然后由GTM合并以产生最终结果。
最后再让我们来看下在ClustrixDB中的分布查询。

结论
ClustrixDB使用自动数据分发,复杂的查询计划器和分布式执行模型,以在符合ACID的RDBMS中提供可扩展性和并发性。为了实现这一点,ClustrixDB使用了许多与其他大规模并行处理(MPP)数据库使用的相同的技术:它使用Paxos进行分布式事务解析,并使用多版本并发控制(MVCC)来防止事务冲突。 借助上述主要组件,ClustrixDB为这种分布式执行提供了一个简单的SQL接口,同时还提供了可扩展性,效率和容错能力。
————————————————
版权声明:本文为CSDN博主「罗斗鱼」的原创文章,遵循CC 4.0 BY-SA版权协议,转载请附上原文出处链接及本声明。
原文链接:https://blog.csdn.net/luoduyu/article/details/53997249
ClustrixDB-new数据库的更多相关文章
- JSP应用开发 -------- 电纸书(未完待续)
http://www.educity.cn/jiaocheng/j9415.html JSP程序员常用的技术 第1章 JSP及其相关技术导航 [本章专家知识导学] JSP是一种编程语言,也是一种动 ...
- 36. ClustrixDB 使用ClustrixDB加密连接
ClustrixDB使用sha256_password插件支持SSL和身份验证. 一些安全规则要求对存储在数据库中的用户密码进行更强的保护.与默认的mysql_native_password插件相比, ...
- 35. ClustrixDB 减少device1大小
ClustrixDB中的device1文件用于所有数据库数据.撤消日志.临时表.binlog和ClustrixDB系统对象.ClustrixDB确保device1文件在集群的所有节点上大小相同.一旦得 ...
- 34. ClustrixDB 降低集群的容量-Flex down
有时,可能需要减少集群的容量: 减少高峰事件后的运营成本 为其他目的分配服务器. 删除故障硬件.(参见删除ALTER CLUSTER以删除永久失败的节点.) 在ClustrixDB中缩小集群的过程很简 ...
- 32. ClustrixDB License管理
一.许可的概述 ClustrixDB必须拥有有效的许可证才能运行.本授权指定: 集群中允许的最大节点数 ClustrixDB将使用的最大核数 在裸金属系统上,ClustrixDB将尝试启用与已授权的物 ...
- 31. ClustrixDB 分布式架构/查询优化器
ClustrixDB查询优化器有何不同 ClustrixDB查询优化器的核心是能够执行一个具有最大并行性的查询和多个具有最大并发性的并发查询.这是通过分布式查询规划器和编译器以及分布式无共享执行引擎实 ...
- 7. ClustrixDB 集群管理
一. ALTER CLUSTER ADD (Flex Up): 添加节点以增加集群大小 添加节点过程: 步骤1.准备节点 提供节点并在每个节点上安装ClustrixDB,使用相同的版本和安装配置.如 ...
- 29. ClustrixDB 分布式架构/并发控制
介绍 ClustrixDB使用多版本并发控制(MVCC)和2阶段锁(2PL)的组合来支持混合的读写工作负载.在我们的系统中,读取器享受无锁快照隔离,而写入器使用2PL来管理冲突.并发控制的组合意味着读 ...
- 28. ClustrixDB 分布式架构/评估模型
本节描述如何在数据库中计算查询.在ClustrixDB中,我们跨节点切片数据,然后将查询发送到数据.这是数据库的基本原则之一,它允许随着添加更多节点而几乎线性地扩展. 有关如何分布数据的概念,请参阅数 ...
- 27. ClustrixDB 分布式架构/一致性、容错和可用性
一致性 许多分布式数据库都采用最终一致性而不是强一致性来实现可伸缩性.但是,最终的一致性会增加应用程序开发人员的复杂性,他们必须针对可能出现的数据不一致的异常进行开发. ClustrixDB提供了一个 ...
随机推荐
- MarkDown用法学习笔记
标题: 用 '#'标识,可以到从1到6级标题设置,有多少个'#'符号就对应多少级标题 粗体: 用''标识,如果两边只有一个''标识是斜体,如果两有2个这符号标题是加粗,如果有3个这符号标识是斜体和加粗 ...
- 2款使用.NET开发的数据库系统
前言 今天大姚给大家分享2款使用.NET开发且开源的数据库系统. Garnet Garnet是一款由微软研究院基于.NET开源的高性能.跨平台的分布式缓存存储数据库,该项目提供强大的性能(吞吐量和延迟 ...
- UE4纯C++实现游戏快捷栏之创建快捷栏UI
作为一个在游戏界面中显示的快捷栏,我们需要在游戏运行时就显示出快捷栏UI,故我们创建两个Widget. 1.GameHUDWidget:负责游戏中界面UI的整体显示 2.ShortcutWidget: ...
- MySQL造数据,批量插入数据脚本
新建表 create table bigdata( name varchar(32), age int(32), createTime datetime); MySQL批量插入数据脚本 #!/bin/ ...
- ARC133D Range XOR
ARC133D Range XOR 题目链接:[ARC133D] Range XOR 非常好数位 dp. 思路 根据异或的前缀和,我们可以把式子化成这样. \[\sum_{i=l}^r\sum_{j= ...
- TPC-H、TPC-H、TPC-DS部署测试
TPC-H.TPC-H.TPC-DS部署测试 概述 TPC-C TPC-C是业界常用的一套Benchmark,用于评估在线事务处理(OLTP)系统性能的基准测试.它模拟了一个商品批发公司的销售模型,包 ...
- python 爬虫基本玩法,统计杭电oj题目正确率并排序
python爬虫主要用两个库:Urllib和BeautifulSoup4.一个用来爬取网页,一个用来解析网页. Urllib是Python内置的HTTP请求库,它包含四个模块: 1.request,最 ...
- Mysql分页实现及优化
通常,我们会采用ORDER BY LIMIT start, offset 的方式来进行分页查询.例如下面这个SQL: SELECT * FROM `t1` WHERE ftype=1 ORDER BY ...
- Apache+JK+Tomcat 负载平衡配置
网 上关于 Apache + JK + Tomcat 的集群配置例子很多,按着例子配置下来,基本都能运行,不过,在一些重要的地方却没有进一步的说明.这次公司一个产品就是采用Apache+JK+Tomc ...
- vue3-组件通信
Vue3组件通信和Vue2`的区别: 移出事件总线,使用mitt代替 vuex换成了pinia 把.sync优化到了v-model里面 把$listeners所有的东西,合并到$attrs $chil ...