
ULMFiT 阅读笔记
ULMFiT 阅读笔记
概述
这篇文章从文本分类模型入手,主要提出了两点:一是预训练语言模型在大中小规模的数据集中都能提升分类效果,在小规模数据集中效果尤为显著。二是提出了多种预训练的调参方法,包括Discriminative Fine-tuning(分层微调。我自己取的名字,下同),Slanted triangular learning rates(斜三角学习率),Concat pooling(拼接池化),Gradual unfreezing(逐层解冻),双向语言模型等。
模型
本文以LSTM为基本单元设计了一个单向的语言模型,并将整个训练过程从预训练到最终训练分类器分为3个部分。
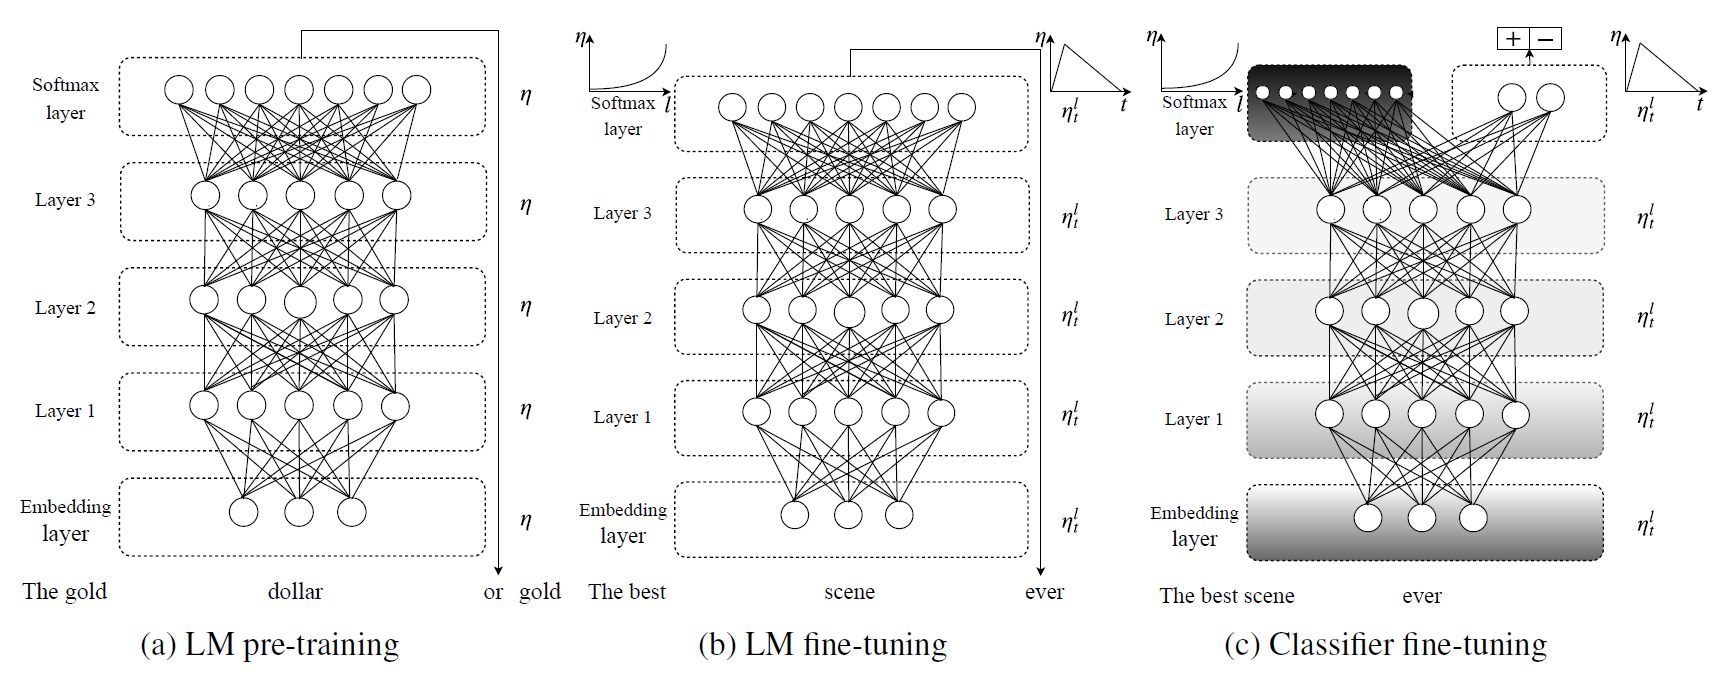
- 第一部分:语言模型预训练。使用Wikitext-103数据集训练语言模型。
- 第二部分:语言模型微调。使用分层微调和斜三角学习率,在目标任务的数据集上微调语言模型的参数,学习该任务的语言特征。
- 第三部分:固定语言模型的softmax层,将分类层加入到模型中,使用逐层解冻、分层微调、斜三角学习率等方法,在保留低层表示信息的情况下,对模型高层参数参数进行微调。
作者还尝试了双向语言模型,不过其本质是两个独立的单向模型,最后再进行拼接整合用于分类。
微调方法
分层微调
每一层使用不同的学习率。通过尝试,作者发现先确定顶层的学习率,其余层与层之间的学习率排列在一起构成一个等比数列,公比取1/2.6效果比较好。即n_l-1 = n_l/2.6。
斜三角学习率
先上图,0.01是设定好的学习率超参:
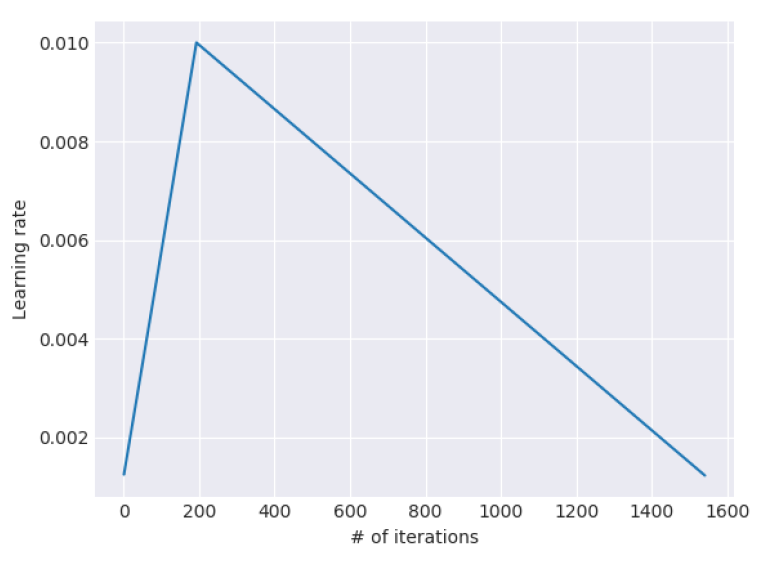
注意横坐标单位是迭代总次数。
上公式:

- T: 预设的总迭代轮数,等于epoch * 每个epoch中的batch数。我感觉可能要尝试一下初次训练在什么时候取得最优值,然后设置稍大一些,可能比较好。
- cut_frac: 学习率上升部分的iteration比例,一般10%。BERT官方代码中,warm up的这个比例也是10%。cut表示上升部分的迭代次数。
- 第二个公式p看起来复杂,我们代入3个点进去就知道了。t=0和t=cut代进去,得到p=0和p=1,表明学习率上升过程的线性变化,t=cut和p=0代进去,得到p=1和t=T,表明学习率下降过程的线性变化。
- ratio的目的是保证学习率不降为0。p->1时,n_t->n_max。这和n_t=p*n_max是等价的。p->0时,n_t->1/ratio,相当于将点(0,0)挪到了(0, 1/ratio),给学习率设置了一个下限,避免学习率变为0。当然,当迭代次数超过T以后,学习率还是可能变为0。
拼接池化
正常在使用单向LSTM进行分类任务时,都是将最后时刻的输出作为softmax的输入,然后进行分类。作者认为决定分类结果的关键词语可能出现在文本的任意位置,而输入文本有可能包含数百个词语,如果只考虑最后时刻的输出,信息可能丢失,因此作者设计了拼接池化。作者将每个时刻的输出放到一起,做了max-pooling和mean-pooling两种操作,得到两个向量,然后将这俩向量拼接到最后时刻的输出h_T后面,构成完整地特征向量,作为softmax层的输入用于分类
思考:为什么不使用attention机制呢?池化和attention相比有何优劣
逐层解冻
作者认为同时微调所有层可能为导致模型遗忘了预训练时学到的参数,从而跳出最优解(我们假定预训练时学到的参数已经是全局最小值),最终困于局部极小值而无法回到预训练中学到的全局最小值。
作者先解冻最后一层,固定低层参数不变,然后开始训练。每一轮次训练结束后,由高到低解冻一层参数,直到所有层的参数都被微调并且模型收敛。
该方法和2017年提出的chain-thaw很像,区别是chain-thaw每次只训练一层,作者每次多训练一层。
实验和分析
作者使用了6个数据集进行尝试:
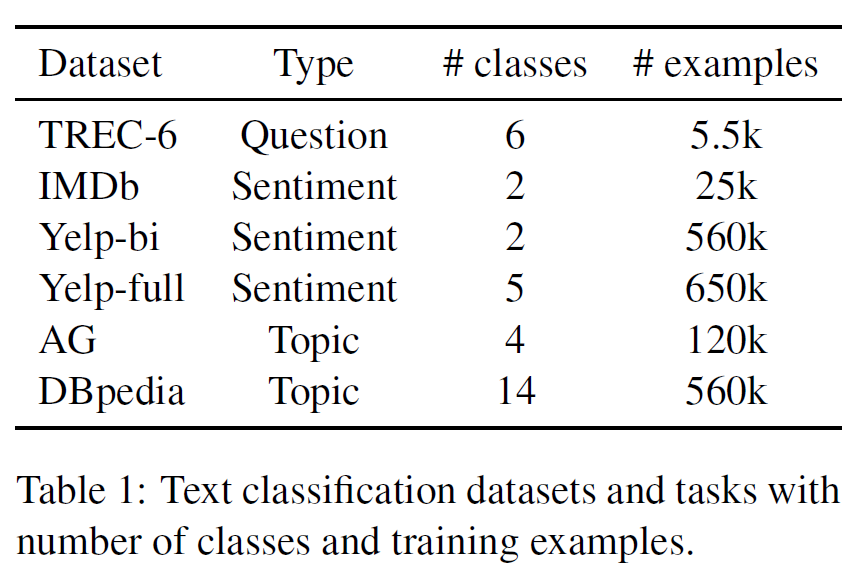
重点关注TREC-6、IMDb和AG,他们分别代表不同类型、不同数据量级的数据集。
实验1:验证ULMFiT模型有效性。在所有模型中达到了SOTA,越大的数据集效果越明显。
实验2:验证相同模型下,预训练带来的效果提升。越小的数据集效果越明显。
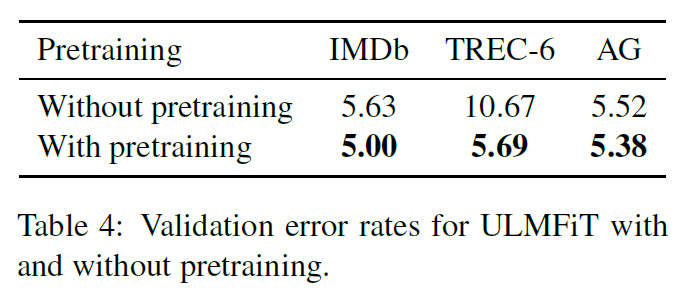
实验3:LM fine-tuning过程中分层微调和斜三角学习率的效果。STLR的效果十分明显。
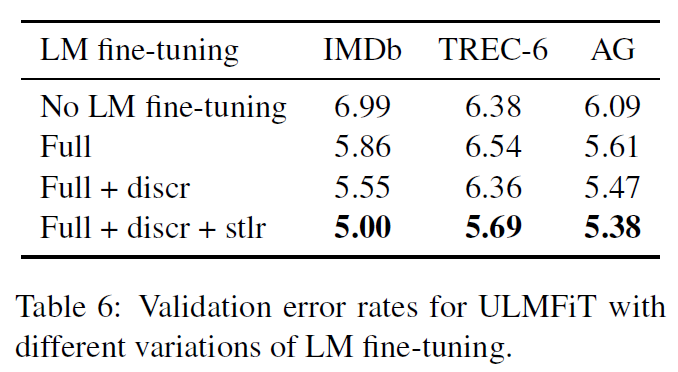
实验4:Classifier fine-tuning过程中分层微调、斜三角学习率和逐层解冻的效果。对比有chain-thaw和学习率余弦(cos)衰减。总的来说STLR表现确实好。

思考: STLR和warm-up的异同?
ULMFiT 阅读笔记的更多相关文章
- 阅读笔记 1 火球 UML大战需求分析
伴随着七天国庆的结束,紧张的学习生活也开始了,首先声明,阅读笔记随着我不断地阅读进度会慢慢更新,而不是一次性的写完,所以会重复的编辑.对于我选的这本 <火球 UML大战需求分析>,首先 ...
- [阅读笔记]Software optimization resources
http://www.agner.org/optimize/#manuals 阅读笔记Optimizing software in C++ 7. The efficiency of differe ...
- 《uml大战需求分析》阅读笔记05
<uml大战需求分析>阅读笔记05 这次我主要阅读了这本书的第九十章,通过看这章的知识了解了不少的知识开发某系统的重要前提是:这个系统有谁在用?这些人通过这个系统能做什么事? 一般搞清楚这 ...
- <<UML大战需求分析>>阅读笔记(2)
<<UML大战需求分析>>阅读笔记(2)> 此次读了uml大战需求分析的第三四章,我发现这本书讲的特别的好,由于这学期正在学习设计模式这本书,这本书就讲究对uml图的利用 ...
- uml大战需求分析阅读笔记01
<<UML大战需求分析>>阅读笔记(1) 刚读了uml大战需求分析的第一二章,读了这些内容之后,令我深有感触.以前学习uml这门课的时候,并没有好好学,那时我认为这门课并没有什 ...
- Hadoop阅读笔记(七)——代理模式
关于Hadoop已经小记了六篇,<Hadoop实战>也已经翻完7章.仔细想想,这么好的一个框架,不能只是流于应用层面,跑跑数据排序.单表链接等,想得其精髓,还需深入内部. 按照<Ha ...
- Hadoop阅读笔记(六)——洞悉Hadoop序列化机制Writable
酒,是个好东西,前提要适量.今天参加了公司的年会,主题就是吃.喝.吹,除了那些天生话唠外,大部分人需要加点酒来作催化剂,让一个平时沉默寡言的码农也能成为一个喷子!在大家推杯换盏之际,难免一些画面浮现脑 ...
- Hadoop阅读笔记(五)——重返Hadoop目录结构
常言道:男人是视觉动物.我觉得不完全对,我的理解是范围再扩大点,不管男人女人都是视觉动物.某些场合(比如面试.初次见面等),别人没有那么多的闲暇时间听你诉说过往以塑立一个关于你的完整模型.所以,第一眼 ...
- Hadoop阅读笔记(四)——一幅图看透MapReduce机制
时至今日,已然看到第十章,似乎越是焦躁什么时候能翻完这本圣经的时候也让自己变得更加浮躁,想想后面还有一半的行程没走,我觉得这样“有口无心”的学习方式是不奏效的,或者是收效甚微的.如果有幸能有大牛路过, ...
随机推荐
- 华硕200系主板完美兼容M.2安装Win7系统
虽然Windows 10系统的装机率正不断攀升,但经典的Windows 7依然有着大量的用户群体.特别是在我们中国, Windows 7依然是许许多多电脑用户的装机首选系统. 经久不衰的Windows ...
- Python之对象的永久保存模块---pickle
经常遇到在Python程序运行中得到了一些字符串.列表.字典等数据,想要长久的保存下来,方便以后使用,而不是简单的放入内存中关机断电就丢失数据. 这个时候Pickle模块就派上用场了,它可以将对象转换 ...
- Vue、Vuex+Cookie 实现自动登陆 。
概述 1.自动登陆实现思路. 2.vuex + cookie 多标签页状态保持. 自动登陆的需求: 1.登陆时勾选自动登陆,退出登陆或登陆到期后再次登陆后自动填写表单(记住密码)或访问登陆页自动登陆. ...
- spark-Scala
一.spark的特点 1.快速的 2.容易使用的 3.通用的 4.开放的 二.spark组件 sparkCore sparkSQL sparkStreaming MLibmachielearning ...
- github拓展,以及ModelForm的使用
github - git init/add/commit/reset/log/status/stash pop/checkout/branch 新入职到公司,地址: git clone h ...
- 【洛谷】【二分查找】P1102 A−B数对
[题目描述:] 给出一串数以及一个数字 C ,要求计算出所有 A−B=C 的数对的个数.(不同位置的数字一样的数对算不同的数对) [输入格式:] 第一行包括 2 个非负整数 N 和 C ,中间用空格隔 ...
- pek (北大oj)3070
思路:矩阵快速幂, 二分加速 #include<cstdio> #include<cstring> #define ll long long #define mod 10000 ...
- Oracle Drop表并未直接删除 drop table xx purge
drop表 执行drop table xx 语句 drop后的表被放在回收站(user_recyclebin)里,而不是直接删除掉.这样,回收站里的表信息就可以被恢复,或彻底清除. 通 ...
- 【opatch打补丁】oracle10.2.0.5.0升级10.2.0.5.9 for linux
https://wenku.baidu.com/view/c38702b56edb6f1afe001f59.html 这篇文章也不错,可参考 任务:oracle 10.2.0.5.0 打补丁升级 ...
- Echo团队Alpha冲刺随笔 - 第四天
项目冲刺情况 进展 前端:完成了差不多一半,小程序部分界面基本完工,WEB端也完成了一部分 后端:也完成了大半了 问题 后端文件上传还没解决 心得 进度还行,团队配合都还不错 今日会议内容 黄少勇 今 ...