
scrapy中XMLFeedSpider
爬取案例:
目标网站:
url = 'http://www.chinanews.com/rss/scroll-news.xml'
页面特点:

先创建爬虫项目:

也可以查看爬虫类:
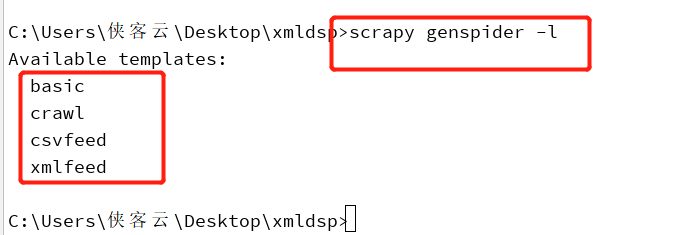
创建xmlFeed 爬虫可以用:
scrapy genspider -t xmlfeed cnew chinanews.com

2. 或可以先创建普通爬虫,再将普通的scrapy爬虫类改为XMLFeedSpider 爬虫类

该爬虫代码:
# -*- coding: utf-8 -*-

import scrapy

from scrapy.spiders import XMLFeedSpider

from ..items import FeedItem

class NewsSpider(XMLFeedSpider):

    name = 'news'

    #allowed_domains = ['www.chinanews.com']

    start_urls = ['http://www.chinanews.com/rss/scroll-news.xml']

    #iterator = 'itetnodes'

    #itertag = 'item'

    def parse_node(self, response, node):

        # item = FeedItem()

        item ={}

        item['title'] = node.xpath('title/text()').extract_first()

        item['link'] = node.xpath('link/text()').extract_first()

        item['desc'] =node.xpath('description/text()').extract_first()

        item['pub_date'] = node.xpath('pubDate/text()').extract_first()

        print(item)

        yield item
3. 将settings中的配置
# Obey robots.txt rules

ROBOTSTXT_OBEY = False
4. 启动爬虫
scrapy crawl news --nolog
5.爬取效果

scrapy中XMLFeedSpider的更多相关文章
- Scrapy中使用Django的Model访问数据库
Scrapy中使用Django的Model进行数据库访问 当已存在Django项目的时候,直接引入Django的Model来使用比较简单 # 使用以下语句添加Django项目的目录到path impo ...
- scrapy中的下载器中间件
scrapy中的下载器中间件 下载中间件 下载器中间件是介于Scrapy的request/response处理的钩子框架. 是用于全局修改Scrapy request和response的一个轻量.底层 ...
- Scrapy中使用cookie免于验证登录和模拟登录
Scrapy中使用cookie免于验证登录和模拟登录 引言 python爬虫我认为最困难的问题一个是ip代理,另外一个就是模拟登录了,更操蛋的就是模拟登录了之后还有验证码,真的是不让人省心,不过既然有 ...
- scrapy 中日志的使用
我在后台调试 在后台调试scrapy spider的时候,总是觉得后台命令窗口 打印的东西太多了不便于观察日志,因此需要一个日志文件记录信息,这样以后会 方便查找问题. 分两种方法吧. 1.简单粗暴. ...
- scrapy中response.body 与 response.text区别
scrapy中response.body 与 response.text区别 body http响应正文, byte类型 text 文本形式的http正文,str类型,它是response.body经 ...
- scrapy中的request
scrapy中的request 初始化参数 class scrapy.http.Request( url [ , callback, method='GET', headers, body, cook ...
- [转]scrapy中的logging
logging模块是Python提供的自己的程序日志记录模块. 在大型软件使用过程中,出现的错误有时候很难进行重现,因此需要通过分析日志来确认错误位置,这也是写程序时要使用日志的最重要的原因. scr ...
- 论Scrapy中的数据持久化
引入 Scrapy的数据持久化,主要包括存储到数据库.文件以及内置数据存储. 那我们今天就来讲讲如何把Scrapy中的数据存储到数据库和文件当中. 终端指令存储 保证爬虫文件的parse方法中有可迭代 ...
- selenium在scrapy中的使用、UA池、IP池的构建
selenium在scrapy中的使用流程 重写爬虫文件的构造方法__init__,在该方法中使用selenium实例化一个浏览器对象(因为浏览器对象只需要被实例化一次). 重写爬虫文件的closed ...
随机推荐
- mysql-proxy 简介
# 背景 今天同事分享的主题就是mysql-proxy,于是下来自己了解下,不求精通,只求知道这个玩意 # 简介 mysql-proxy是mysql官方提供的mysql中间件服务,上游可接入若干个my ...
- layer知识点总结
1,本弹窗直接跳转父页面: <script> window.parent.location.reload(); //刷新父页面 var index = pare ...
- bugfree3.0.1-修改“优先级”“严重等级”为中文
1.进入目录C:\xampp\htdocs\bugfree\protected\models 2.打开文件 Info.php
- varnish缓存系统基础知识
缓存系统类型 1.页面缓存/pageCache 缓存静态资源(html js css image) 例如:varnish squid 2.数据缓存/dataCache 缓存应 ...
- #学号 20175201张驰 《Java程序设计》第1周学习总结
教材学习内容总结 第一章 ·第一章的内容相对简单,我并未遇到大的困难. ·1.Java特点:语法简单.面向对象.与平台无关.动态. ·2.关于编写源文件:源文件名字必须与public类的名字相同:保存 ...
- 附8 zipkin
一.zipkin作用 全链路追踪工具(查看依赖关系) 查看每个接口.每个service的执行速度(定位问题发生点或者寻找性能瓶颈) 二.zipkin工作原理 创造一些追踪标识符(tracingId,s ...
- ubuntu14安装mantis实践(包含LAMP/PHP)
安装LAMP 参考 https://www.linuxidc.com/Linux/2016-12/138757.htm sudo add-apt-repository ppa:ondrej/apach ...
- Vue使用Typescript开发编译时提示“ERROR in ./src/main.ts Module build failed: TypeError: Cannot read property 'afterCompile' of undefined”的解决方法
使用Typescript开发Vue,一切准备就绪.但npm start 时,提示“ ERROR in ./src/main.tsModule build failed: TypeError: Cann ...
- 论文阅读(XiangBai——【AAAI2017】TextBoxes_A Fast Text Detector with a Single Deep Neural Network)
XiangBai——[AAAI2017]TextBoxes:A Fast Text Detector with a Single Deep Neural Network 目录 作者和相关链接 方法概括 ...
- thymeleaf 添加语法提示
thymeleaf 添加语法提示: xmlns:th="http://www.thymeleaf.org"