
CUDA线程
建议先看看前言中关于存储器的介绍:点击打开链接
线程
首先介绍进程,进程是程序的一次执行,线程是进程内的一个相对独立的可执行的单元。若把进程称为任务的话,那么线程则是应用中的一个子任务的执行。举个简单的例子:一个人要做饭,食谱就是程序代码,做的过程就是执行程序,做好的饭就是程序运行的结果,而在这期间,需要炒菜,放盐,放油等等就是线程。
线程同步
调用__syncthreads 创建一个 barrier 栅栏
每个线程在调用点等待块内所有线程执行到这个地方,然后所有线程继续执行后续命令
Mds[i] = Md[j];

__syncthreads();

func(Mds[i],Mds[i+]);
要求线程的执行时间尽量接近,因为执行时间差别过大,等待时间过长,效率低下。
只在块内同步,全局同步开销大
线程同步会导致死锁,例如:
if(someFunc())

{

    __syncthreads();

}

else

{

    __syncthreads();

}
线程调度
Warp——块内的一组线程,一般是32个线程为一组
线程调度的基本单位
运行于同一个 SM(流多处理器)
内部threadIdx值连续
warp内部线程不能沿不同分支执行
线程层次
Grid——一维或多维线程块(block)
一维或二维
Block——一组线程
一维,二维或三维
一个 Grid 里的每个 Block 的线程数是一样的
block内部的内个线程可以同步(synchronize)和访问共享存储器(shared memory)
线程组织模型
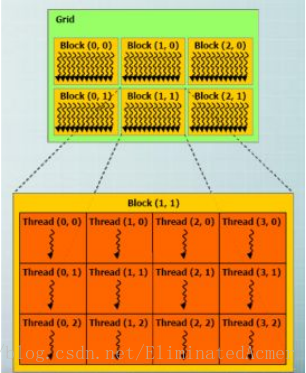
block下由线程束(warp) 组成,block 内部的线程共享“shared memory”
可以同步 “__syncthreads()”
一个Kernel具有大量线程,Kernel启动一个 “grid”,包含若干线程块,用户设定
下图是一个 grid 模型:
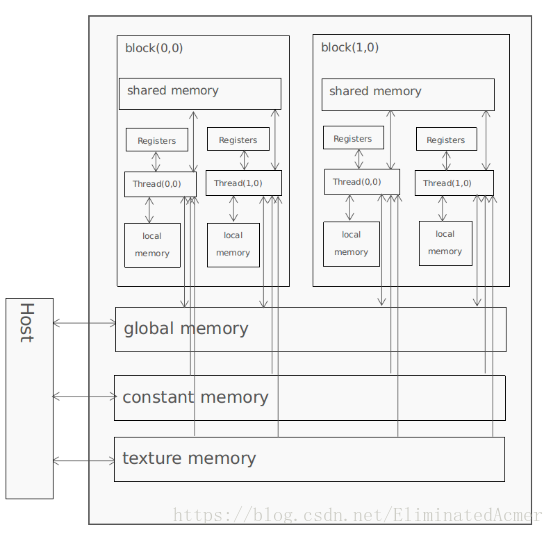
从图中可以看出这个 grid 中用户指定了 2 个线程块,每个线程块中有 2 个线程
可以看到CUDA内存传输是这样:
Device端
针对每个线程,可以读写 local memory 和 register
针对每个线程块,可以读写 shared memory
针对每个 grid,可以读写 global memory,只读 constant memory 和 texture memory
Host端
可以读写 global memory,constant memory 和 texture memory
回顾线程层次
首先看一个计算 N × N 矩阵的例子:
假设N = 32
先指定 Grid 里面有 2 × 2 个线程块 Block,表示为
blockIdx ([0,1],[0,1])
每个块有 16 × 16 个线程 (跟 N 无关),表示为
threadIdx ([0,15],[0,15])
块大小这样表示
blockDim = 16
则某个线程的真实索引为
i = [0,1] * 16 + [0,15]
线程索引: threadIdx
一维Block Thread ID == Thread Index
二维 Block (Dx,Dy)
Thread ID of index(x,y) == x + yDy
三维 Block (Dx,Dy,Dz)
Thread ID of index(x,y,z) == x + yDx + zDxDy
计算 N × N 矩阵,指定线程块为 1 块,大小为矩阵大小
__global__ void MatAdd(float A[N][N],float B[N][N],float C[N][N])

{

     int i = threadIdx.x;

     int j = threadIdx.y;

     C[i][j] = A[i][j] + B[i][j];

}

int main()

{

     int numBlocks = ;                      //指定线程块为 1

     dim3 threadsPerBlock(N,N);               //指定大小为 N × N

     MatAdd<<<numBlocks,threadsPerBlock>>>(A,B,C);

}
Thread Block 线程块
线程的集合
位于相同的处理器核(SM)
共享所在核的存储器
块索引:blockIdx
维度:blockDim
一维,二维,三维
计算 N × N 矩阵,指定线程块大小为 16 × 16,若干个线程块
__global__ void MatAdd(float A[N][N],float B[N][N],float C[N][N])

{

     int i = blockIdx.x * blockDim.x + threadIdx.x;

     int j = blockIdx.y * blockDim.y + threadIdx.y;

     if(i < N && j < N)

         C[i][j] = A[i][j] + B[i][j];

}

int main()

{

     dim3 threadsPerBlock(,);

     dim3 numBlocks(N / threadsPerBlock.x , N / threadsPerBlock.y);

     MatAdd<<<numBlocks,threadsPerBlock>>>(A,B,C);

}
线程块之间彼此独立执行
任意顺序:并行或串行
被任意数量的处理器以任意顺序调度:处理器的数量具有可扩展性
一个块内部的线程
共享容量有限的低延迟存储器
同步执行:合并访存,__syncThreads():Barrier ——块内线程一起等待所有线程都执行某处语句,轻量级
实例演示
先介绍几个函数:
cudaMalloc()
在设备端分配 global memory
cudaFree()
释放存储空间
cudaMemcpy()
内存传输
Host to host
Host to device
Device to host
Device to device
cudaMemcpy(Md,M,size,cudaMemcpyHostToDevice);
Md 目的地址
M 原地址
size 大小
CPU端代码:
void MatrixMulOnHost(float** M,float** N,float** P,int width)

{

    for(int i =  ; i < width ; ++i)

        for(int j =  ; j < width ; ++j)

        {

            float sum = ;

            for(int k =  ; k < width ; ++k)

            {

                float a = M[i][k];

                float b = N[k][j];

                sum += a * b;

            }

            P[i][j] = sum;

        }

}
CUDA 算法框架
int main()
{
1.管理内存,为输入的原始数据,以及输出结果在GPU上分配内存
2.并行处理
3.结果拷贝回 CPU,释放内存
return 0;
}
1.
int size = Width * Width * sizeof(float);

     cudaMalloc(Md,size);

     cudaMemcpy(Md,M,size,cudaMemcpyHostToDevice);

     cudaMalloc(Nd,N,size,cudaMemcpyHostToDevice);

     cudaMalloc(Pd,size);
2.
__global__ void MatrixMulKernel(float* Md,float* Nd,float* Pd,int width)

{

   int tx = threadIdx.x;

   int ty = threadIdx.y;

   float Pvalue = ;

   for(int k =  ; k < width ; ++k) {

       float Mdelement = Md[ty * Md.width + k];

       float Ndelement = Nd[k * Nd.width + tx];

       Pvalue += Mdelement * Ndelement;

   }

   Pd[ty * width + tx] = Pvalue;

 }
3.
     cudaMemcpy(P,Pd,size,cudaMemcpyDeviceToHost);

     cudaFree(Md);

     cudaFree(Nd);

     cudaFree(Pd);
在main()中调用 Kernel
dim3 dimBlock(WIDTH,WIDTH);

dim3 dimGrid(1,1);

MatrixMulKernel <<<dimGrid,dimBlock>>>(Md,Nd,Pd);
完整GPU程序如下:
/*

 ============================================================================

 Name        : Martix.cu

 Author      : wzn

 Version     :

 Copyright   : Your copyright notice

 Description : CUDA compute reciprocals

 ============================================================================

 */

#include <iostream>

#include <numeric>

#include <stdlib.h>

__global__ void MatrixMulKernel(float* Md,float* Nd,float* Pd,int Width)

{

   int tx = threadIdx.x;

   int ty = threadIdx.y;

   float Pvalue = ;

   for(int k =  ; k < Width ; ++k) {

       float Mdelement = Md[ty * Width + k];

       float Ndelement = Nd[k * Width + tx];

       Pvalue += Mdelement * Ndelement;

   }

   Pd[ty * Width + tx] = Pvalue;

 }

int main(void)

{

         int Width = ;

         int size = Width * Width * sizeof(float);

         float M[Width][Width],N[Width][Width],P[Width][Width];

         for(int i = ;i<;i++){

             for(int j = ;j<;j++){

                 M[i][j] = j;

                 N[i][j] = j;

             }

         }

         float *Md,*Nd,*Pd;

         cudaMalloc((void **)&Md,size);

         cudaMalloc((void **)&Nd,size);

         cudaMemcpy(Md,M,size,cudaMemcpyHostToDevice);

         cudaMemcpy(Nd,N,size,cudaMemcpyHostToDevice);

         cudaMalloc((void **)&Pd,size);

         dim3 dimBlock(Width,Width);

         dim3 dimGrid(,);

         MatrixMulKernel <<<dimGrid,dimBlock>>>(Md,Nd,Pd,Width);

         cudaMemcpy(P,Pd,size,cudaMemcpyDeviceToHost);

              cudaFree(Md);

              cudaFree(Nd);

              cudaFree(Pd);

         for(int i = ;i<;i++){

              for(int j = ;j<;j++){

                    std::cout<<P[i][j]<<" ";

              }

              std::cout<<"\n";

          }

    return ;

}

CPU端程序:

#include <iostream>

using namespace std;

void MatrixMulOnHost(float** M,float** N,float** P,int width)

{

    for(int i =  ; i < width ; ++i)

        for(int j =  ; j < width ; ++j)

        {

            float sum = ;

            for(int k =  ; k < width ; ++k)

            {

                float a = M[i][k];

                float b = N[k][j];

                sum += a * b;

            }

            P[i][j] = sum;

        }

}

int main()

{

    int Width = ;

    float **M,**N,**P;

    M = new float* [Width];

    for(int i =  ;i<Width;i++)

    M[i] = new float [Width];

    N = new float* [Width];

    for(int i =  ;i<Width;i++)

    N[i] = new float [Width];

    P = new float* [Width];

    for(int i =  ;i<Width;i++)

    P[i] = new float [Width];

    for(int i = ; i<; i++)

    {

        for(int j = ; j<; j++)

        {

            M[i][j] = j;

            N[i][j] = j;

        }

    }

    MatrixMulOnHost(M,N,P,Width);

    for(int i = ; i<; i++)

    {

        for(int j = ; j<; j++)

        {

            cout<<P[i][j]<<" ";

        }

        cout<<endl;

    }

    return ;

}
运行结果比较
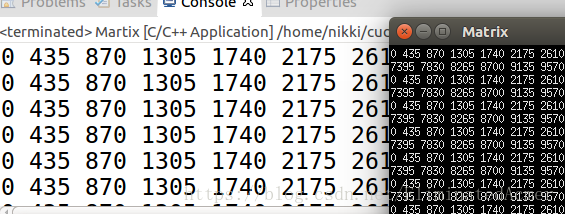
CUDA线程的更多相关文章
- CUDA学习笔记(二)——CUDA线程模型
转自:http://blog.sina.com.cn/s/blog_48b9e1f90100fm5b.html 一个grid中的所有线程执行相同的内核函数,通过坐标进行区分.这些线程有两级的坐标,bl ...
- GPU(CUDA)学习日记(十一)------ 深入理解CUDA线程层次以及关于设置线程数的思考
GPU线程以网格(grid)的方式组织,而每个网格中又包含若干个线程块,在G80/GT200系列中,每一个线程块最多可包含512个线程,Fermi架构中每个线程块支持高达1536个线程.同一线程块中的 ...
- 最优的cuda线程配置
1 每个SM上面失少要有192个激活线程,寄存器写后读的数据依赖才能被掩盖 2 将 寄存器 的bank冲突降到最低,应尽量使每个block含有的线程数是64的倍数 3 block的数量应设置得 ...
- CUDA线程协作之共享存储器“__shared__”&&“__syncthreads()”
在GPU并行编程中,一般情况下,各个处理器都需要了解其他处理器的执行状态,在各个并行副本之间进行通信和协作,这涉及到不同线程间的通信机制和并行执行线程的同步机制. 共享内存"__share_ ...
- 【并行计算-CUDA开发】CUDA线程、线程块、线程束、流多处理器、流处理器、网格概念的深入理解
GPU的硬件结构,也不是具体的硬件结构,就是与CUDA相关的几个概念:thread,block,grid,warp,sp,sm. sp: 最基本的处理单元,streaming processor 最 ...
- CUDA线程、线程块、线程束、流多处理器、流处理器、网格概念的深入理解
一.与CUDA相关的几个概念:thread,block,grid,warp,sp,sm. sp: 最基本的处理单元,streaming processor 最后具体的指令和任务都是在sp上处理的.G ...
- cuda线程/线程块索引小结
内建变量: threadIdx(.x/.y/.z代表几维索引):线程所在block中各个维度上的线程号 blockIdx(.x/.y/.z代表几维索引):块所在grid中各个维度上的块号 blockD ...
- CUDA ---- 线程配置
前言 线程的组织形式对程序的性能影响是至关重要的,本篇博文主要以下面一种情况来介绍线程组织形式: 2D grid 2D block 线程索引 矩阵在memory中是row-major线性存储的: 在k ...
- CUDA并行计算 | 线程模型与内存模型
文章目录 前言 CUDA线程模型(如何组织线程) CUDA内存模型(了解不同内存优缺点,合理使用) 前言 CUDA(Compute Unified Device Architecture)是显卡厂 ...
随机推荐
- MySQL 5.7使用xtabackup报错解决
报错信息: InnoDB: An optimized (without redo logging) DDLoperation has been performed. All modified page ...
- Java内存模型学习笔记(一)—— 基础
1.并发编程模型的分类 在并发编程中,我们需要处理两个关键的问题:1.线程间如何通信,2.线程间如何同步.通信是指线程之间以何种机制来交换信息,同步是指程序用于不同线程之间操作发生相对顺序的机制. 在 ...
- Vuex 刷新后数据丢失问题 Typescript
问题描述:Vuex保存的数据在页面刷新后会全部丢失清除 问题解决方案:使用sessionstorage进行保存,在页面刷新时保存至sessionStorage,页面在加载时再进行填充 (另有vue ...
- python入门-windows下python环境搭建
1. 下载安装包 选择executable版,根据自己电脑的操作系统选择是32位还是64为. python3.6-64位下载 python3.6-32位下载 2. 安装python 下载之后是这样的 ...
- springboot笔记03——quickstart程序原理
一.前言 一个quickstart程序仅仅让我们初步了解一个框架,我们还需要透过现象看本质才能学好一个框架.所以这篇文章分析一下我上次写的springboot的入门程序. 二.原理分析 1.依赖分析 ...
- css 盒子 取值
盒子:当我们设置一个标签宽高时,默认设置的是盒子里面content大小. 内容盒:content 填充盒:content+padding(overflow截取的区域) 边框盒:content+padd ...
- SMARTY的知识
smarty的原理: <?php class Smarty { $ldelimiter = "{";//左分隔符 $rdelimiter = "}";// ...
- 极度舒适的 Python 入门教程,小猪佩奇也能学会~
编程几乎已经成为现代人的一门必修课,特别是 Python ,不仅长期霸占编程趋势榜.薪资榜第一,还屡屡进入小学教材,甚至成为浙江省信息技术高考项目-- 今天,小编带来了一门极度舒适的 Python 入 ...
- CentOS 7的Linux系统优化加固
1.关闭selinux 2.关闭防火墙 3.关闭NetworkManager 4.为系统运维管理员创建普通用户,并配置sudo(vi sudo) 5.清空泄漏系统版本信息的文件 6.基础优化sshd ...
- Docker本地镜像上传到阿里云仓库
登录阿里云 在容器镜像服务中先创建命名空间 随后创建镜像仓库 我使用的代码源是本地仓库 创建后点击仓库的管理 就可以看到阿里云提供的操作指南 (下面的操作每个人都不同,详情查看阿里云的操作指南) 输入 ...