
100天搞定机器学习|Day4-6 逻辑回归
逻辑回归avik-jain介绍的不是特别详细,下面再唠叨一遍这个算法。
1.模型
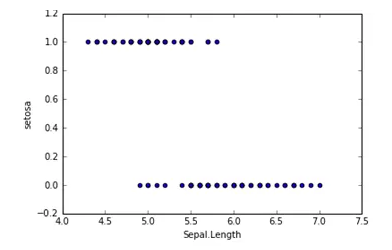
在分类问题中,比如判断邮件是否为垃圾邮件,判断肿瘤是否为阳性,目标变量是离散的,只有两种取值,通常会编码为0和1。假设我们有一个特征X,画出散点图,结果如下所示。这时候如果我们用线性回归去拟合一条直线:hθ(X) = θ0+θ1X,若Y≥0.5则判断为1,否则为0。这样我们也可以构建出一个模型去进行分类,但是会存在很多的缺点,比如稳健性差、准确率低。而逻辑回归对于这样的问题会更加合适。
逻辑回归假设函数如下,它对θTX作了一个函数g变换,映射至0到1的范围之内,而函数g称为sigmoid function或者logistic function,函数图像如下图所示。当我们输入特征,得到的hθ(x)其实是这个样本属于1这个分类的概率值。也就是说,逻辑回归是用来得到样本属于某个分类的概率。
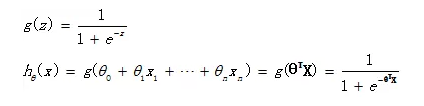

2.评价
回想起之前线性回归中所用到的损失函数:
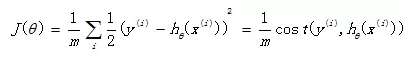
如果在逻辑回归中也运用这种损失函数,得到的函数J是一个非凸函数,存在多个局部最小值,很难进行求解,因此需要换一个cost函数。重新定义个cost函数如下:
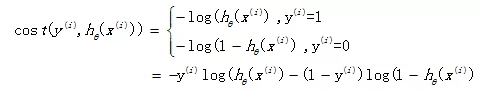
当实际样本属于1类别时,如果预测概率也为1,那么损失为0,预测正确。相反,如果预测为0,那么损失将是无穷大。这样构造的损失函数是合理的,并且它还是一个凸函数,十分方便求得参数θ,使得损失函数J达到最小。
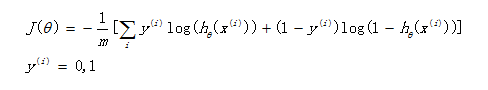
3.优化
我们已经定义好了损失函数J(θ),接下来的任务就是求出参数θ。我们的目标很明确,就是找到一组θ,使得我们的损失函数J(θ)最小。最常用的求解方法有两种:批量梯度下降法(batch gradient descent), 牛顿迭代方法((Newton's method)。两种方法都是通过迭代求得的数值解,但是牛顿迭代方法的收敛速度更加快。
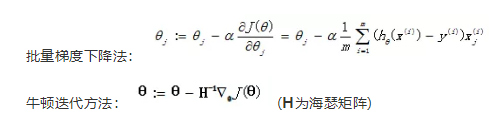
“
实验-分割线
”
第0步:数据预览
数据集链接:https://pan.baidu.com/s/1TkUe-7-Q_jX5IT2qrXzeuA
提取码:hrrm
该数据集包含了社交网络中用户的信息。这些信息涉及用户ID,性别,年龄以及预估薪资。一家汽车公司刚刚推出了他们新型的豪华SUV,我们尝试预测哪些用户会购买这种全新SUV。并且在最后一列用来表示用户是否购买。我们将建立一种模型来预测用户是否购买这种SUV,该模型基于两个变量,分别是年龄和预计薪资。因此我们的特征矩阵将是这两列。我们尝试寻找用户年龄与预估薪资之间的某种相关性,以及他是否购买SUV的决定。

步骤1 | 数据预处理
导入库
import numpy as npimport matplotlib.pyplot as pltimport pandas as pd
导入数据集
dataset = pd.read_csv('Social_Network_Ads.csv')

X = dataset.iloc[:, [2, 3]].values

Y = dataset.iloc[:,4].values
将数据集分成训练集和测试集
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, Y, test_size = 0.25, random_state = 0)
特征缩放
from sklearn.preprocessing import StandardScaler

sc = StandardScaler()

X_train = sc.fit_transform(X_train)

X_test = sc.transform(X_test)
步骤2 | 逻辑回归模型
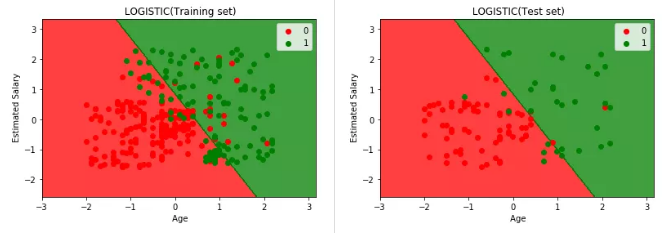
该项工作的库将会是一个线性模型库,之所以被称为线性是因为逻辑回归是一个线性分类器,这意味着我们在二维空间中,我们两类用户(购买和不购买)将被一条直线分割。然后导入逻辑回归类。下一步我们将创建该类的对象,它将作为我们训练集的分类器。
将逻辑回归应用于训练集
from sklearn.linear_model import LogisticRegression

classifier = LogisticRegression()

classifier.fit(X_train, y_train)
步骤3 | 预测
预测测试集结果
y_pred = classifier.predict(X_test)
步骤4 | 评估预测
我们预测了测试集。 现在我们将评估逻辑回归模型是否正确的学习和理解。因此这个混淆矩阵将包含我们模型的正确和错误的预测。
生成混淆矩阵
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred)
可视化
from matplotlib.colors import ListedColormap

X_set,y_set=X_train,y_train

X1,X2=np. meshgrid(np. arange(start=X_set[:,0].min()-1, stop=X_set[:, 0].max()+1, step=0.01),

                   np. arange(start=X_set[:,1].min()-1, stop=X_set[:,1].max()+1, step=0.01))

plt.contourf(X1, X2, classifier.predict(np.array([X1.ravel(),X2.ravel()]).T).reshape(X1.shape),             alpha = 0.75, cmap = ListedColormap(('red', 'green')))

plt.xlim(X1.min(),X1.max())

plt.ylim(X2.min(),X2.max())for i,j in enumerate(np. unique(y_set)):

    plt.scatter(X_set[y_set==j,0],X_set[y_set==j,1],                c = ListedColormap(('red', 'green'))(i), label=j)

plt. title(' LOGISTIC(Training set)')

plt. xlabel(' Age')

plt. ylabel(' Estimated Salary')

plt. legend()

plt. show()

X_set,y_set=X_test,y_test

X1,X2=np. meshgrid(np. arange(start=X_set[:,0].min()-1, stop=X_set[:, 0].max()+1, step=0.01),

                   np. arange(start=X_set[:,1].min()-1, stop=X_set[:,1].max()+1, step=0.01))

plt.contourf(X1, X2, classifier.predict(np.array([X1.ravel(),X2.ravel()]).T).reshape(X1.shape),             alpha = 0.75, cmap = ListedColormap(('red', 'green')))

plt.xlim(X1.min(),X1.max())

plt.ylim(X2.min(),X2.max())for i,j in enumerate(np. unique(y_set)):

    plt.scatter(X_set[y_set==j,0],X_set[y_set==j,1],                c = ListedColormap(('red', 'green'))(i), label=j)

plt. title(' LOGISTIC(Test set)')

plt. xlabel(' Age')

plt. ylabel(' Estimated Salary')

plt. legend()

plt. show()

100天搞定机器学习|Day4-6 逻辑回归的更多相关文章
- 100天搞定机器学习|Day8 逻辑回归的数学原理
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
- 100天搞定机器学习|Day17-18 神奇的逻辑回归
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day11 实现KNN
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
- 100天搞定机器学习|Day9-12 支持向量机
机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习|D ...
- 100天搞定机器学习|Day16 通过内核技巧实现SVM
前情回顾 机器学习100天|Day1数据预处理100天搞定机器学习|Day2简单线性回归分析100天搞定机器学习|Day3多元线性回归100天搞定机器学习|Day4-6 逻辑回归100天搞定机器学习| ...
- 100天搞定机器学习|Day19-20 加州理工学院公开课:机器学习与数据挖掘
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day21 Beautiful Soup
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day22 机器为什么能学习?
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day33-34 随机森林
前情回顾 机器学习100天|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机 ...
- 100天搞定机器学习|Day35 深度学习之神经网络的结构
100天搞定机器学习|Day1数据预处理 100天搞定机器学习|Day2简单线性回归分析 100天搞定机器学习|Day3多元线性回归 100天搞定机器学习|Day4-6 逻辑回归 100天搞定机器学习 ...
随机推荐
- ajax默认是异步的
jquery中的ajax 默认情况下为异步请求,即 async:true,可以通过设置参数 asycn:false 到使其同步 $.ajax({ url: 'www.test.com/test/tes ...
- linux下如何删除乱码文件
首先执行ls -i命令,此时在文件前面会出现一个数字,这个数字是文件的节点号 接着,执行命令 find -inum 节点号 -delete 即可将乱码文件成功删除
- linux下如何让控制台程序后台运行
方法1:./test & 方法2:(./test &) 方法3:nohup 和bg 方法4:screen -mS test /root/test 退出程序需要手动进入screen创 ...
- 【Java】线程需要独立的Connection,那对已经配好session的Spring/Mabatis工程该怎么办?
方法一:让线程从配置中取DataSource. 方法二:从配置中取出SessionFactory,然后交给线程去创建session和Connection,举例如下: // Get Session Fa ...
- 迷你版AOP框架
http://www.cnblogs.com/artech/archive/2008/11/27/1342309.html
- 阶段5 3.微服务项目【学成在线】_day18 用户授权_19-微服务之间认证-Feign 拦截器
4.2 Feign 拦截器 4.2.1 定义Feign拦截器 微服务之间使用feign进行远程调用,采用feign拦截器实现远程调用携带JWT. 在common工程添加依赖: <dependen ...
- yml内容如何转map?
yml内容如何转map 解决方法: Map map = null; Yaml yaml = new Yaml(); File ymlFile = new File("c:/src/tes ...
- SortedMap和TreeMap有什么区别?
SortedMap和TreeMap有什么区别 答: TreeMap的类的源码: public class TreeMap<K,V> extends AbstractMap<K,V ...
- C/C++程序所占用内存区域
C/C++编译的程序所占用内存区域一般分为以下5个部分: 栈区(stack):由编译器自动分配和释放,用来存放函数的参数.局部变量等.其操作方式类似于数据结构中的栈. 堆区(heap):一般由程序员分 ...
- request cluster ID mismatch
删除了etcd集群所有节点中的--data_dir的内容 [root@node3 ~]# cd /var/lib/etcd/ [root@node3 etcd]# ls member [root@no ...