
如何利用python爬虫爬取爱奇艺VIP电影?
环境:windows python3.7
思路:
1、先选取你要爬取的电影
2、用vip解析工具解析,获取地址
3、写好脚本,下载片断
4、将片断利用电脑合成
需要的python模块:
##第一个模块不要安装,第二个模块需要安装
1、from multiprocessing import Pool
2、import requests
##模块安装方法
用windows命令行终端
pip install requests
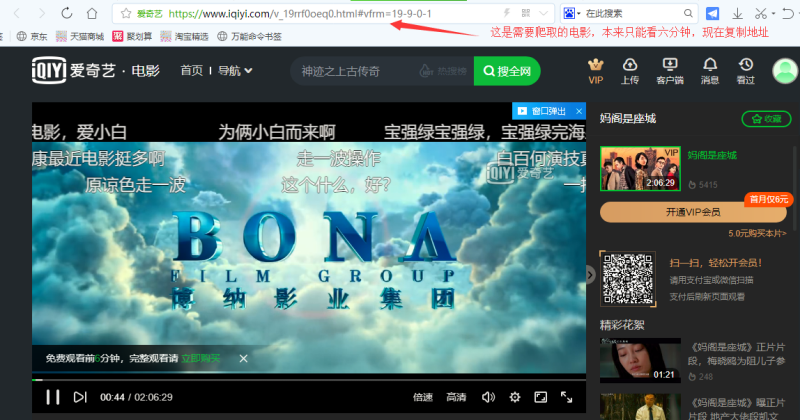
一、先选取你要爬的电影,本例随便找了个VIP电影,复制地址
二、用vip解析工具解析,获取地址
(一)进行上网搜索,点击VIP解析
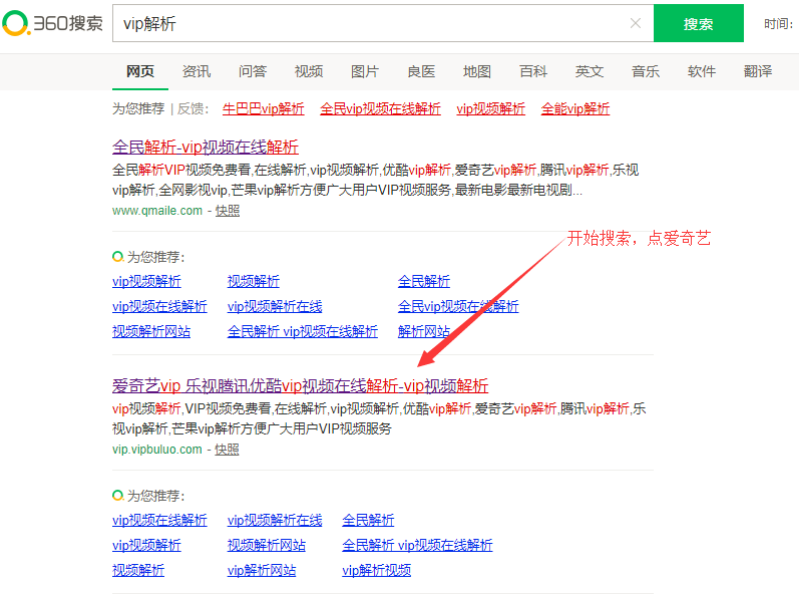
(二)、粘贴电影地址,点击播放

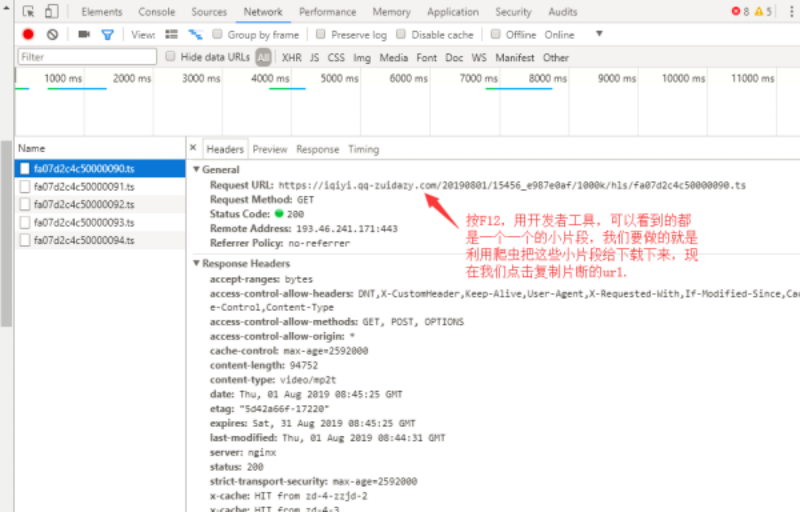
(三)、按下F12或者右击点检查,进入开发者工具界面,点击网络,复制地址
三、写好脚本,利用爬虫下载片断
##描述:该脚本目前适合下载爱奇艺,腾迅视频VIP视频

##作者:小刘

##电话:有事请写评论

##注意:只适全python爬虫的学习者,不适合专门去看电影的爱好者

##导入的两个模块,其中requests模块需要自行下载

from multiprocessing import Pool

import requests

##定义一个涵数

def demo(i):

    ##定义了一个url,后面%3d就是截取后面三位给他加0,以防止i的参数是1的时候参数对不上号,所以是1的时候就变成了001

    url="https://vip.okokbo.com/20180114/ArVcZXQd/1000kb/hls/phJ51837151%03d.ts"%i

    ##定义了请求头信息

    headers={"user-agent":"Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/49.0.2623.221 Safari/537.36"}

    ##构建自定义请求对象

    req=requests.get(url,headers=headers)

    ##将文件保存在当前目录的mp4文件中,名字以url后十位数起名

    with open('./mp4/ {}'.format(url[-10:]), 'wb') as f:

        f.write(req.content)

##程序代码的入口

if __name__=='__main__':

    ##定义一个进程池,可以同时执行二十个任务,不然一个一个下载太慢

    pool = Pool(20)

    ##执行任务的代码

    for i in range(100):

        pool.apply_async(demo, (i,))

    pool.close()

    pool.join()
四、将片断利用电脑合成
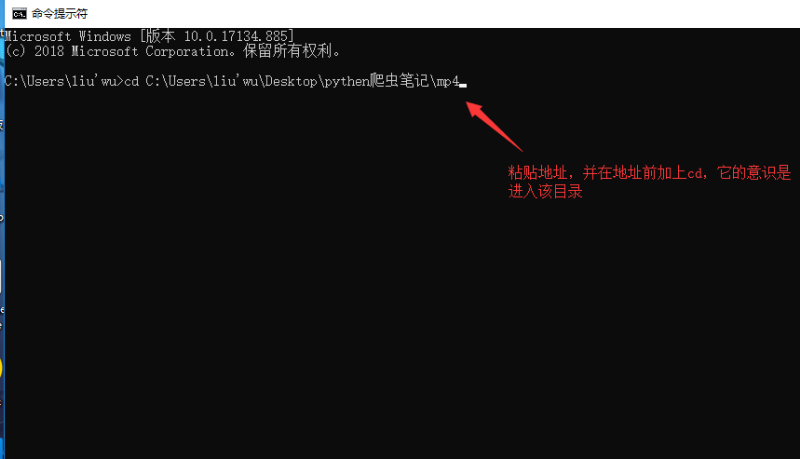
(一)、复制电影存放的路径

(二)、用进入windows命令行模式,粘贴地址
(三)、复制该目录下所有以*.ts结尾的文件,复制成一个文件

(四)、进行合并
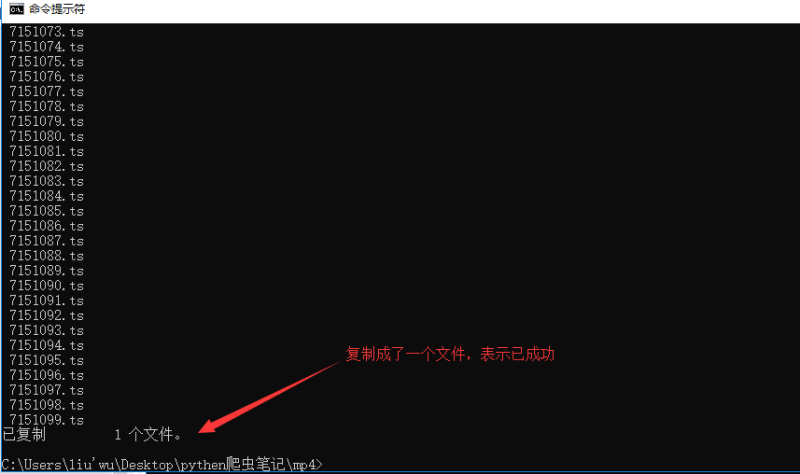
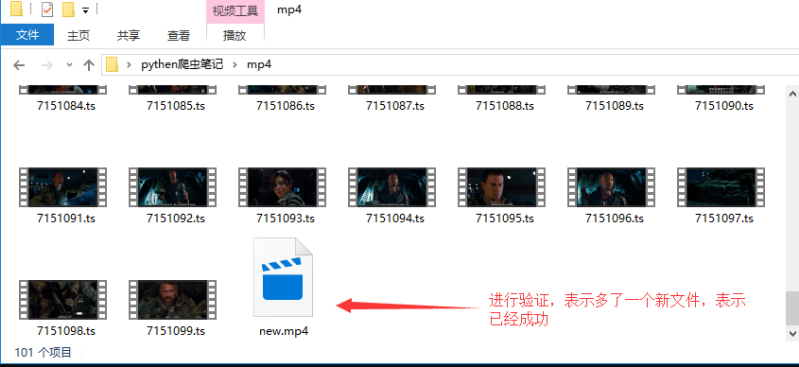
(五)、进行验证
(
五、有疑问请留言
如何利用python爬虫爬取爱奇艺VIP电影?的更多相关文章
- Python爬虫实战案例:爬取爱奇艺VIP视频
一.实战背景 爱奇艺的VIP视频只有会员能看,普通用户只能看前6分钟.比如加勒比海盗5的URL:http://www.iqiyi.com/v_19rr7qhfg0.html#vfrm=19-9-0-1 ...
- 使用selenium 多线程爬取爱奇艺电影信息
使用selenium 多线程爬取爱奇艺电影信息 转载请注明出处. 爬取目标:每个电影的评分.名称.时长.主演.和类型 爬取思路: 源文件:(有注释) from selenium import webd ...
- Python 爬虫实例(5)—— 爬取爱奇艺视频电视剧的链接(2017-06-30 10:37)
1. 我们找到 爱奇艺电视剧的链接地址 http://list.iqiyi.com/www/2/-------------11-1-1-iqiyi--.html 我们点击翻页发现爱奇艺的链接是这样的 ...
- Python爬取爱奇艺资源
像iqiyi这种视频网站,现在下载视频都需要下载相应的客户端.那么如何不用下载客户端,直接下载非vip视频? 选择你想要爬取的内容 该安装的程序以及运行环境都配置好 下面这段代码就是我在爱奇艺里搜素“ ...
- Python爬虫爬取BT之家找电影资源
一.写在前面 最近看新闻说圣城家园(SCG)倒了,之前BT天堂倒了,暴风影音也不行了,可以说看个电影越来越费力,国内大厂如企鹅和爱奇艺最近也出现一些幺蛾子,虽然目前版权意识虽然越来越强,但是很多资源在 ...
- 利用Python爬虫爬取淘宝商品做数据挖掘分析实战篇,超详细教程
项目内容 本案例选择>> 商品类目:沙发: 数量:共100页 4400个商品: 筛选条件:天猫.销量从高到低.价格500元以上. 项目目的 1. 对商品标题进行文本分析 词云可视化 2. ...
- 利用Python爬虫爬取指定天猫店铺全店商品信息
本编博客是关于爬取天猫店铺中指定店铺的所有商品基础信息的爬虫,爬虫运行只需要输入相应店铺的域名名称即可,信息将以csv表格的形式保存,可以单店爬取也可以增加一个循环进行同时爬取. 源码展示 首先还是完 ...
- Python爬取爱奇艺【老子传奇】评论数据
# -*- coding: utf-8 -*- import requests import os import csv import time import random base_url = 'h ...
- 爬取爱奇艺电视剧url
----因为需要顺序,所有就用串行了---- import requests from requests.exceptions import RequestException import re im ...
随机推荐
- Spring Boot中的事务管理 隔离级别
在声明事务时,只需要通过value属性指定配置的事务管理器名即可,例如:@Transactional(value="transactionManagerPrimary"). 除了指 ...
- Java终止线程的三种方式
停止一个线程通常意味着在线程处理任务完成之前停掉正在做的操作,也就是放弃当前的操作. 在 Java 中有以下 3 种方法可以终止正在运行的线程: 使用退出标志,使线程正常退出,也就是当 run() 方 ...
- 邻居子系统 之 状态定时器回调neigh_timer_handler
概述 在分配邻居子系统之后,会设置定时器来处理那些需要定时器处理的状态,定时器回调函数为neigh_timer_handler:函数会根据状态机变换规则对状态进行切换,切换状态后,如果需要更新输出函数 ...
- Python list 遇到的问题
1.list“+” 运算 <list += > diff. <ndarray +=> list1 += list2是追加,而不是加法运算 list1 = [0,0,0] lis ...
- python 字符串(str)和列表(list)的互相转换
1.str to list str1 = "12345"list1 = list(str1)print list1 str2 = "123 sjhid dhi" ...
- svg简单的应用
1.可以直接在html内写svg (1)width宽度,height高度 (2)xmlns svg的规则 <svg xmlns="http://www.w3.org/2000/svg& ...
- 提高组刷题营 DAY 1 下午
DFS 深度优先搜索 通过搜索得到一棵树形图 策略:只要能发现没走过的点,就走到它.有多个点可走就随便挑一个,如果无路可走就回退,再看有没有没走过的点可走. 在图上寻找路径[少数可用最短路解决]:最短 ...
- 安装nodejs 后运行 npm 命令无响应
安装和卸载过nodejs, 也编辑过 C:\Users\{账户}\下的.npmrc文件. 再全新安装nodejs ,运行npm 命令,无响应. 处理方法,删除C:\Users\{账户}\下的.npmr ...
- Java之分布式事务TCC
看这个博客吧! 挺好的. 理论:https://www.cnblogs.com/jajian/p/10014145.html 实践:https://www.cnblogs.com/sessionbes ...
- linux备忘和卸载
linux上网 -------------------------------------------------linux卸载------------------------------------ ...