
# [爬虫Demo] pyquery+csv爬取猫眼电影top100
[爬虫Demo] pyquery+csv爬取猫眼电影top100
站点分析
https://maoyan.com/board/4?offset=0
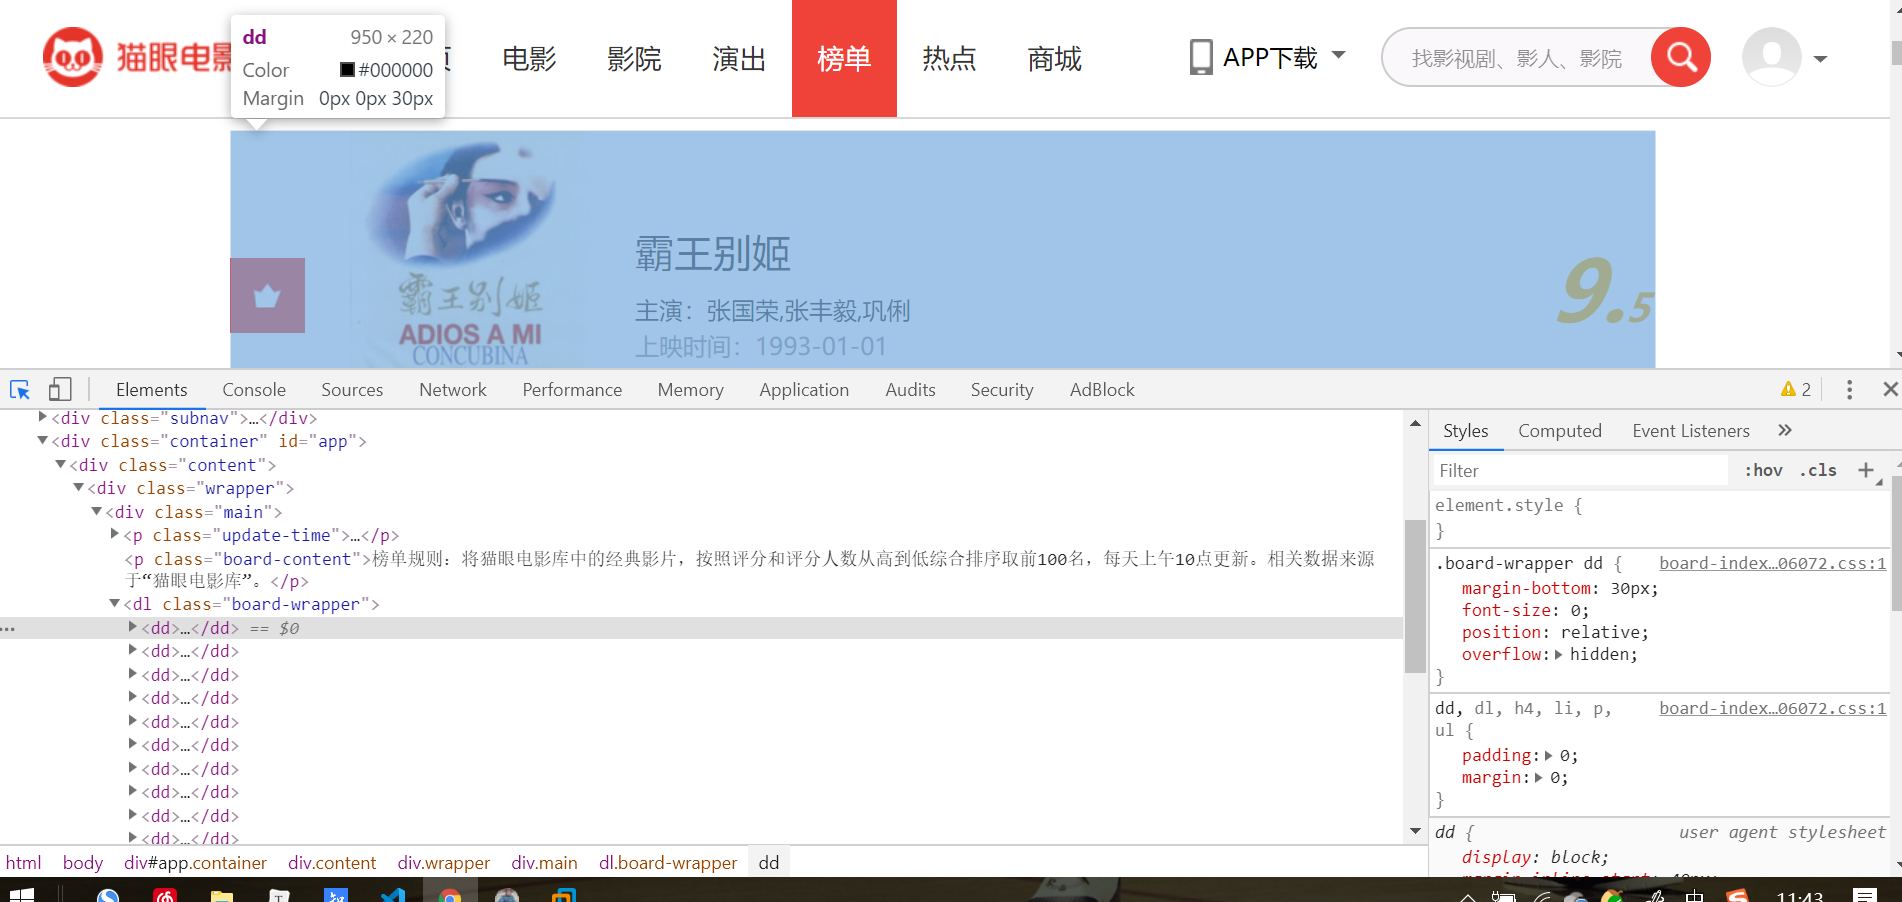
翻页操作只会改变offset偏移量,每部电影的信息都在dd标签内,使用pyquery库中的css选择器直接解析页面
代码君
- css选择器直接选择和使用find()方法的区别:find()用于选择子节点,因此限定了选择的区域,速度可能要快些,直接传入
‘’选择器可能要全盘扫描(这里只是为了我自己方便记忆,信息可能有误,欢迎指出) - 一般先直接传入选择器选择出包含所需信息的大标签,再使用find()选择大标签里面的细节信息
- 还有需要注意的一点是,不能直接在Elements选项卡中直接查看源码,那里的源码可能经过JavaScript渲染而与原始请求不同,而是需要从Network选项卡部分查看原始请求得到的源码
使用csv格式存储:相比txt格式,csv格式更利于数据存储和处理,大规模数据可以使用数据库存储
#use pyquery get the data and save as csv

from pyquery import PyQuery as pq #as是为PyQuery类取一个别名

import csv

import time

begin=time.clock() #添加程序开始时间

def get_page(url):

    headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.100 Safari/537.36'

    }

    #添加头部信息,防止被网站识别出是python爬虫而被禁止访问

    doc=pq(url,headers=headers)

    return doc

def parse_page(doc):

    dict={}

    dd=doc('.board-wrapper').find('dd')

    '''yield在函数中的功能类似于return,不同的是yield每次返回结果之后函数并没有退出,而是每次遇到yield关键字后返回相应结果,并保留函数当前的运行状态,等待下一次的调用。如果一个函数需要多次循环执行一个动作,并且每次执行的结果都是需要的,这种场景很适合使用yield实现。'''

    for item in dd.items():

        yield { #返回一个字典

            'rank':item.find('.board-index').text(),

            'name':item.find('.name').text(),

            'img':item.find('.board-img').attr('data-src'),

            'star':item.find('.star').text(),

            'time':item.find('.releasetime').text().strip(),#strip()转化为字符串去除前后空格,strip()[3:]表示从取下标从3的位置开始到文件结尾

            'score':item.find('.score').find('.integer').text().strip()+item.find('.score').find('.fraction').text().strip(),

        }

def write_to_file(item): #接收一个字典

    writer.writerow((item['rank'],item['name'],item['img'],item['star'],item['time'],item['score']))

def main():

    for i in range(10):

        url='https://maoyan.com/board/4?offset='+str(i*10)

        doc=get_page(url)

        #print(doc)

        for item in parse_page(doc):

            print(item)

            write_to_file(item)

        #线程推迟1s,一些反爬取网站,如果速度过快会无响应,故增加一个延时等待

        time.sleep(1)

if __name__ == '__main__':

    f = open('test.csv', 'a', newline='', encoding='utf-8')

    writer = csv.writer(f)

    writer.writerow(('Rank','Name','Picture','Star','Time','Score'))#写入头部信息

    main()

    f.close() #手动关闭文件对象

    end=time.clock() #添加程序结束时间

    # 输出CPU耗时,不包括线程推迟的时间,是正常情况下(不考虑等待)程序的耗时

    print("爬取完毕,CPU耗时:%f s"%(end-begin))
使用文本txt格式存储
'''pyquery get the data and save as txt'''

import json

import time

import requests

from pyquery import PyQuery as pq

def get_page(url):

    headers = {

        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/76.0.3809.100 Safari/537.36'

    }

    doc=pq(url)

    return doc

def parse_page(doc):

     dd=doc('.board-wrapper').find('dd')

     for item in dd.items():

         yield {

             'index': item.find('.board-index').text(),

             'image': item.find('.board-img').attr('data-src'),

             'title': item.find('.name').text(),

             'actor': item.find('.star').text().strip()[3:],

             'time': item.find('.releasetime').text(),

             'score': item.find('.score').find('.integer').text().strip() + item.find('.score').find(

                 '.fraction').text().strip()

         }

def write_to_file(item):

    with open('test.csv','a',encoding='utf-8') as f:

        f.write(json.dumps(item,ensure_ascii=False)+'\n')#False表示不使用ascii表示中文,可以直接显示中文

def main():

    for i in range(10):

        url = 'https://maoyan.com/board/4?offset='+str(i*10)

        doc=get_page(url)

        for item in parse_page(doc):

            print(item)

            write_to_file(item)
# [爬虫Demo] pyquery+csv爬取猫眼电影top100的更多相关文章
- # 爬虫连载系列(1)--爬取猫眼电影Top100
前言 学习python有一段时间了,之前一直忙于学习数据分析,耽搁了原本计划的博客更新.趁着这段空闲时间,打算开始更新一个爬虫系列.内容大致包括:使用正则表达式.xpath.BeautifulSoup ...
- 爬虫练习之正则表达式爬取猫眼电影Top100
#猫眼电影Top100import requests,re,timedef get_one_page(url): headers={ 'User-Agent':'Mozilla/5.0 (Window ...
- 爬虫系列(1)-----python爬取猫眼电影top100榜
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天在整理代码时,整理了一下之前自己学习爬虫的一些代码,今天先上一个简单的例子,手把手教你入门Python爬虫,爬取 ...
- PYTHON 爬虫笔记八:利用Requests+正则表达式爬取猫眼电影top100(实战项目一)
利用Requests+正则表达式爬取猫眼电影top100 目标站点分析 流程框架 爬虫实战 使用requests库获取top100首页: import requests def get_one_pag ...
- 50 行代码教你爬取猫眼电影 TOP100 榜所有信息
对于Python初学者来说,爬虫技能是应该是最好入门,也是最能够有让自己有成就感的,今天,恋习Python的手把手系列,手把手教你入门Python爬虫,爬取猫眼电影TOP100榜信息,将涉及到基础爬虫 ...
- 40行代码爬取猫眼电影TOP100榜所有信息
主要内容: 一.基础爬虫框架的三大模块 二.完整代码解析及效果展示 1️⃣ 基础爬虫框架的三大模块 1.HTML下载器:利用requests模块下载HTML网页. 2.HTML解析器:利用re正则表 ...
- 用requests库爬取猫眼电影Top100
这里需要注意一下,在爬取猫眼电影Top100时,网站设置了反爬虫机制,因此需要在requests库的get方法中添加headers,伪装成浏览器进行爬取 import requests from re ...
- python 爬取猫眼电影top100数据
最近有爬虫相关的需求,所以上B站找了个视频(链接在文末)看了一下,做了一个小程序出来,大体上没有修改,只是在最后的存储上,由txt换成了excel. 简要需求:爬虫爬取 猫眼电影TOP100榜单 数据 ...
- 一起学爬虫——使用xpath库爬取猫眼电影国内票房榜
之前分享了一篇使用requests库爬取豆瓣电影250的文章,今天继续分享使用xpath爬取猫眼电影热播口碑榜 XPATH语法 XPATH(XML Path Language)是一门用于从XML文件中 ...
随机推荐
- 前端 Jenkins 自动化部署
这两天折腾了一下 Jenkins 持续集成,由于公司使用自己搭建的 svn 服务器来进行代码管理,因此这里 Jenkins 是针对 svn 服务器来进行的配置,Git 配置基本一致,后面也介绍了下针对 ...
- HTML状态消息和方法
参考链接1 参考链接2 当浏览器从 web 服务器请求服务时,可能会发生错误. HTML消息 1xx: 信息 消息: 描述: 100 Continue 服务器仅接收到部分请求,但是一旦服务器并没有拒绝 ...
- phpstorm 比较修改过的代码 version control
- jstack+jdb命令查看线程及死锁堆栈信息
如果程序挂死,有时使用jstack查看进程中线程信息时,需要添加上-F参数,此时如果有死锁信息,则可能不会打印出死锁堆栈信息,使用jdb则可以查看当前死锁线程的运行堆栈. 如下模拟一个简单的死锁程序 ...
- 一、基础篇--1.2Java集合-HashMap死循环问题
为什么HashMap会出现死循环 首先,我们知道java的HashMap不是线程安全的.多线程下应该使用ConcurrentHashMap. HashMap底层是基于动态数组和单向链表(JDK1.7, ...
- 一句话说明Facbook React证书的矛盾点
这项专利授权说,如果您要使用我们根据这项授权发布的软件,假如您因为专利侵权而提起诉讼,您将失去我们的专利许可.
- ACCESS_ONCE的作用
如果你看过 Linux 内核中的 RCU 的实现,你应该注意到了这个叫做 ACCESS_ONCE() 宏. ACCESS_ONCE的定义如下: #define __ACCESS_ONCE(x) ({ ...
- Vue avoid mutating a prop directly since the value will be overwritten
<!DOCTYPE html> <html> <head> <meta charset="UTF-8"> <title> ...
- springboot2.0---控制台打印Mybatis的SQL记录
题记:每次使用mybatis出错,都不知道sql原因,debug也不出结果,索性将其打印出来,更加容易排错. 亲测有效,只需要将下面的logback.xml放置在resource目录下即可打印. 方式 ...
- flutter json转字符串 字符串转json
一段json字符串 var jsonStr = '{\"errorCode\": \"0\", \"message\": \"成功 ...