
MYSQ创建联合索引,字段的先后顺序,对查询的影响分析
MYSQ创建联合索引,字段的先后顺序,对查询的影响分析
前言
对于联合索引我们知道,在使用的时候有一个最左前缀的原则,除了这些呢,比如字段放置的位置,会不会对索引的效率产生影响呢?
最左匹配原则
联合索引时会遵循最左前缀匹配的原则,即最左优先,在检索数据时从联合索引的最左边开始匹配,示例:
create table test

(

    id       bigint auto_increment

        primary key,

    column_1 bigint null,

    column_2 bigint null,

    column_3 bigint null

);

create index test_column_1_column_2_column_3_index

    on test (column_1, column_2, column_3);
比如上面的test表,我们建立了联合索引index test_column_1_column_2_column_3_index on test (column_1, column_2, column_3);当我们进行查询的时候,按照最左前缀的原则,当查询(column_1)、(column_1,column_2)(column_1,column_2,column_3)这三种组合是可以用到我们定义的联合索引的。如果我们查询(column_1,column_3)就只能用到column_1的索引了。我们不用太关心索引的先后顺序,什么意思呢?比如使用(column_1,column_2)和(column_2,column_1)的效果是一样的,数据库的查询优化器会自动帮助我们优化我们的sql,看哪个执行的效率最高,
最后才生成最后执行的sql。
为什么会有最左前缀呢?
当使用b+树作为索引的存储数据结构时,当我们创建联合索引的时候,比如(column_1, column_2, column_3),b+树建立索引是从左到右来建立搜索树的,比如当我们来查询的时候WHERE column_1 = 1 AND column_2 = 2 AND column_3 = 3。b+树会先通过最左边的(建立索引的字段的左边的字段)字段,也就是column_1来确定下一步的查找对象,然后找到column_2,在通过column_2的索引找到column_3。所以(column_2,column_3)这样的查询命中不到索引了。因为最左前缀,一定是从最左边的字段开始依次在b+树的子节点查询,然后确定下一个查找的子节点的数据。所以我们(column_1)、(column_1,column_2)、(column_1,column_2,column_3)这三种查询条件是可以使用到索引的。
联合索引的存储结构
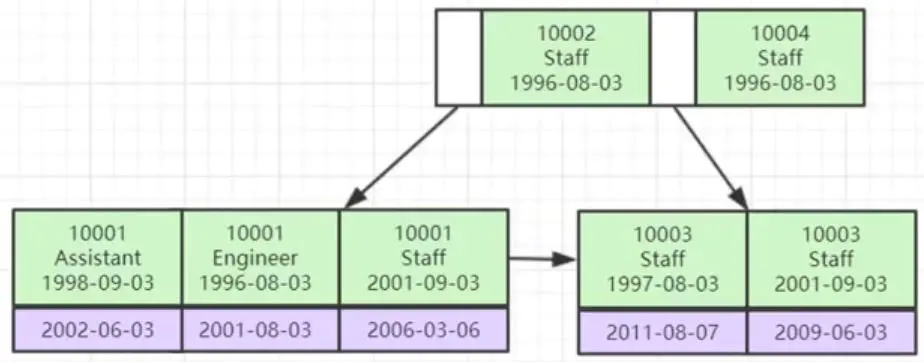
定义联合索引(员工级别,员工姓名,员工出生年月),将联合索引按照索引顺序放入节点中,新插入节点时,先按照联合索引中的员工级别比较,如果相同会按照是员工姓名比较,如果员工级别和员工姓名都相同 最后是员工的出生年月比较。可以从图中从上到下,从左到右看,第一个B+树的节点 是通过联合索引的员工级别比较的,第二个节点是 员工级别相同,会按照员工姓名比较,第三个节点是 员工级别和员工姓名都相同,会按照员工出生年月比较。
联合索引字段的先后顺序
我们定义多个字段的联合索引,会考虑到字段的先后顺序。那么字段的先后顺序真的会对查询的效率产生影响吗?比如上面的联合索引index test_column_1_column_2_column_3_index on test (column_1, column_2, column_3);和index test_column_1_column_2_column_3_index on test (column_2, column_1, column_3);在查询效率上有差别吗?我们试验下
写个函数批量插入下数据
CREATE PROCEDURE dowhile()

BEGIN

  DECLARE v1 INT DEFAULT 20000000;

  WHILE v1 > 0 DO

    INSERT INTO test.test (column_1, column_2, column_3) VALUES (RAND() * 20000000, RAND() * 10000, RAND() * 20000000);

    SET v1 = v1 - 1;

END WHILE;

END;
我们插入了20000000条数据,然后先设置索引(column_1, column_2, column_3)中column_1的数值范围为0到20000000,column_2的范围为0到10000。然后查询,看看这个索引的效率。数据量太大,插入的时间可能要好久。为什么插入20000000条呢,因为b+树可以高效存储的数据条数就是21902400,具体见下文。
我们尝试下查询的效率
SELECT * FROM test WHERE column_1=19999834 AND  column_2=3601

> OK

> 时间: 0.001s

EXPLAIN SELECT * FROM test WHERE column_1=19999834 AND  column_2=3601
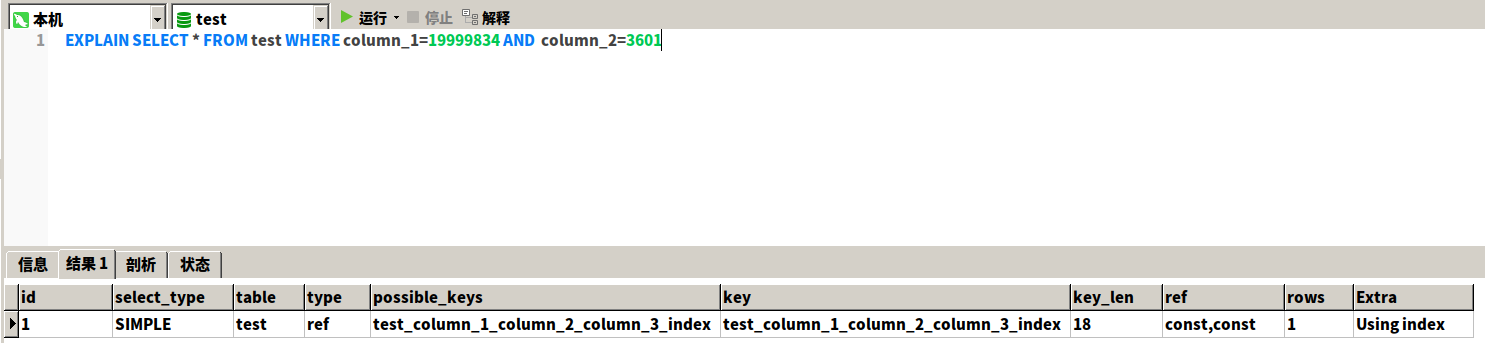
我们看到索引的type为ref已经相当高效了。
type:这列最重要,显示了连接使用了哪种类别,有无使用索引,是使用Explain命令分析性能瓶颈的关键项之一。
结果值从好到坏依次是:
system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALL
一般来说,得保证查询至少达到range级别,最好能达到ref,否则就可能会出现性能问题。
然后我们看下插入的效率
INSERT INTO test.test (column_1, column_2, column_3) VALUES (RAND() * 20000000, RAND() * 10000, RAND() * 20000000)

> Affected rows: 1

> 时间: 0.002s
更改索引的顺序
drop index test_column_1_column_2_column_3_index on test;

create index test_column_2_column_1_column_3_index

	on test (column_2, column_1, column_3);
我们把column_2和column_1的索引位置更换了一下,来比较联合索引的先后顺序对查询效率的影响。
SELECT * FROM test WHERE  column_2=3601 AND column_1=19999834

> OK

> 时间: 0.001s

EXPLAIN SELECT * FROM test WHERE  column_2=3601 AND column_1=19999834
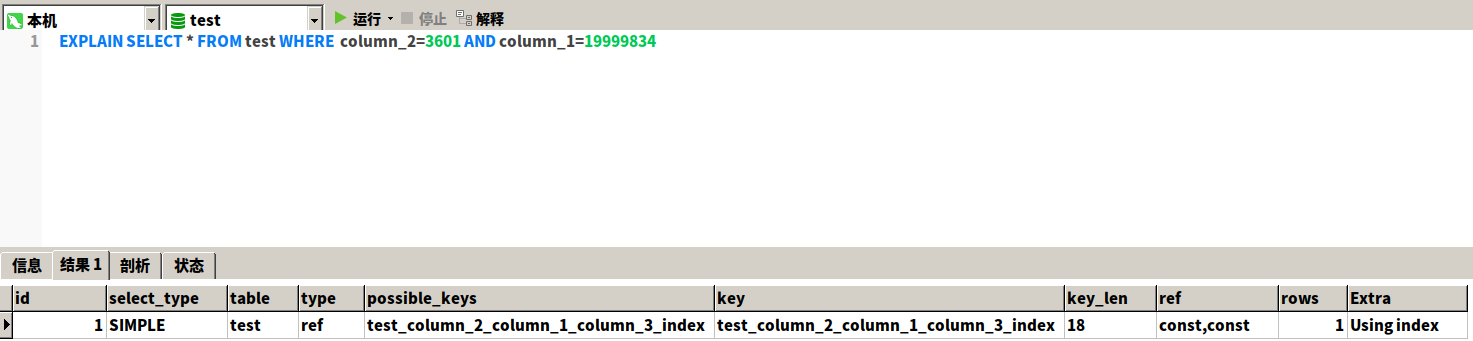
发现更换了之后查询时间上没有什么出入,还和上个查询的时间一样,分析查询的效率一样很高。
再来看插入的效率
INSERT INTO test.test (column_1, column_2, column_3) VALUES (RAND() * 20000000, RAND() * 10000, RAND() * 20000000)

> Affected rows: 1

> 时间: 0.003s
依然高效
所以我们可以总结出来,联合索引中字段的先后顺序,在sql层面的执行效率,差别不大,是可以忽略的。分析上面索引的数据结构也是可以推断出来的,无非就是当建立联合索引,更换索引字段的先后顺序,匹配每个字段锁定的数据条数不一样,但是对最终的查询效率没有太大的影响。但是这个字段的顺序真的就不用考虑吗?不是的,我们知道有最左匹配原则,所以我们要考虑我们的业务,比如说我们的业务场景中有一个字段enterpriseId,这个字段在80%的查询场景中都会遇到,那么我们肯定首选将这个字段放在联合索引字段的第一个位置,这样就能保证查询的高效,能够命中我们建立的索引。
b+树可以存储的数据条数
b+树 正常的高度是(1~3)一个整型8b 指针占用6b,mysql页文件默认16K,16k的数据可以存储16/14b=1170 三层的数据大概就是1170*1170*16=21902400(千万条数据)所以千万级别的数据,对于建了索引的数据库查询的数据库也是很快的。
总结
对于联合索引,我们不能忽略它的最左匹配原则,即在检索数据时从联合索引的最左边开始匹配。对于创建联合索引时,我们要根据我们的具体的查询场景来定,联合索引字段的先后顺序,联合索引字段的先后顺序在sql层面上没有太大差别,但是结合查询的场景和最左匹配的原则,就能使一些查询的场景不能很好的命中索引,这点使我们是不能忽略的。
参考
【最左匹配原则的理解】https://blog.csdn.net/u013164931/article/details/82386555
【深入理解Mysql索引底层数据结构与算法】https://juejin.im/post/5d5c85d4f265da039f12ba97
【MySQL技术内幕 InnoDB存储引擎 第2版】
MYSQ创建联合索引,字段的先后顺序,对查询的影响分析的更多相关文章
- Mysql 创建联合索引注意事项
当一个表有多条索引可走时, Mysql 根据查询语句的成本来选择走哪条索引, 联合索引的话, 它往往计算的是第一个字段(最左边那个), 这样往往会走错索引. 如: 索引Index_1(Crea ...
- MySQL索引 索引分类 最左前缀原则 覆盖索引 索引下推 联合索引顺序
MySQL索引 索引分类 最左前缀原则 覆盖索引 索引下推 联合索引顺序 What's Index ? 索引就是帮助RDBMS高效获取数据的数据结构. 索引可以让我们避免一行一行进行全表扫描.它的 ...
- MYSQL 什么时候用单列索引?什么使用用联合索引?(收集)
我一个表 students 表,有3个字段 ,id,name,age 我要查询 通过 name 和age,在这两个字段 是创建 联合索引?还是分别在name和age上创建 单列索引呢? 多个字段查询什 ...
- MYSQL 什么时候用单列索引?什么使用用联合索引?
我一个表 students 表,有3个字段 ,id,name,age 我要查询 通过 name 和age,在这两个字段 是创建 联合索引?还是分别在name和age上创建 单列索引呢? 多个字段查询什 ...
- Mysql中联合索引的最左匹配原则
在Mysql建立多列索引(联合索引)有最左前缀的原则,即最左优先. 如果我们建立了一个2列的联合索引(col1,col2),实际上已经建立了两个联合索引(col1).(col1,col2); 如果有一 ...
- mysql 最左匹配 联合索引
mysql建立多列索引(联合索引)有最左前缀的原则,即最左优先,如: 如果有一个2列的索引(col1,col2),则已经对(col1).(col1,col2)上建立了索引:如果有一个3列索引(col1 ...
- 性能测试四十二:sql案例之联合索引最左前缀
联合索引:一个索引同时作用于多个字段 联合索引的最左前缀: A.B.C3个字段--联合索引 这个时候,可以使用的查询条件有:A.A+B.A+C.A+B+C,唯独不能使用B+C,即最左侧那个字段必须匹配 ...
- MySQL联合索引运用-最左匹配原则
前言 之前看了很多关于MySQL索引的文章也看了<高性能MySQL>这本书,自以为熟悉了MySQL索引使用原理,入职面试时和面试官交流,发现对复合索引的使用有些理解偏颇,发现自己的不足整理 ...
- Mysql中联合索引的最左匹配原则(百度)
创建联合索引时列的选择原则 经常用的列优先(最左匹配原则) 离散度高的列优先(离散度高原则) 宽度小的列优先(最少空间原则) 在Mysql建立多列索引(联合索引)有最左前缀的原则,即最左优先.如果我们 ...
随机推荐
- CSS每日学习笔记(0)
7.29.2019 1. CSS 指层叠样式表 (Cascading Style Sheets) 样式定义如何显示 HTML 元素 样式通常存储在样式表中 把样式添加到 HTML 4.0 中,是为了解 ...
- 软件工程作业0——The Road Not Taken
目录 第一部分:结缘计算机 缘起 四顾 思考 第二部分:在计算机系里学习 挑战 落差 第三部分:未来规划 向前 未来四个月的软工课 项目 内容 这个作业属于 2020春季计算机学院软件工程(罗杰 任健 ...
- Java锁的深度化--重入锁、读写锁、乐观锁、悲观锁
Java锁 锁一般来说用作资源控制,限制资源访问,防止在并发环境下造成数据错误 锁作为并发共享数据,保证一致性的工具,在JAVA平台有多种实现(如 synchronized(重量级) 和 Reentr ...
- 基于 HTML5 WebGL 与 GIS 的智慧机场大数据可视化分析【转载】
前言:大数据,人工智能,工业物联网,5G 已经或者正在潜移默化地改变着我们的生活.在信息技术快速发展的时代,谁能抓住数据的核心,利用有效的方法对数据做数据挖掘和数据分析,从数据中发现趋势,谁就能做到精 ...
- 初步了解HTTP协议
1.HTTP简介 全称:Hyper Text Transfer Protocol,中文名:超文本传输协议. 功能:HTTP是客户端浏览器或其他程序与web服务器之间的应用层通信协议. 特点:a.支持 ...
- Centos 非root用户安装rabbitmq
RabbitMQ是一个开源消息队列服务器,您可以使用它来构建您的消息传递应用程序.简单地说,您可以将来自一个应用程序的消息放入队列,并从来自相同应用程序或不同应用程序的队列中检索消息.您可以使用多种编 ...
- [概率] HDU 2019 Multi-University Training Contest 10 - Valentine's Day
Valentine's Day Time Limit: 2000/2000 MS (Java/Others) Memory Limit: 524288/524288 K (Java/Others ...
- 从源码学习Java并发的锁是怎么维护内部线程队列的
从源码学习Java并发的锁是怎么维护内部线程队列的 在上一篇文章中,凯哥对同步组件基础框架- AbstractQueuedSynchronizer(AQS)做了大概的介绍.我们知道AQS能够通过内置的 ...
- 【干货】Keras学习资源汇总
目录: Keras简介 Keras学习手册 Keras学习视频 Keras代码案例 Keras&NLP Keras&CV Keras项目 一.Keras简介 Keras是Python中 ...
- 关于用命令行和idea对项目打jar包
前提说一下,我们一般是对编译后的项目进行打包,不然打包后还得自己去重新编译class文件. 假如这是你的一个项目目录: 我们要写一个简单的计算器工具类项目,然后对他进行打包, idea里面out文件夹 ...