
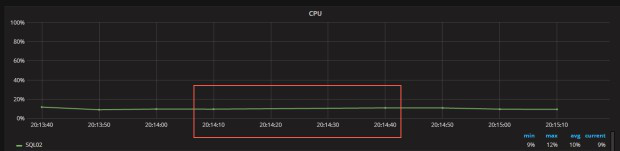
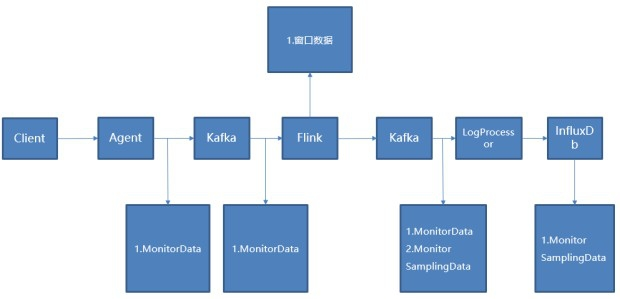
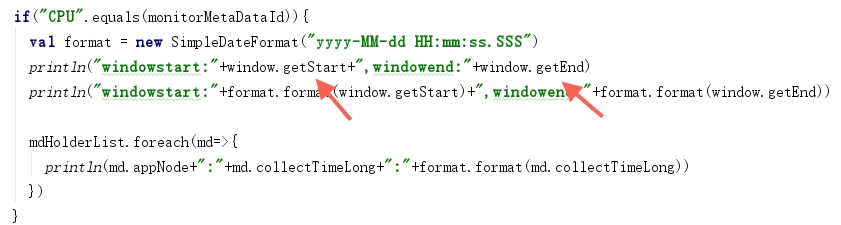
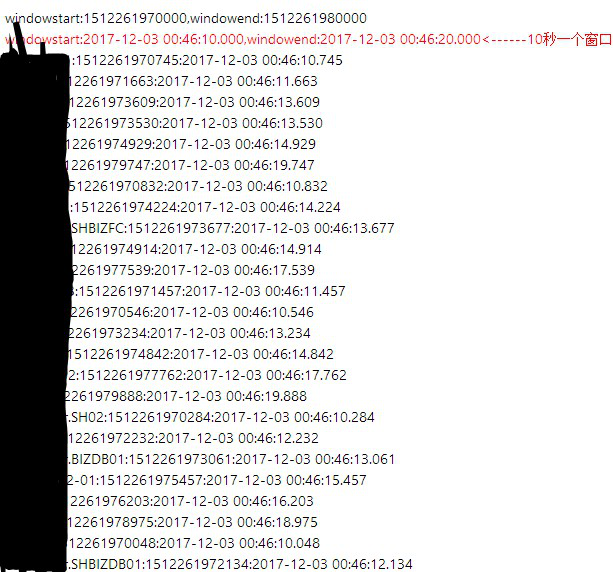
基于Flink秒级计算时CPU监控图表数据中断问题
基于Flink秒级计算时CPU监控图表数据中断问题的更多相关文章
- 《阿里如何实现秒级百万TPS?搜索离线大数据平台大数据平台架构解读》读后感
在使用淘宝时发现搜索框很神奇,它可以将将我们想要的商品全部查询出来,但是我们并感觉不到数据库查询的过程,速度很快.通过阅读这篇文章让我知道了搜索框背后包含着很多技术,对我以后的学习可能很有借鉴. 平时 ...
- [开源]CSharpFlink(NET 5.0开发)分布式实时计算框架,PC机10万数据点秒级计算测试说明
github地址:https://github.com/wxzz/CSharpFlinkgitee地址:https://gitee.com/wxzz/CSharpFlink 1 计算 ...
- 基于supervisor秒级Laravel定时任务
背景介绍 公司需要实现X分钟内每隔Y秒轮训某个接口,Linux自带的crontab貌似只精确到分钟,虽然可以到精确到秒,但是并不满足需求. 选型 公司项目都是 基于 Laravel 框架,所以这个没得 ...
- js 小数计算时出现多余的数据
根据资料显示:是由于十进制换算成二进制,处理后,再由二进制换算成十进制时,造成的误差. 得出:所以(0.1+0.2)!=0.3 而是=0.30000000000000004的结果 解决方法: 参考:h ...
- 腾讯新闻基于 Flink PipeLine 模式的实践
摘要 :随着社会消费模式以及经济形态的发展变化,将催生新的商业模式.腾讯新闻作为一款集游戏.教育.电商等一体的新闻资讯平台.服务亿万用户,业务应用多.数据量大.加之业务增长.场景更加复杂,业务对实时 ...
- 基于 Flink 的实时数仓生产实践
数据仓库的建设是“数据智能”必不可少的一环,也是大规模数据应用中必然面临的挑战.在智能商业中,数据的结果代表了用户反馈.获取数据的及时性尤为重要.快速获取数据反馈能够帮助公司更快地做出决策,更好地进行 ...
- 基于Kafka的实时计算引擎如何选择?Flink or Spark?
1.前言 目前实时计算的业务场景越来越多,实时计算引擎技术及生态也越来越成熟.以Flink和Spark为首的实时计算引擎,成为实时计算场景的重点考虑对象.那么,今天就来聊一聊基于Kafka的实时计算引 ...
- 基于 HTML5 WebGL 的 CPU 监控系统
前言 科技改变生活,科技的发展带来了生活方式的巨大改变.随着通信技术的不断演进,5G 技术应运而生,随时随地万物互联的时代已经来临.5G 技术不仅带来了更快的连接速度和前所未有的用户体验,也为制造业, ...
- (二)基于商品属性的相似商品推荐算法——Flink SQL实时计算实现商品的隐式评分
系列随笔: (总览)基于商品属性的相似商品推荐算法 (一)基于商品属性的相似商品推荐算法--整体框架及处理流程 (二)基于商品属性的相似商品推荐算法--Flink SQL实时计算实现商品的隐式评分 ( ...
随机推荐
- Java Scanner类
package io; import java.util.*; public class useScanner { public static void main(String[] args) { S ...
- MongoDB增删改查操作详解
一.插入 MongoDB的插入操作很简单,使用insert方法,这里演示从创建数据库.创建集合到插入文档.查询文档. 集合创建方法参数说明: size:集合最大空间 max:集合最多文档数量 (超出s ...
- phalcon——闪存消息
使用两种适配器来定义消息传递给Flasher后的行为: (1)Phalcon\Flash\Direct:直接输出传递给flasher的消息 (2)Phalcon\Flash\Session:将消息临时 ...
- 推荐使用国内的豆瓣源安装Python插件
以前都是用pip安装Python插件的,直到今天 pip的原理其实是从Python的官方源pypi.python.org/pypi下载到本地,然后解包安装 但是有的时候,这个操作会非常慢,国内可以通过 ...
- Java多线程高并发学习笔记——阻塞队列
在探讨可重入锁之后,接下来学习阻塞队列,这边篇文章也是断断续续的写了很久,因为最近开始学ssm框架,准备做一个自己的小网站,后续可能更新自己写网站的技术分享. 请尊重作者劳动成果,转载请标明原文链接: ...
- OpenCV4Android
前文曾详细探讨了关于OpenCV的使用,原本以为天下已太平.但不断有人反应依然配不好OpenCV4Android,不能得心应手的在Android上使用OpenCV,大量的精力都浪费在摸索配置上.尤其是 ...
- 基于Lua脚本解决实时数据处理流程中的关键问题
摘要 在处理实时数据的过程中需要缓存的参与,由于在更新实时数据时并发处理的特点,因此在更新实时数据时经常产生新老数据相互覆盖的情况,针对这个情况调查了Redis事务和Lua脚本后,发现Redis事务并 ...
- Count the Colors
Count the Colors Time Limit:2000MS Memory Limit:65536KB 64bit IO Format:%lld & %llu Subm ...
- 不怕你配置不对,就怕你看的资料不对!MIM 与 SharePoint 同步完全配置指南。
为了更好的同步 User Profile,在 SharePoint 2010 中首次引入了 FIM (ForeFront Identity Manager) 用于编辑 User Profile 的同期 ...
- Eclipse 枚举类报错
当你写一个枚举类时,如果没有在枚举类的第一行写有哪些枚举值,那么就会出现编译报错:Syntax error on token "String", strictfp expected ...