
elasticsearch多字段聚合实现方式
1、背景
我们知道在sql中是可以实现 group by 字段a,字段b,那么这种效果在elasticsearch中该如何实现呢?此处我们记录在elasticsearch中的3种方式来实现这个效果。
2、实现多字段聚合的思路
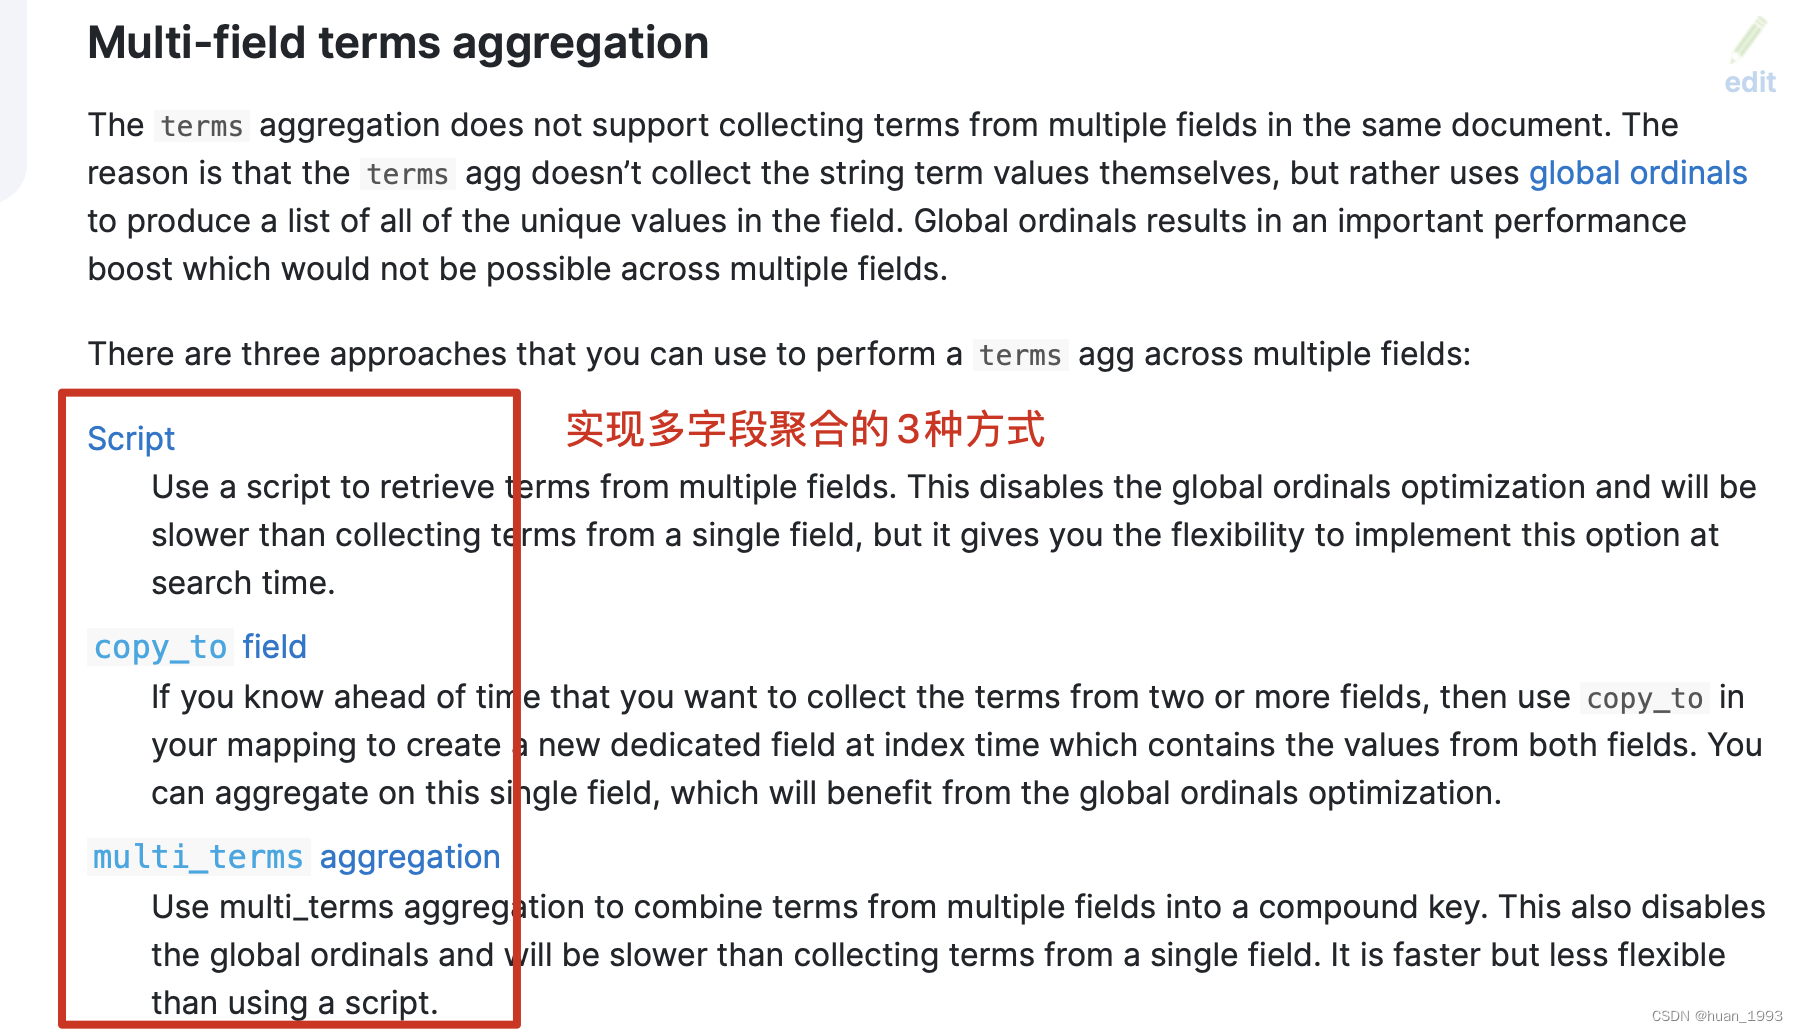
图片来源:https://www.elastic.co/guide/en/elasticsearch/reference/current/search-aggregations-bucket-terms-aggregation.html
从上图中,我们可以知道,可以通过3种方式来实现 多字段的聚合操作。
3、需求
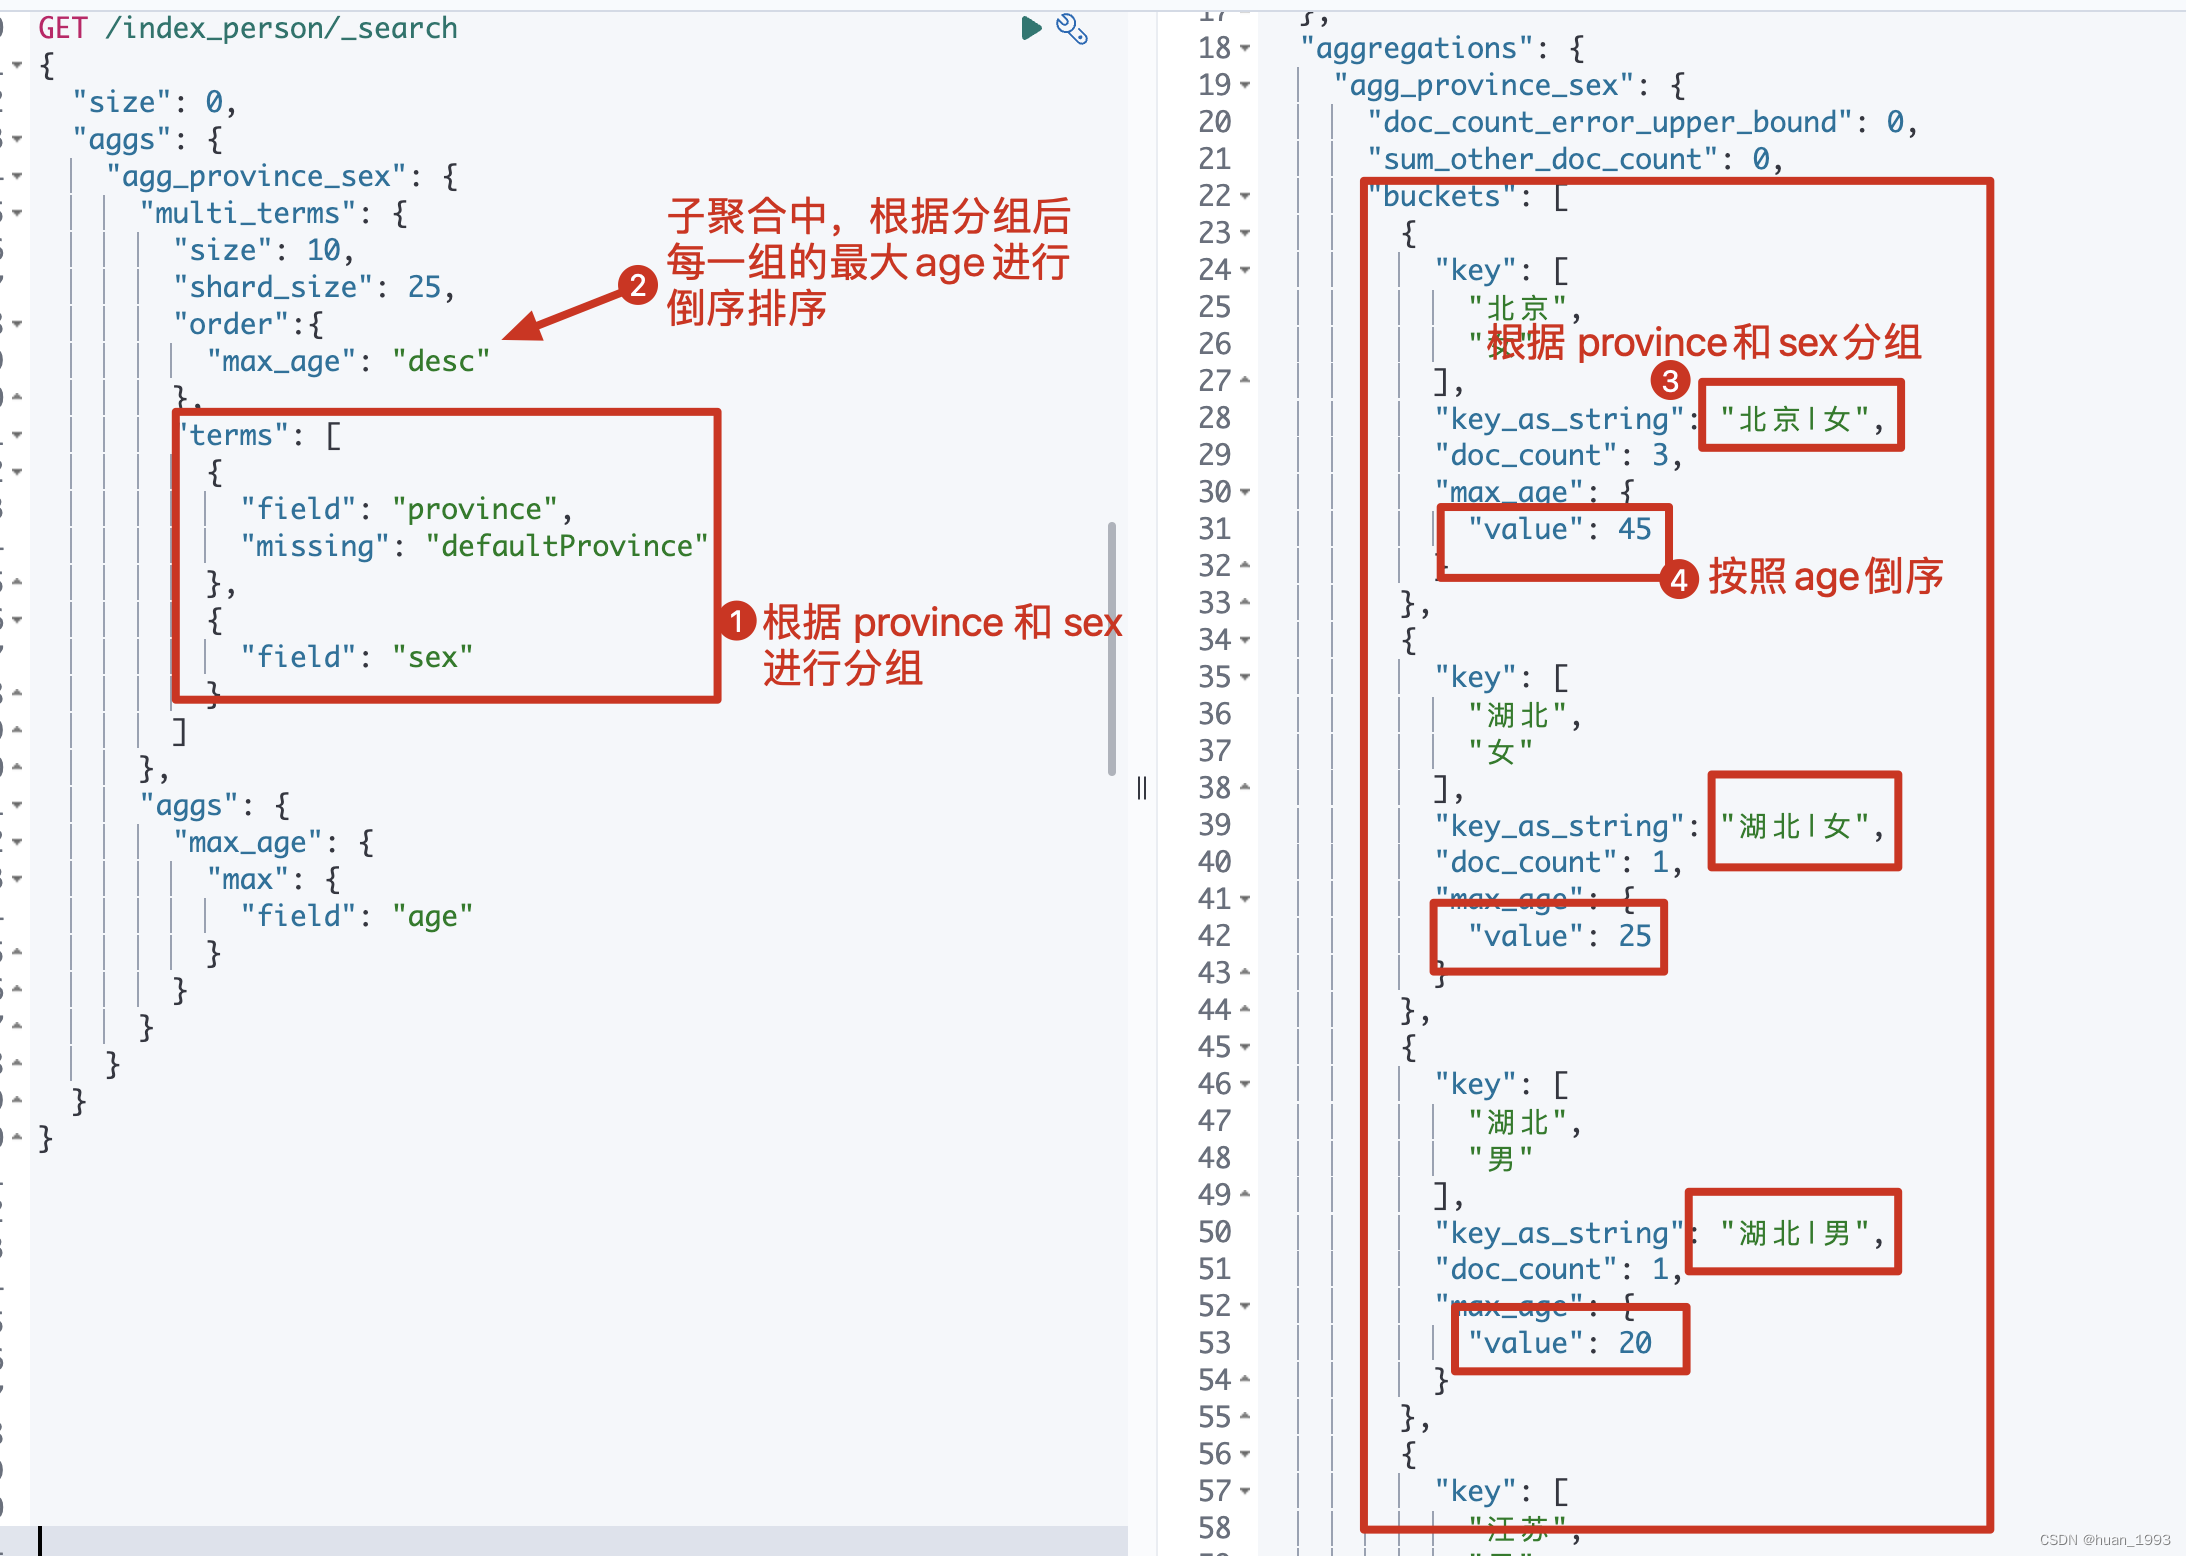
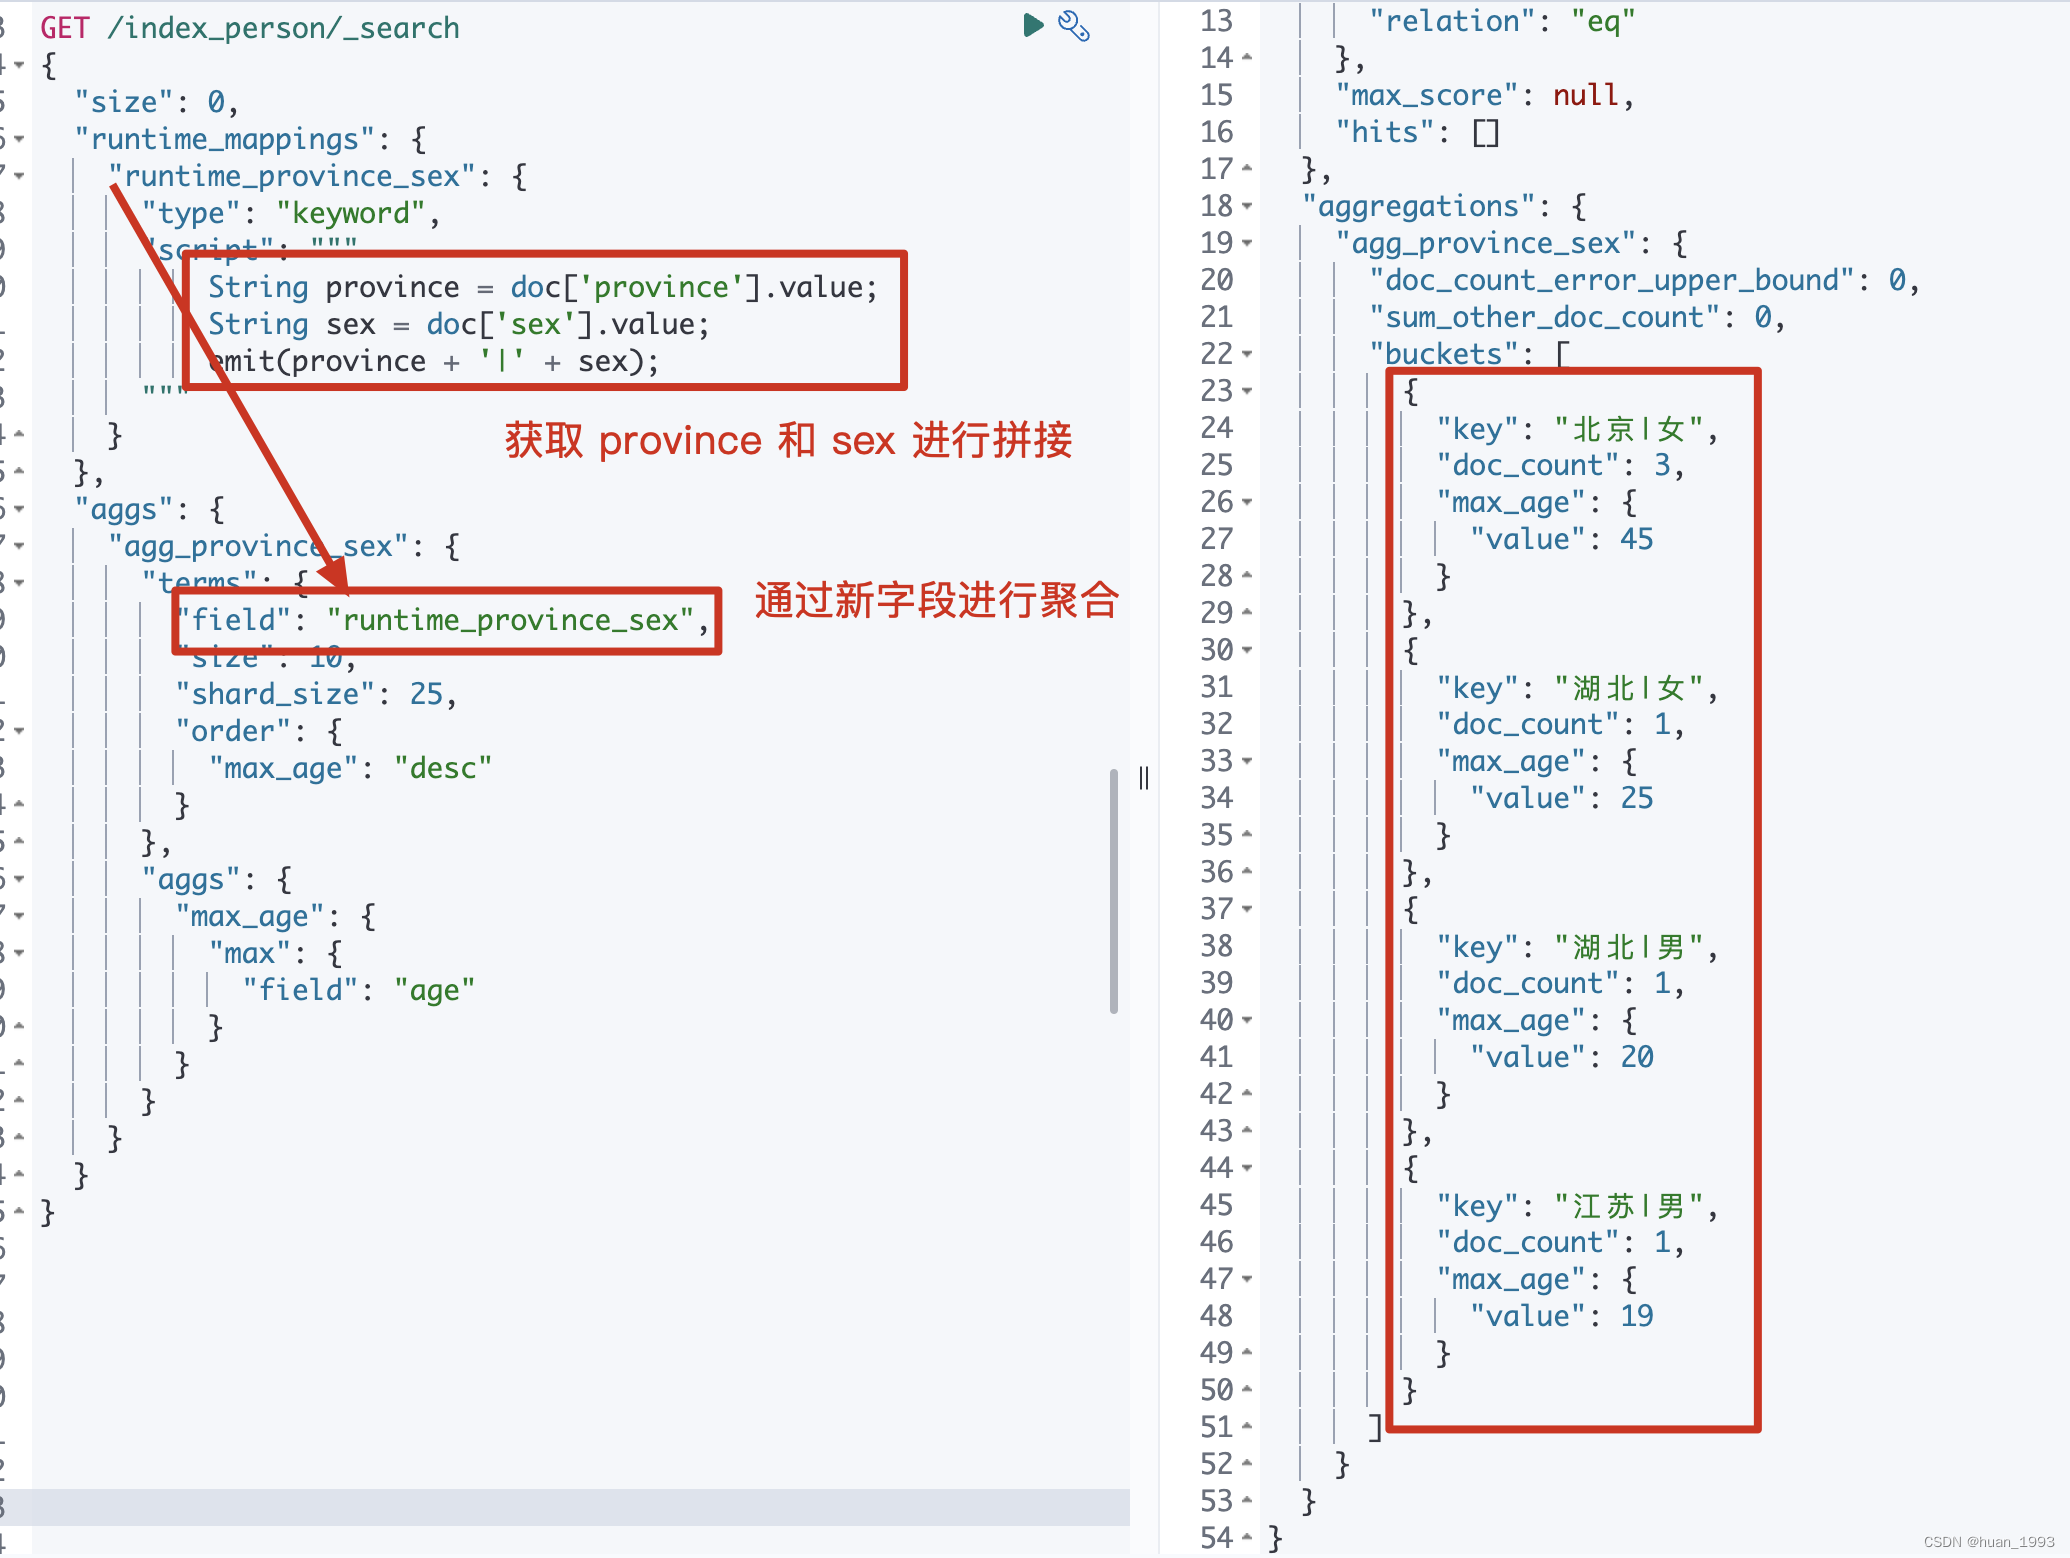
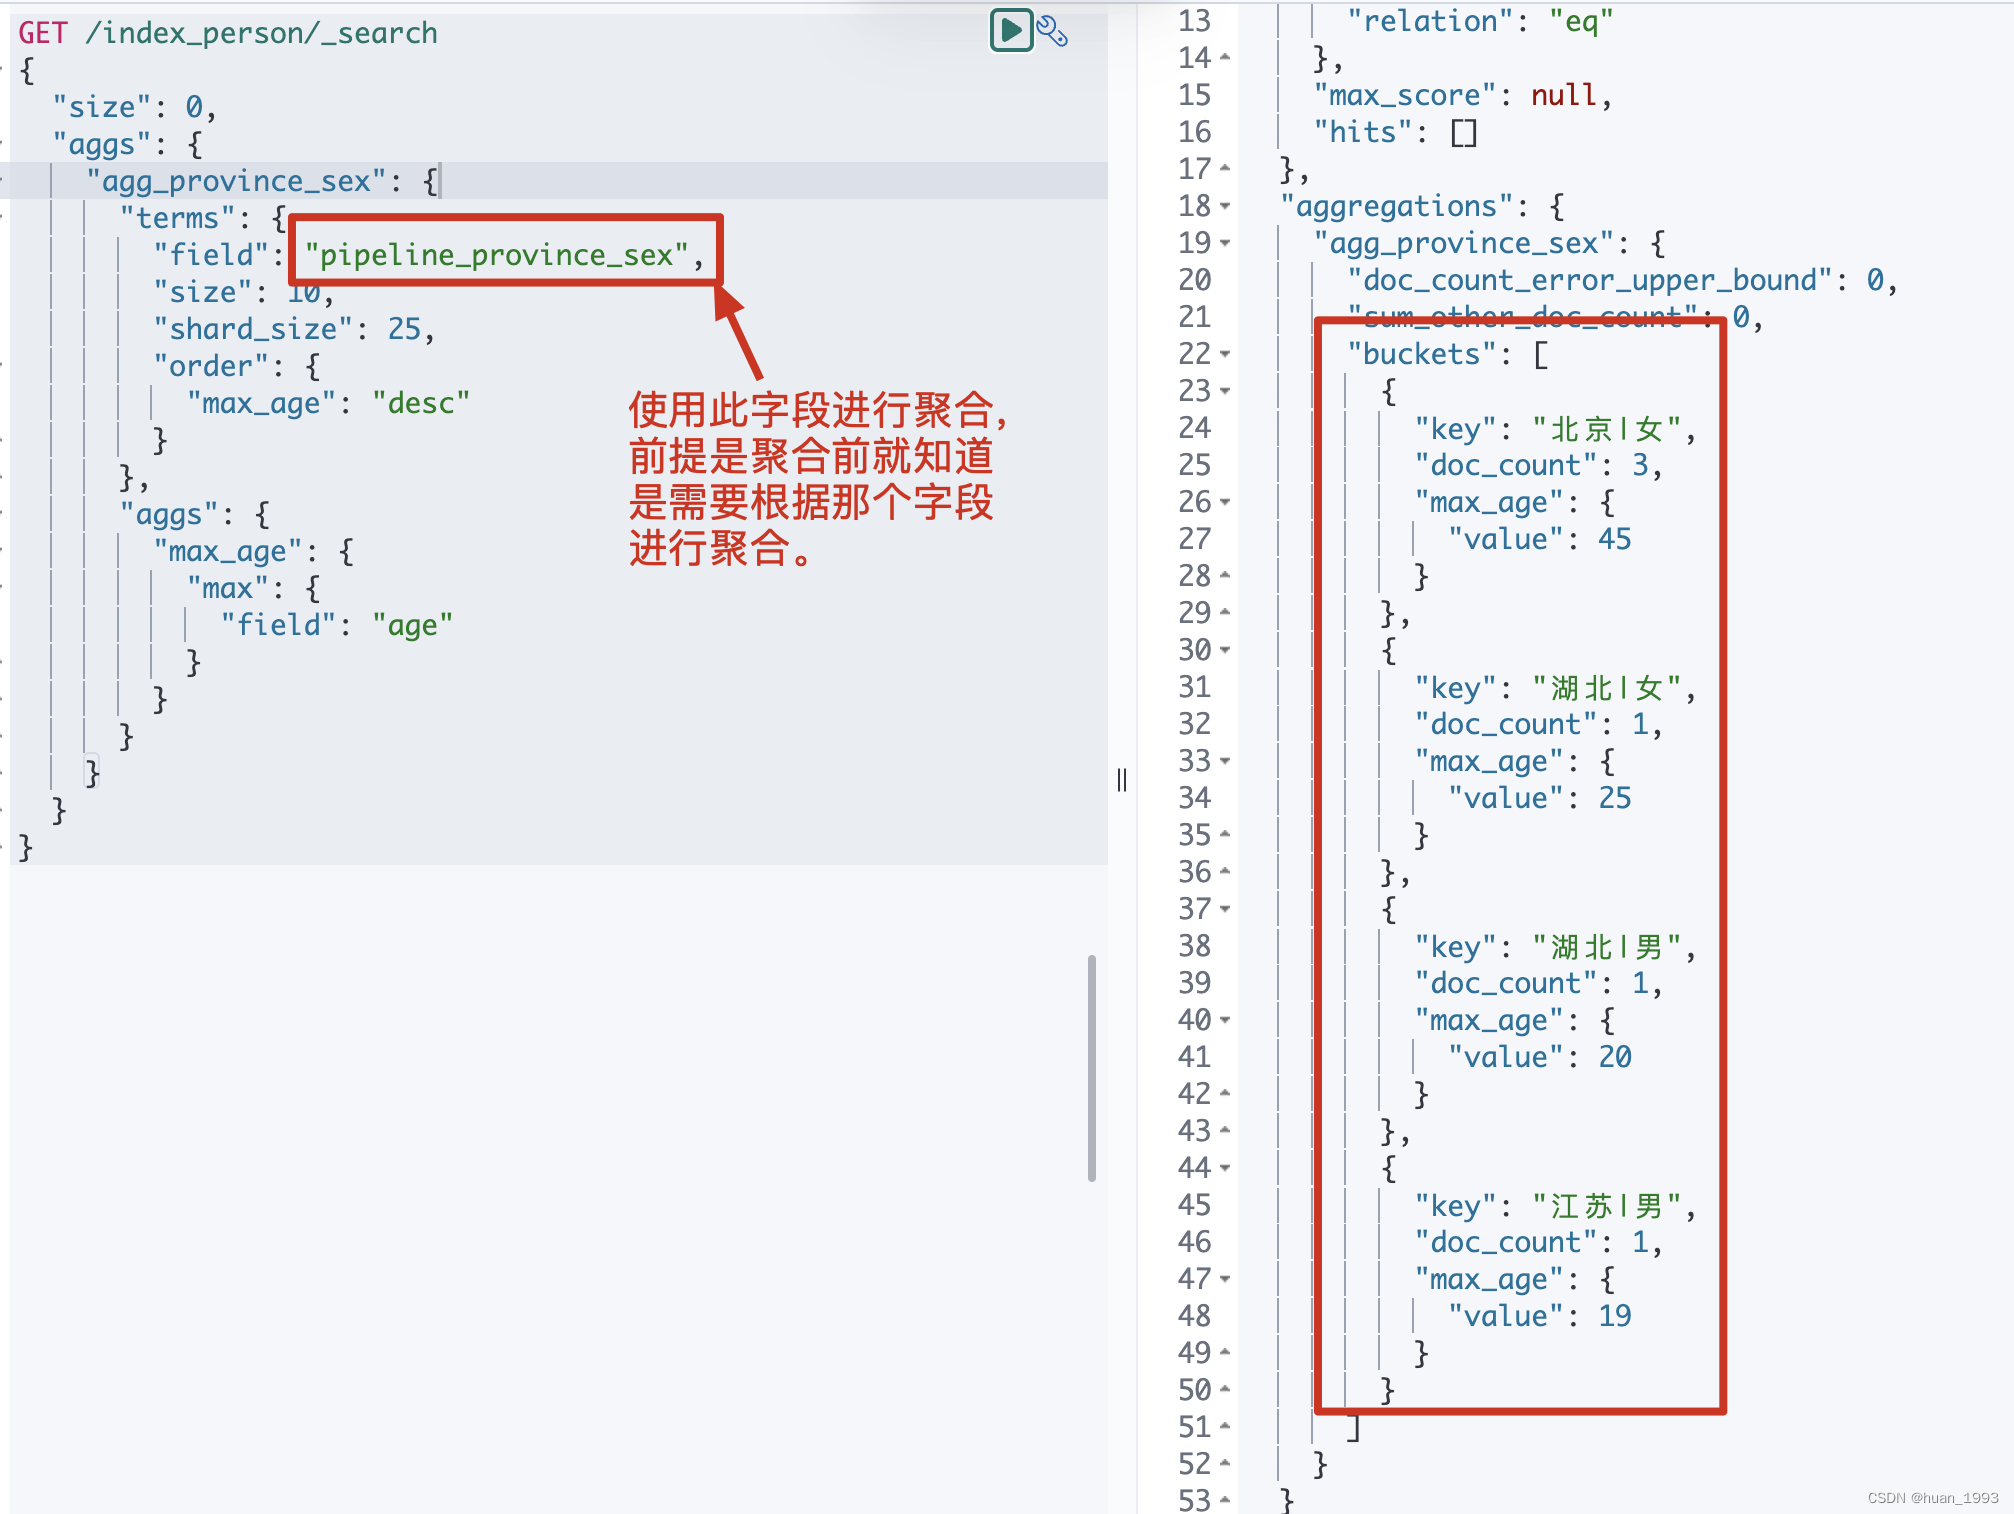
根据省(province)和性别(sex)来进行聚合,然后根据聚合后的每个桶的数据,在根据每个桶中的最大年龄(age)来进行倒序排序。
4、数据准备
4.1 创建索引
PUT /index_person

{

  "settings": {

    "number_of_shards": 1

  },

  "mappings": {

    "properties": {

      "id": {

        "type": "long"

      },

      "name": {

        "type": "keyword"

      },

      "province": {

        "type": "keyword"

      },

      "sex": {

        "type": "keyword"

      },

      "age": {

        "type": "integer"

      },

      "address": {

        "type": "text",

        "analyzer": "ik_max_word",

        "fields": {

          "keyword": {

            "type": "keyword",

            "ignore_above": 256

          }

        }

      }

    }

  }

}
4.2 准备数据
PUT /_bulk

{"create":{"_index":"index_person","_id":1}}

{"id":1,"name":"张三","sex":"男","age":20,"province":"湖北","address":"湖北省黄冈市罗田县匡河镇"}

{"create":{"_index":"index_person","_id":2}}

{"id":2,"name":"李四","sex":"男","age":19,"province":"江苏","address":"江苏省南京市"}

{"create":{"_index":"index_person","_id":3}}

{"id":3,"name":"王武","sex":"女","age":25,"province":"湖北","address":"湖北省武汉市江汉区"}

{"create":{"_index":"index_person","_id":4}}

{"id":4,"name":"赵六","sex":"女","age":30,"province":"北京","address":"北京市东城区"}

{"create":{"_index":"index_person","_id":5}}

{"id":5,"name":"钱七","sex":"女","age":16,"province":"北京","address":"北京市西城区"}

{"create":{"_index":"index_person","_id":6}}

{"id":6,"name":"王八","sex":"女","age":45,"province":"北京","address":"北京市朝阳区"}
5、实现方式
5.1 multi_terms实现
5.1.1 dsl
GET /index_person/_search

{

  "size": 0,

  "aggs": {

    "agg_province_sex": {

      "multi_terms": {

        "size": 10,

        "shard_size": 25,

        "order":{

          "max_age": "desc"

        },

        "terms": [

          {

            "field": "province",

            "missing": "defaultProvince"

          },

          {

            "field": "sex"

          }

        ]

      },

      "aggs": {

        "max_age": {

          "max": {

            "field": "age"

          }

        }

      }

    }

  }

}
5.1.2 java 代码
    @Test

    @DisplayName("多term聚合-根据省和性别聚合,然后根据最大年龄倒序")

    public void agg01() throws IOException {

        SearchRequest searchRequest = new SearchRequest.Builder()

                .size(0)

                .index("index_person")

                .aggregations("agg_province_sex", agg ->

                        agg.multiTerms(multiTerms ->

                                        multiTerms.terms(term -> term.field("province"))

                                                .terms(term -> term.field("sex"))

                                                .order(new NamedValue<>("max_age", SortOrder.Desc))

                                )

                                .aggregations("max_age", ageAgg ->

                                        ageAgg.max(max -> max.field("age")))

                )

                .build();

        System.out.println(searchRequest);

        SearchResponse<Object> response = client.search(searchRequest, Object.class);

        System.out.println(response);

    }
5.1.3 运行结果
5.2 script实现
5.2.1 dsl
GET /index_person/_search

{

  "size": 0,

  "runtime_mappings": {

    "runtime_province_sex": {

      "type": "keyword",

      "script": """

          String province = doc['province'].value;

          String sex = doc['sex'].value;

          emit(province + '|' + sex);

      """

    }

  },

  "aggs": {

    "agg_province_sex": {

      "terms": {

        "field": "runtime_province_sex",

        "size": 10,

        "shard_size": 25,

        "order": {

          "max_age": "desc"

        }

      },

      "aggs": {

        "max_age": {

          "max": {

            "field": "age"

          }

        }

      }

    }

  }

}
5.2.2 java代码
@Test

    @DisplayName("多term聚合-根据省和性别聚合,然后根据最大年龄倒序")

    public void agg02() throws IOException {

        SearchRequest searchRequest = new SearchRequest.Builder()

                .size(0)

                .index("index_person")

                .runtimeMappings("runtime_province_sex", field -> {

                    field.type(RuntimeFieldType.Keyword);

                    field.script(script -> script.inline(new InlineScript.Builder()

                            .lang(ScriptLanguage.Painless)

                            .source("String province = doc['province'].value;\n" +

                                    "          String sex = doc['sex'].value;\n" +

                                    "          emit(province + '|' + sex);")

                            .build()));

                    return field;

                })

                .aggregations("agg_province_sex", agg ->

                        agg.terms(terms ->

                                        terms.field("runtime_province_sex")

                                                .size(10)

                                                .shardSize(25)

                                                .order(new NamedValue<>("max_age", SortOrder.Desc))

                                )

                                .aggregations("max_age", minAgg ->

                                        minAgg.max(max -> max.field("age")))

                )

                .build();

        System.out.println(searchRequest);

        SearchResponse<Object> response = client.search(searchRequest, Object.class);

        System.out.println(response);

    }
5.2.3 运行结果
5.3 通过copyto实现
我本地测试过,通过copyto没实现,此处故先不考虑
5.5 通过pipeline来实现
实现思路:
创建mapping时,多创建一个字段pipeline_province_sex,该字段的值由创建数据时指定pipeline来生产。
5.4.1 创建mapping
PUT /index_person

{

  "settings": {

    "number_of_shards": 1

  },

  "mappings": {

    "properties": {

      "id": {

        "type": "long"

      },

      "name": {

        "type": "keyword"

      },

      "province": {

        "type": "keyword"

      },

      "sex": {

        "type": "keyword"

      },

      "age": {

        "type": "integer"

      },

      "pipeline_province_sex":{

        "type": "keyword"

      },

      "address": {

        "type": "text",

        "analyzer": "ik_max_word",

        "fields": {

          "keyword": {

            "type": "keyword",

            "ignore_above": 256

          }

        }

      }

    }

  }

}
此处指定了一个字段pipeline_province_sex,该字段的值会由pipeline来处理。
5.4.2 创建pipeline
PUT _ingest/pipeline/pipeline_index_person_provice_sex

{

  "description": "将provice和sex的值拼接起来",

  "processors": [

    {

      "set": {

        "field": "pipeline_province_sex",

        "value": ["{{province}}", "{{sex}}"]

      },

      "join": {

        "field": "pipeline_province_sex",

        "separator": "|"

      }

    }

  ]

}
5.4.3 插入数据
PUT /_bulk?pipeline=pipeline_index_person_provice_sex

{"create":{"_index":"index_person","_id":1}}

{"id":1,"name":"张三","sex":"男","age":20,"province":"湖北","address":"湖北省黄冈市罗田县匡河镇"}

{"create":{"_index":"index_person","_id":2}}

{"id":2,"name":"李四","sex":"男","age":19,"province":"江苏","address":"江苏省南京市"}

{"create":{"_index":"index_person","_id":3}}

{"id":3,"name":"王武","sex":"女","age":25,"province":"湖北","address":"湖北省武汉市江汉区"}

{"create":{"_index":"index_person","_id":4}}

{"id":4,"name":"赵六","sex":"女","age":30,"province":"北京","address":"北京市东城区"}

{"create":{"_index":"index_person","_id":5}}

{"id":5,"name":"钱七","sex":"女","age":16,"province":"北京","address":"北京市西城区"}

{"create":{"_index":"index_person","_id":6}}

{"id":6,"name":"王八","sex":"女","age":45,"province":"北京","address":"北京市朝阳区"}
注意: 此处的插入需要指定上一步的pipeline
PUT /_bulk?pipeline=pipeline_index_person_provice_sex
5.4.4 聚合dsl
GET /index_person/_search

{

  "size": 0,

  "aggs": {

    "agg_province_sex": {

      "terms": {

        "field": "pipeline_province_sex",

        "size": 10,

        "shard_size": 25,

        "order": {

          "max_age": "desc"

        }

      },

      "aggs": {

        "max_age": {

          "max": {

            "field": "age"

          }

        }

      }

    }

  }

}
5.4.5 运行结果
6、实现代码
7、参考文档
elasticsearch多字段聚合实现方式的更多相关文章
- elasticsearch 多字段聚合或者对字段子串聚合
以下是字段子串聚合,截取 'your_field' 前八位进行聚合的 Script script = new Script("doc['your_field'].getValue().sub ...
- Elastic Stack之ElasticSearch分布式集群yum方式搭建
Elastic Stack之ElasticSearch分布式集群yum方式搭建 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.搜索引擎及Lucene基本概念 1>.什么 ...
- ElasticSearch6.0 高级应用之 多字段聚合Aggregation(二)
ElasticSearch6.0 多字段聚合网上完整的资料很少 ,所以作者经过查阅资料,编写了聚合高级使用例子 例子是根据电商搜索实际场景模拟出来的 希望给大家带来帮助! 下面我们开始吧! 1. 创建 ...
- 跟我一起学extjs5(17--Grid金额字段单位MVVM方式的选择)
跟我一起学extjs5(17--Grid金额字段单位MVVM方式的选择) 这一节来完毕Grid中的金额字段的金额单位的转换.转换旰使用MVVM特性,整体上和控制菜单的几种模式类似.首先 ...
- Dynamics CRM 通过Odata创建及更新记录各类型字段的赋值方式
CRM中通过Odata方式去创建或者更新记录时,各种类型的字段的赋值方式各不相同,这里转载一篇博文很详细的列出了各类型字段赋值方式,以供后期如有遗忘再次查询使用. http://luoyong0201 ...
- Elastic Stack之ElasticSearch分布式集群二进制方式部署
Elastic Stack之ElasticSearch分布式集群二进制方式部署 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 想必大家都知道ELK其实就是Elasticsearc ...
- 修改MySQL数据库中表和表中字段的编码方式的方法
今天向MySQL数据库中的一张表添加含有中文的数据,可是老是出异常,检查程序并没有发现错误,无奈呀,后来重新检查这张表发现表的编码方式为latin1并且原想可以插入中文的字段的编码方式也是latin1 ...
- [Elasticsearch] 多字段搜索 (六) - 自定义_all字段,跨域查询及精确值字段
自定义_all字段 在元数据:_all字段中,我们解释了特殊的_all字段会将其它所有字段中的值作为一个大字符串进行索引.尽管将所有字段的值作为一个字段进行索引并不是非常灵活.如果有一个自定义的_al ...
- ElasticSearch 6.2 Mapping参数说明及text类型字段聚合查询配置
背景: 由于本人使用的是6.0以上的版本es,在使用发现很多中文博客对于mapping参数的说明已过时.ES6.0以后有很多参数变化. 现我根据官网总结mapping最新的参数,希望能对大家有用处. ...
- 【转】elasticsearch中字段类型默认显示{ "foo": { "type": "text", "fields": { "keyword": {"type": "keyword", "ignore_above": 256} }
官方原文链接:https://www.elastic.co/cn/blog/strings-are-dead-long-live-strings 转载原文连接:https://segmentfault ...
随机推荐
- 第七十一篇:Vue组件的私有和全局注册
好家伙, 1.组件的父子关系 我们封装三个组件,分别为left组件,right组件和App组件 在封装时: 在封装时,彼此的关系是独立的,并不存在父子关系 在使用时: 在使用时,根据彼此的嵌套关系,形 ...
- 第十五章 部署zookeeper集群
1.集群规划 主机名 角色 IP hdss7-11.host.com k8s代理节点1.zk1 10.4.7.11 hdss7-12.host.com k8s代理节点2.zk2 10.4.7.12 h ...
- PHP8中match新语句的操作方法
PHP8 新出的一个语法很好用,就是 match 语句.match 语句跟原来的 switch 类似,不过比 switch 更加的严格和方便 原来的 switch 语句代码如下: 1 function ...
- 如何守护数据安全? 这里有一份RDS灾备方案为你支招
当今世界是一个充满着数据的互联网世界,生活的方方面面都在不断产生着数据,比如出行记录.消费记录.浏览的网页.发送的消息等等.除了文本类型的数据,图像.音乐.声音都是数据.对于企业而言,数据更是重要的生 ...
- csp每日习题
欢迎加入:qq群号:1054587486 做题链接:https://csp.ccf.org.cn/csp/index.action?_access_code=1584494752035 点击模拟考试进 ...
- 第一行代码Android(第3版).pdf下载
2020年人民邮电出版社出版的图书 <第一行代码Android(第3版)>是2020年4月人民邮电出版社出版的图书,作者是郭霖. 封面: 内容简介: <第一行代码 Android 第 ...
- (数据科学学习手札143)为geopandas添加gdb文件写出功能
本文示例代码已上传至我的Github仓库https://github.com/CNFeffery/DataScienceStudyNotes 1 简介 大家好我是费老师,很多读者朋友跟随着我先前写作的 ...
- Java开发学习(三十五)----SpringBoot快速入门及起步依赖解析
一.SpringBoot简介 SpringBoot 是由 Pivotal 团队提供的全新框架,其设计目的是用来简化 Spring 应用的初始搭建以及开发过程. 使用了 Spring 框架后已经简化了我 ...
- .NET 反向代理 YARP 跨域请求 CORS
使用过 nginx 的小伙伴应该都知道,这个中间件是可以设置跨域的,作为今天的主角,同样的 反向代理中间件的 YARP 毫无意外也支持了跨域请求设置. 有些小伙伴可能会问了,怎样才算是跨域呢? 在 H ...
- 学习ASP.NET Core Blazor编程系列五——列表页面
学习ASP.NET Core Blazor编程系列一--综述 学习ASP.NET Core Blazor编程系列二--第一个Blazor应用程序(上) 学习ASP.NET Core Blazor编程系 ...