
Phoneix(三)HBase集成Phoenix创建二级索引
一、Hbase集成Phoneix
1、下载
在官网http://www.apache.org/dyn/closer.lua/phoenix/中选择提供的镜像站点中下载与安装的HBase版本对应的版本。本地使用的1.2.5,故下载的apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz包。
2、上传并解压
tar -zxvf apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz
mv apache-phoenix-4.13.1-HBase-1.2-bin.tar.gz phoenix
3、将phoenix-core-4.13.1-HBase-1.2.jar、phoenix-4.13.1-HBase-1.2-server.jar发送到hregionserver所在的hbase的lib目录下:
cp phoenix-core-4.13.1-HBase-1.2.jar /mnt/hbase/lib/

scp phoenix-core-4.13.1-HBase-1.2.jar slave01:/mnt/hbase/lib/

scp phoenix-core-4.13.1-HBase-1.2.jar slave02:/mnt/hbase/lib/

cp phoenix-4.13.1-HBase-1.2-server.jar /mnt/hbase/lib/

scp phoenix-4.13.1-HBase-1.2-server.jar slave02:/mnt/hbase/lib/

scp phoenix-4.13.1-HBase-1.2-server.jar slave01:/mnt/hbase/lib/
4、重启Hbase
start-hbase.sh
5、启动phoneix
# 进入phoenix下的bin目录

cd phoenix/bin

# 启动

./sqlline.py master:2181
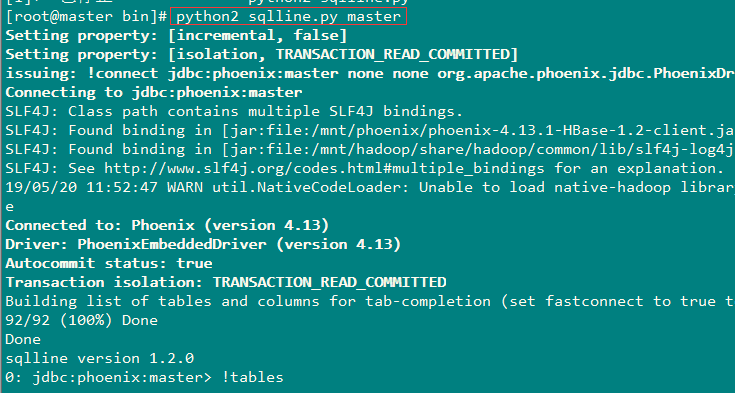
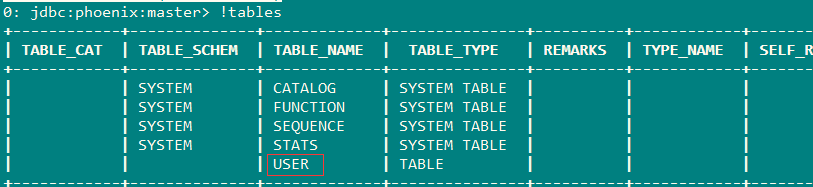
6、创建一张简单的 表测试
0: jdbc:phoenix:master> create table user(id varchar primary key,name varchar,age varchar,phone varchar,email varchar);

No rows affected (1.47 seconds)
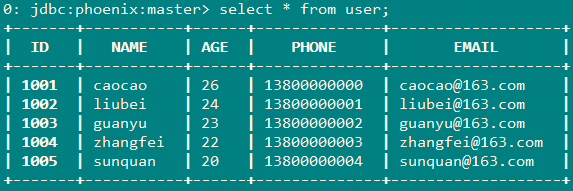
7、插入数据
upsert into user values('1001','caocao','26','13800000000','caocao@163.com');

upsert into user values('1002','liubei','24','13800000001','liubei@163.com');

upsert into user values('1003','guanyu','23','13800000002','guanyu@163.com');

upsert into user values('1004','zhangfei','22','13800000003','zhangfei@163.com');

upsert into user values('1005','sunquan','20','13800000004','sunquan@163.com');
8、通过hbase shell查看
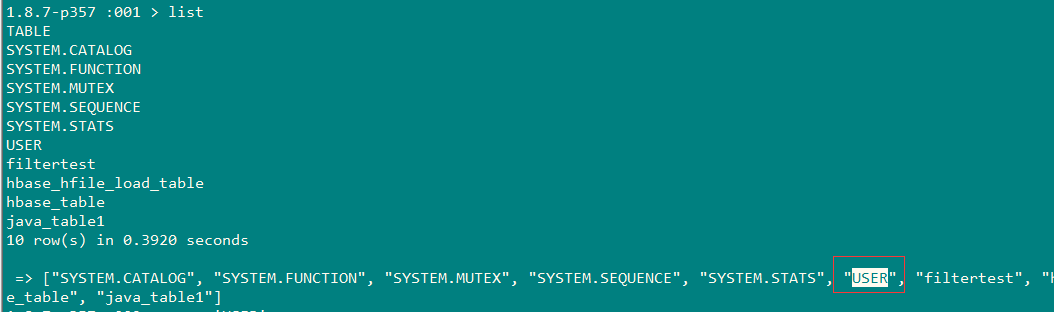

因此配置完成了。。。
二、Phoneix集成Hbase创建二级索引
索引最常用的三个类型:覆盖索引、全局索引、本地索引
1、配置(如果使用的phoneix版本在4.8之后则不需要如下配置,我这里使用的是4.13因此不需要配置)
在每一个RegionServer的hbase-site.xml中加入如下的属性
<property>

    <name>hbase.regionserver.wal.codec</name>

    <value>org.apache.hadoop.hbase.regionserver.wal.IndexedWALEditCodec</value>

</property>

<property>

    <name>hbase.region.server.rpc.scheduler.factory.class</name>

    <value>org.apache.hadoop.hbase.ipc.PhoenixRpcSchedulerFactory</value>

    <description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description>

</property>

<property>

    <name>hbase.rpc.controllerfactory.class</name>

    <value>org.apache.hadoop.hbase.ipc.controller.ServerRpcControllerFactory</value>

    <description>Factory to create the Phoenix RPC Scheduler that uses separate queues for index and metadata updates</description>

</property>
<property>
<name>hbase.coprocessor.regionserver.classes</name>
<value>org.apache.hadoop.hbase.regionserver.LocalIndexMerger</value>
</property>
在每一个Master的hbase-site.xml中加入如下的属性(phoneix版本在4.8之后不用添加):
<property>

    <name>hbase.master.loadbalancer.class</name>

    <value>org.apache.phoenix.hbase.index.balancer.IndexLoadBalancer</value>

</property>

<property>

    <name>hbase.coprocessor.master.classes</name>

    <value>org.apache.phoenix.hbase.index.master.IndexMasterObserver</value>

</property
2、使用phoneix创建表、导入数据(数据量10W条)
https://www.cnblogs.com/yfb918/p/10895754.html
3、覆盖索引(Covered Indexes)
说明:只需要通过索引就能返回所要查询的数据,所以索引的列必须包含所需查询的列(select 的列和where的列)
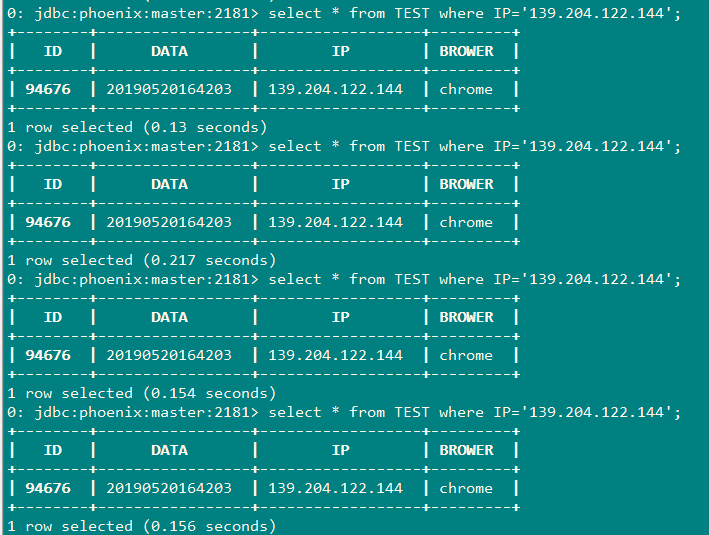
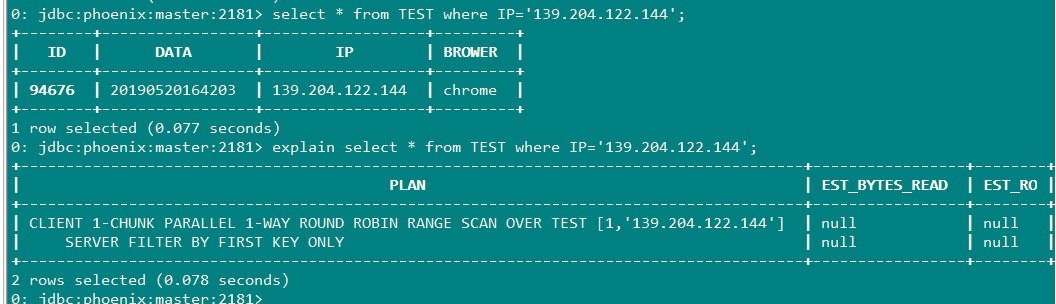
3.1不带索引的查询,查询ip='139.204.122.144'(普通查询)
由于数据量不大,经过多次查询,查询时间在0.13s-0.150s左右
3.1.1查询计划
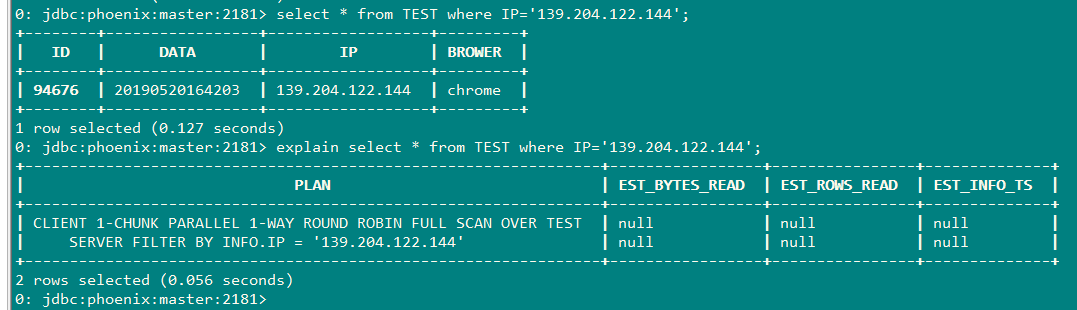
由图看出该执行过程线进行了full scan(全表扫描)再通过Filter(过滤器)进行筛选数据。
3.2创建基于ID的覆盖索引并绑定IP列上的数据
CREATE INDEX COVERINDEX ON TEST(ID) INCLUDE(IP)
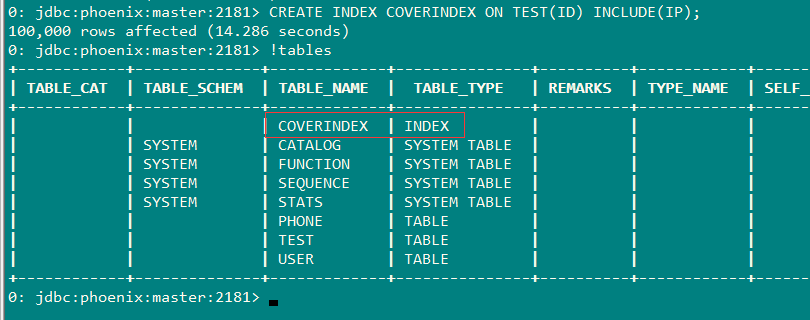
当我要通过ID来查询IP时就直接可以从索引上取回数据而无需先得到索引再去数据表中查询数据
查询语句:
说明:这里ID=''94676"正是上面IP=‘139.204.122.144’的该条数据
SElECT IP FROM TEST WHERE ID='94676';
经过多次查询:耗时在:0.016s-0.02s左右

3.2.1查询计划

3.3测试后删除索引

4、全局索引(Global Indexes)
全局索引适用于多读少写的场景,在写操作上会给性能带来极大的开销,因为所有的更新和写操作都会引起索引的更新,在读取数据时,Phoneix将通过索引表达式来快速查询结果。
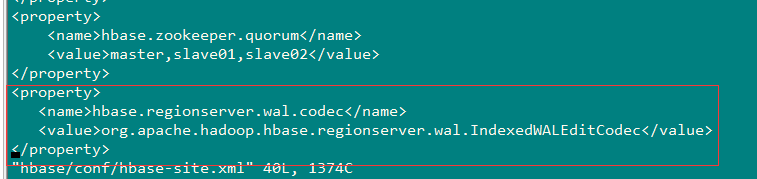
在使用全局索引之前需要在每个RegionServer上的hbase-site.xml添加如下属性:
<property>

   <name>hbase.regionserver.wal.codec</name>

   <value>org.apache.hadoop.hbase.regionserver.wal.IndexedWALEditCodec</value>

</property>
4.1这里在IP字段上创建索引
CREATE INDEX IPINDEX ON TEST(IP);

以下查询才会使用到索引
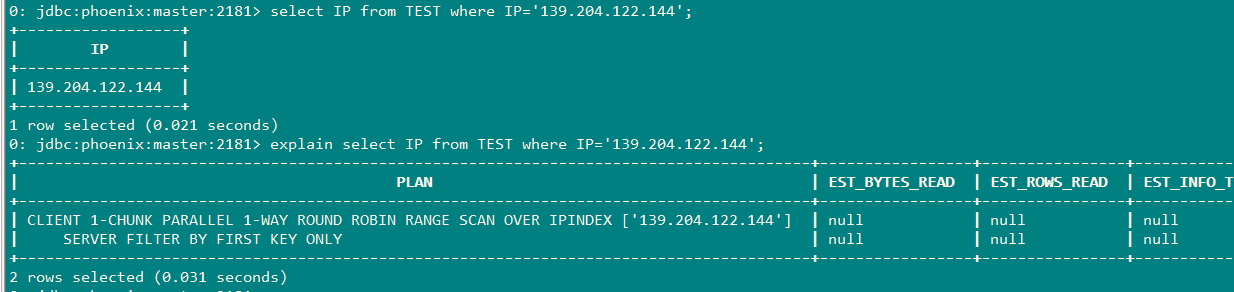
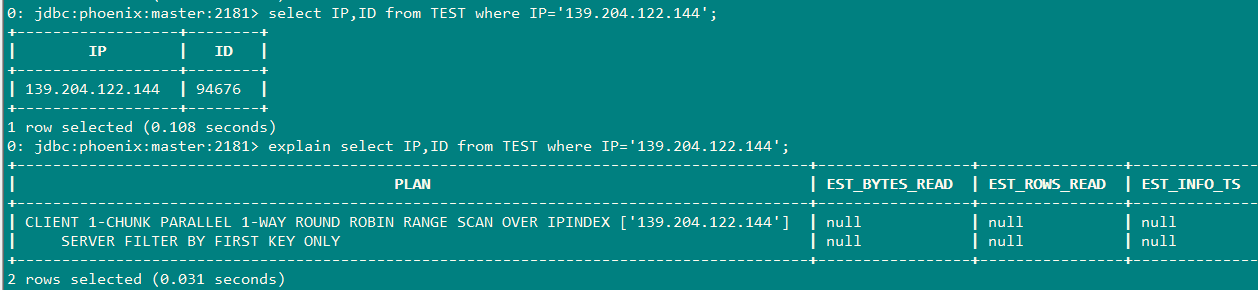
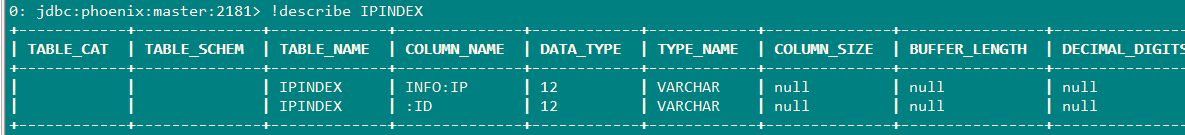
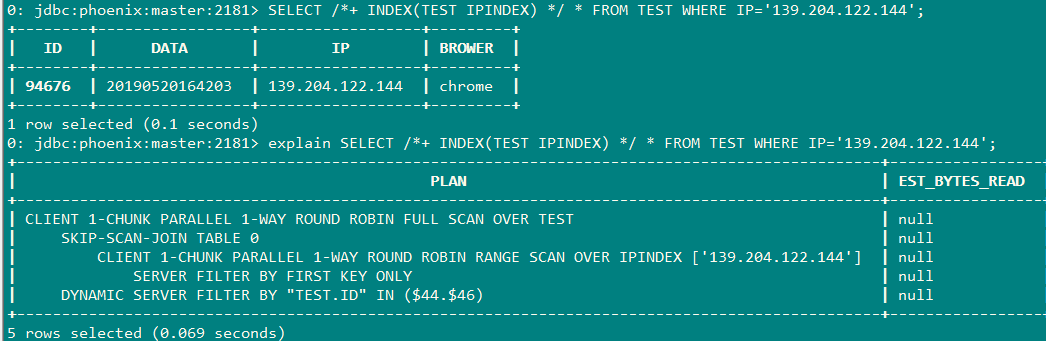
下面这个是采用强制索引的方式:
以下查询不会使用到索引
 语句一:
 select IP,BROWER from TEST where IP='139.204.122.144';
 虽然IP是索引字段,但是BROWER不是索引字段,所以不会使用到索引
 语句二:
 select BROWER from TEST where IP='139.204.122.144';
 BROWER不是索引字段,其他同理
但是使用以下几种方式,执行查询语句二时也将使用到索引
a、创建包含字段BROWER的覆盖索引
CREATE INDEX BROWERINDEX ON TEST(IP) INCLUDE(BROWER);
b、强制使用索引
 SELECT /*+ INDEX(INDEXIP,IPINDEX) */ IP FROM TEST WHERE IP='139.204.122.144';
 如果IP是索引字段,那么就会直接从索引表中查询
c、使用本地索引
CREATE LOCAL INDEX BROWERINDEX ON CSVTABLES(BROWER);
5、本地索引(Local indexes)
本地索引适用于写多读少,空间有限的场景,和全局索引一样,Phoneix在查询时会自动选择是否使用本地索引,使用本地索引,为避免进行写操作所带来的网络开销,索引数据和表数据都存放在相同的服务器中,当查询的字段不完全是索引字段时本地索引也会被使用,与全局索引不同的是,所有的本地索引都单独存储在同一张共享表中,由于无法预先确定Region的位置,所以在读取数据时会检查每个Region上的数据因而带来一定性能开销。
在使用本地索引之前需要在hbase master的hbase-site.xml上添加一下配置:
<property>

   <name>hbase.master.loadbalancer.class</name>

   <value>org.apache.phoenix.hbase.index.balancer.IndexLoadBalancer</value>

</property>

<property>

   <name>hbase.coprocessor.master.classes</name>

   <value>org.apache.phoenix.hbase.index.master.IndexMasterObserver</value>

</property>
创建本地索引
CREATE LOCAL INDEX IPINDEX ON TEST(IP);
查询
Phoneix(三)HBase集成Phoenix创建二级索引的更多相关文章
- phoenix连接hbase数据库,创建二级索引报错:Error: org.apache.phoenix.exception.PhoenixIOException: Failed after attempts=36, exceptions: Tue Mar 06 10:32:02 CST 2018, null, java.net.SocketTimeoutException: callTimeou
v\:* {behavior:url(#default#VML);} o\:* {behavior:url(#default#VML);} w\:* {behavior:url(#default#VM ...
- phoenix创建二级索引
create table user (id varchar primary key, firstname varchar, lastname varchar); create index user_i ...
- 通过phoenix在hbase上创建二级索引,Secondary Indexing
环境描述: 操作系统版本:CentOS release 6.5 (Final) 内核版本:2.6.32-431.el6.x86_64 phoenix版本:phoenix-4.10.0 hbase版本: ...
- 利用Phoenix为HBase创建二级索引
为什么需要Secondary Index 对于Hbase而言,如果想精确地定位到某行记录,唯一的办法是通过rowkey来查询.如果不通过rowkey来查找数据,就必须逐行地比较每一列的值,即全表扫瞄. ...
- hbase基于solr配置二级索引
一.概述 Hbase适用于大表的存储,通过单一的RowKey查询虽然能快速查询,但是对于复杂查询,尤其分页.查询总数等,实现方案浪费计算资源,所以可以针对hbase数据创建二级索引(Hbase Sec ...
- Phoneix(二)HBase集成Phoenix安装
一.软件下载 1.访问:http://phoenix.apache.org/ 2.点击: 3.进入以下内容:点击 4.跳转到 5.跳转到 6.点击安装包,进入 点击进行下载: 二.安装 phoneni ...
- phoenix中添加二级索引
Phoenix创建Hbase二级索引 官方文档 1. 配置Hbase支持Phoenix创建二级索引 1. 添加如下配置到Hbase的Hregionserver节点的hbase-site.xml ...
- 「从零单排HBase 12」HBase二级索引Phoenix使用与最佳实践
Phoenix是构建在HBase上的一个SQL层,能让我们用标准的JDBC APIs对HBase数据进行增删改查,构建二级索引.当然,开源产品嘛,自然需要注意“避坑”啦,阿丸会把使用方式和最佳实践都告 ...
- HBase学习(四) 二级索引 rowkey设计
HBase学习(四) 一.HBase的读写流程 画出架构 1.1 HBase读流程 Hbase读取数据的流程:1)是由客户端发起读取数据的请求,首先会与zookeeper建立连接2)从zookeepe ...
随机推荐
- PyQt(Python+Qt)学习随笔:窗口对象尺寸调整相关的函数resize、showMaximized、showNormal、showMinimized
resize(width,height) resize可以直接调整窗口的尺寸,调整效果类似于鼠标直接拉伸或缩小窗口,但窗口大小的最大值.最小值受窗口的sizePolicy.sizeHint.minim ...
- 【JAVA】SSM开源项目源码--城市学院移动后勤-毕业设计(Spring SpringMvc Mybatis Mui Redis )
项目简介 大学时期老师给我做的项目,学校后勤管理中心,也作为毕业设计项目. 有 后勤保修 二手交易 失物招领 后勤通知 等功能. 城市学院移动后勤 有APP端(webapp)和WEB端(PC) 后端使 ...
- edusrc上海交通大学证书
- 个人项目作业-Word Count
个人项目作业 1.Github地址 https://github.com/CLSgGhost/SE_work 2.项目相关需求 wc.exe 是一个常见的工具,它能统计文本文件的字符数.单词数和行数. ...
- 认识 Cargo-Rust构建工具和包管理器
认识 Cargo-Rust构建工具和包管理器 上两篇文章 都有说到 hello world 程序,但是我们如果使用自己创建文件的方式创建项目,一旦文件多了,那得多麻烦,整个项目将变得难以管理.下面我来 ...
- Tomcat 知识点总结
Tomcat 学习笔记.本文相关配置均为 tomcat8 下,其他版本可能略有不同.如有错误请多包涵. 架构 首先,看一下整个架构图 接下来简单解释一下. Server:服务器.Tomcat 就是一个 ...
- git-服务器搭建-协议概念
现在开发过程中,很多的实现某一些功能的工具,都是类似的服务器-客户端结构,即C-S架构,例如消息队列的KAFKA,文件存储的EasticSearch,包括我们日常工作中的数据库,他都是一种C-S架构, ...
- rpl_semi_sync_master_wait_no_slave 参数研究实验
最近在研究MySQL,刚学到半同步. 半同步的配置中,关于这两个参数: rpl_semi_sync_master_wait_no_slave rpl_semi_sync_master_wait_for ...
- vue单页面应用刷新网页后vuex的state数据丢失的解决办法
第一种方案 首先将数据保存在vuex的store中,同时将这些信息也保存在sessionStorage中.这里需要注意的是vuex中的变量是响应式的,而sessionStorage不是,当你改变vue ...
- Consul集成Envoy实践
单节点Consul集成Envoy进行安全服务通信 前言 Consul Service Mesh通过授权和加密来保护服务之间的通信,还可以拦截有关服务到服务通信的数据并将其呈现给监视工具.我们可以使 ...