
Spark小问题合集
1)在win7下使用spark shell运行spark程序,通过以下形式读取文件时
sc.sequenceFile[Int,String]("./sparkF")
偶尔会出现“Input path does not exist”,原因是没有使用“file:///”表示文件时本地文件系统上的文件,相对路径形式如下:
sc.sequenceFile[Int,String]("file:///.\\sparkF")
不过,还可以使用绝对路径,更保险些。
2)在Ubuntu上读取文件,貌似三种都可以。参考0
sc.sequenceFile[Int,String]("file:///home/hadoop/sparkF")

sc.sequenceFile[Int,String]("file://home/hadoop/sparkF")

sc.sequenceFile[Int,String]("file:/home/hadoop/sparkF")
3)可以使用println()打印某些变量值,然后在Exector对应的stdout可以看到打印的内容
4)有时候电脑IP没有固定的话,从教研室把电脑背回来,在IDEA上单机运行spark程序就失败了,提示如下:
ERROR NettyTransport: failed to bind to host.home/192.168.1.124:
“192.168.1.124”是在教研室的IP。出错的原因就是,创建sparkContext时,在“SparkEnv.scala”中,可以看到“spark.driver.host”对应值是:
192.1681.1.124//正好是教研室地址,与当前地址不同,自然报错
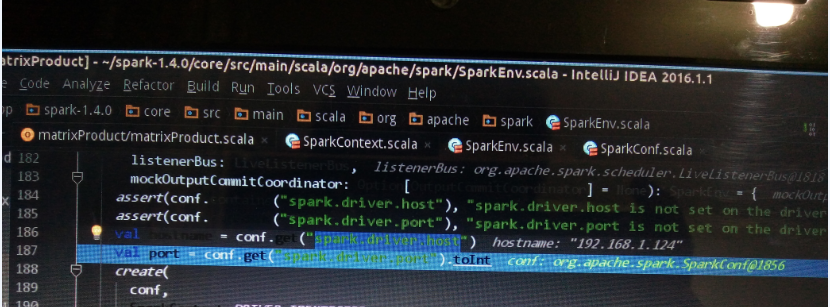
修改代码即可,原先代码如下:
val conf2=new SparkConf().setAppName("matrixProduct").setMaster(args())
修改后代码如下:
val conf2=new SparkConf().setAppName("matrixProduct").setMaster(args()).set("spark.local.ip","127.0.0.1")

      .set("spark.driver.host","127.0.0.1")
5)有时候运行spark作业会提示“WARN TaskSchedulerImpl: Initial job has not accepted any resources; check your cluster UI to ensure that workers are registered and have sufficient memory”,原因是申请的Exector内存比节点自身内存还要大。访问web界面中8080端口,看到每个节点的RAM是979MB,而提交作业时使用关键字 --executor-memory 1g,这样就超过了自身内存,所以报错。参考
6)使用IDEA调试spark程序时,在控制台窗口会打印出很多的“INFO,WARN”类信息,这些信息,我们并不需要,我们只需要打印出“ERROR”信息,解决方法如下:
1.首先生成spark_Home/conf中的“log4j.properties“文件,方法如下:
Even simpler you just cd SPARK_HOME/conf

then mv log4j.properties.template log4j.properties then open log4j.properties and change all INFO to ERROR.

 Here SPARK_HOME is the root directory of your spark installation.
其实生成了“log4j.properties”文件之后,当我们使用集群的方式运行spark程序时,就可以在控制台屏蔽掉那些”INFO“和”WARN“类的信息,但是如果是在IDEA本地调试spark程序时,”INFO“ ”WARN“类信息仍然会打印出来,解决方法参考以下方法
2.在完成了上述步骤之后,为了保证在IDEA中调试spark程序时避免打印”INFO“、”WARN“类信息,需要在spark程序在添加如下代码:
import org.apache.log4j.PropertyConfigurator

PropertyConfigurator.configure("path to log4j.properties")

sparkconf.set("log4j.configuration", "path to log4j.properties");
7)Spark下SequenceFile文件分片数量的确定
http://www.cnblogs.com/gaoze/p/5208970.html
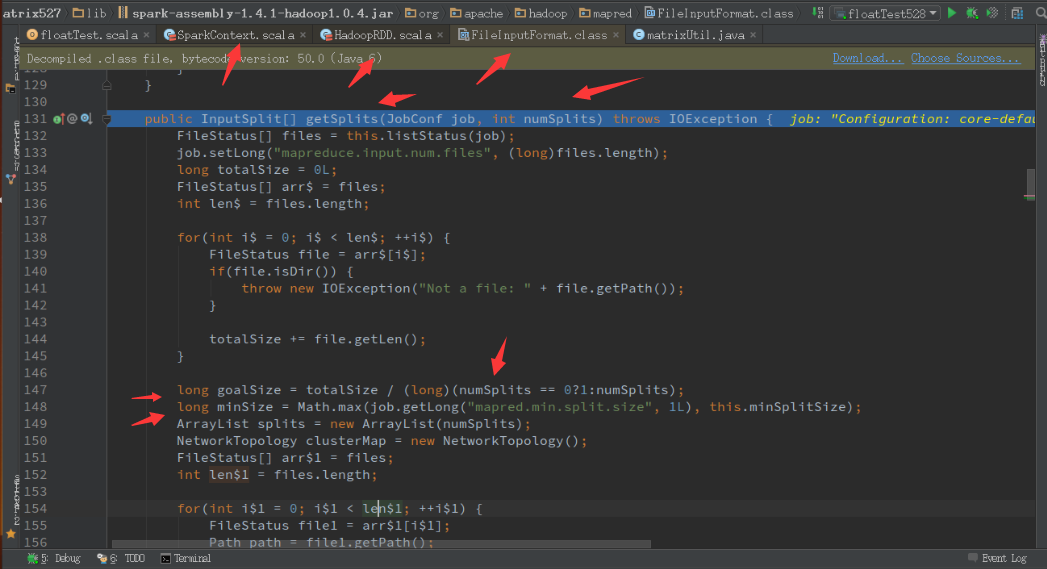
对于在spark中使用Sequence,其分片数量的计算方式与hadoop中相同,其实就是调用了hadoop中的实现来计算,计算goalSize,minSize,maxSize。如下图:
8)sortBy和sortByKey函数
http://www.iteblog.com/archives/1240
9)遍历了一次 Iterable 之后,再次遍历的时候,数据都没了
https://my.oschina.net/leejun2005/blog/131744
Spark小问题合集的更多相关文章
- html 小游戏合集(1.0)
最近做了个小游戏合集,有点沙雕,毕竟是1.0,将就看看. <!DOCTYPE html> <html> <head> <meta charset=" ...
- spark 入门教程合集
看到一篇不错的 spark 入门教程的合集,在此记录一下 http://www.cnblogs.com/shishanyuan/p/4699644.html
- js小功能合集:计算指定时间距今多久、评论树核心代码、字符串替换和去除。
1.计算指定时间距今多久 var date1=new Date('2017/02/08 17:00'); //开始时间 var date2=new Date(); //当前时间 var date3=d ...
- Vue-小demo、小效果 合集(更新中...)
(腾讯课堂学习小demo:https://ke.qq.com/course/256052) 一.简单的指令应用 --打击灭火器 图片素材点击腾讯课堂的链接获取 html: <!DOC ...
- 小tips合集
No. 1 同一个文本文件里的行结束符如果不一致,比如有些行结束符是0D0A-Windows风格的,而有些行又是UNIX风格的0A,在这种混杂情况下,VIM将非UNIX风格的显示为^M,但如果都是0D ...
- Android小项目合集(经典教程)包含十五个Android开发应用实例
http://www.cnblogs.com/aimeng/archive/2012/03/28/2422435.html
- 【前端学习笔记】JavaScript 小案例合集
获取一个0-9的随机数: Math.round(Math.random()*9); 去除数组中重复的元素: var arr=[1,3,5,4,3,3,1,4] function editArr(arr ...
- 常见Z纯CSS小样式合集(三角形)
三角形 .sanjiao{ width:0px; height: 0px; overflow: hidden; border-width: 100px; border-color: transpare ...
- Nginx小功能合集
13.1. 跨域处理 问题由来:浏览器拒绝执行其它域名下的ajax运作 ---如果浏览器在static.enjoy.com对应的html页面内,发起ajax请求偷盗www.enjoy.com域名下的内 ...
随机推荐
- 用静态工厂的方法实例化bean
//代码如下: package com.timo.domain; public class ClientService { //use static factory method create bea ...
- Math.abs为Integer.Min_VALUE返回错误的值
Math.abs为Integer.Min_VALUE返回错误的值 这段代码: System.out.println(Math.abs(Integer.MIN_VALUE)); 回报-2147483 ...
- Out of memory due to hash maps used in map-side aggregation解决办法
在运行一个group by的sql时,抛出以下错误信息: Task with the most failures(4): -----Task ID: task_201411191723_723592 ...
- LVM to increase and reduce 10G size for /data
=======================increase10G for/data=============================(system env /dev/MongoData00 ...
- windows mysql 安装及启动
0.下载:
- CentOS7 Tomcat 启动过程很慢,JVM上的随机数与熵池策略
1. CentOS7 Tomcat 启动过程很慢 在centos启动官方的tomcat时,启动过程很慢,需要几分钟,经过查看日志,发现耗时在这里:是session引起的随机数问题导致的: <co ...
- bzoj3790 manacher算法+贪心
紧跟jk大佬的步伐 这道题哇 因为机器一能生成回文串 所以我们只要用manacher跑一遍求出q[i]这样就把问题转化成了类似线段覆盖的题目 贪心就好了 至于,BIT优化dp我不会所以直接贪心了 注意 ...
- [bzoj2631]tree——lct
Brief Description 一棵n个点的树,每个点的初始权值为1.对于这棵树有q个操作,每个操作为以下四种操作之一: u v c:将u到v的路径上的点的权值都加上自然数c: u1 v1 u2 ...
- 在linux下搭建wiki环境【转】
转自:http://blog.csdn.net/chy800/article/details/6906090 由于公司需要一个知识共享的系统,选择wiki来实现.经过准备决定使用Linux+xampp ...
- springboot 整合springDataJPA
springboot 整合springDataJPA 〇.搭建springboot环境 一.添加依赖 mysql <!-- mysql驱动 --> <dependency> & ...