
jsoup爬虫简书首页数据做个小Demo
昨天LZ去面试,遇到一个大牛,被血虐一番,发现自己基础还是很薄弱,对java一些原理掌握的还是不够稳固,比如java反射注解,知道一点就是说不出来,很尴尬... 生命不止,学习不止啊
之前那个项目 QNews 用的是的第三方的数据平台,所以访问次数会有限制,这就很无奈。。。

每天只能请求100次....但是LZ这个穷屌丝也买不起服务器,所以就上网查,有什么别的方法可以获取数据,意外之间发现了jsoup这个强大的框架,就花了上午时间学习了一下,然后下午做了一个小Demo,功能比较单一,请见谅。
其实一开始的时候是想 爬今日头条的数据,但是发现数据总是为空,我估计是上锁了... 然后就把矛头转向了 简书,哈哈哈...果然简书就是好,数据直接就可以爬到了, 好开心啊!!
先演示一波动态图:

话说这个布局就花了我半个小时...
一些基础的我就不说了,就简单说明一下我的数据是如何爬到的。可以直接去看一下我的源码,写的比较仓促,一些细节没有处理好,多多指教。
1. 准备
1. 相关资料
2. 添加依赖
compile 'org.jsoup:jsoup:1.9.2'
3. 打开简书首页

在单个部分上 右击,然后点击检查选项(我用的是QQ浏览器,其他未尝试),底部就会跳出网页的源码,并且会跟踪到这个item对应的源码。
从上图可以大概了解到每个<li></li>标签里的内容就是我们每个item的信息。
2. 爬数据
1. 获取 Document 对象
	Document document = Jsoup.connect("http://www.jianshu.com/")

	                         .timeout(10000)

	                         .get();
这里通过建立与服务器的链接,并设置10s的超时连接来获取
Document对象
2. 获取跟标签的 Elements 对象

Elements noteList = document.select("ul.note-list");

Elements li = noteList.select("li");
找到文章列表模块,发现
<ul class="note-list></ul>是我们需要信息的跟标签。通过select方法查询节点所有信息。
for (Element element : li) {

	...

}
下面全部都是
li标签的列表,里面的内容大致相似,我们就可以通过循环来遍历里面的信息。
3. 获取每个部分所有信息
因为信息比较多,我就选择比较有代表性的来将一下。
有个非常简单的方式:直接在你需要获取内容的部分右击,点击 检查,就可以直接追踪到要查询的位置。

1. 标题
就拿标题而言,直接在标题右击-->检查,即可,一目了然。然后我把数据截图一下。

String title = element.select("a.title").text()
通过
select查询节点信息,然后.text获取里面文本内容。
2. 头像:

String avatar = element.select("a.avatar").select("img").attr("src")
这个就是先找到头像 节点,然后图片节点,最后通过
attr获取图片url
3. 首页链接

String authorLink = element.select("a.blue-link").attr("abs:href")
这里注意
href元素,他存放的就是跳转链接,不过是相对路径,这个时候就需要通过attr("abs:href")获取绝对路径。
其他 就 大同小异,其实我知道也就这么多,也是不断尝试通过打印得出来的,还是比较心酸的,比较没学过 js,不过对 js 挺有兴趣的。
3. 封装
剩下的就是将获取到的数据加载到bean对象中
1. 创建 bean 对象
public class JianshuBean {

    private String authorName;          // 作者

    private String authorLink;          // 作者链接

    private String time;                // 更新时间

    private String primaryImg;          // 主图

    private String avatarImg;           // 头像

    private String title;               // 标题

    private String titleLink;           // 标题链接

    private String content;             // 内容

    private String collectionTagLink;   // 专题链接

    private String readNum;             // 阅读量

    private String talkNum;             // 评论

    private String likeNum;             // 喜欢

    private String collectionTag;       // 专题

	// ... get set

}
2. 将获取到的数据添加到集合中
for (Element element : li) {

    JianshuBean bean = new JianshuBean();

    bean.setAuthorName(element.select("div.name").text()); // 作者姓名

    bean.setAuthorLink(element.select("a.blue-link").attr("abs:href")); // 作者首页链接

    bean.setTime(element.select("span.time").attr("data-shared-at"));   // 发表时间

    bean.setPrimaryImg(element.select("img").attr("src"));  // 主图

    bean.setAvatarImg(element.select("a.avatar").select("img").attr("src")); // 头像

    bean.setTitle(element.select("a.title").text());    // 标题

    bean.setTitleLink(element.select("a.title").attr("abs:href")); // 标题链接

    bean.setContent(element.select("p.abstract").text());       // 内容

    bean.setCollectionTagLink(element.select("a.collection-tag").attr("abs:href")); // 专题链接

    String[] text = element.select("div.meta").text().split(" ");

    if (text[0].matches("[0-9]+")) {

        bean.setReadNum(text[0]);

        bean.setTalkNum(text[1]);

        bean.setLikeNum(text[2]);

    } else {

        bean.setCollectionTag(text[0]);

        bean.setReadNum(text[1]);

        bean.setTalkNum(text[2]);

        bean.setLikeNum(text[3]);

    }

    mBeans.add(bean);

}
再来看一下效果:
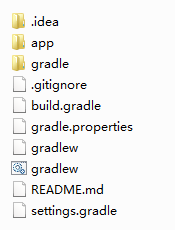
项目文件截图:
- 点击头像查看作者信息
- 点击图片或文字查看文章内容
- 点击专题查看专题内容
- 下拉刷新获取最新内容
希望大家多多支持我,谢谢!
jsoup爬虫简书首页数据做个小Demo
注:本文著作权归作者,由demo大师代发,拒绝转载,转载需要作者授权
jsoup爬虫简书首页数据做个小Demo的更多相关文章
- Node爬取简书首页文章
Node爬取简书首页文章 博主刚学node,打算写个爬虫练练手,这次的爬虫目标是简书的首页文章 流程分析 使用superagent发送http请求到服务端,获取HTML文本 用cheerio解析获得的 ...
- Python 2.7_多进程获取简书专题数据(一)
学python几个月了正好练练手,发现问题不断提高,先从专题入手,爬取些数据,一开始对简书网站结构不熟悉,抓取推荐,热门,城市3个导航栏,交流发现推荐和热门是排序不同,url会重复,以及每个专题详情页 ...
- [Unity3D]做个小Demo学习Input.touches
[Unity3D]做个小Demo学习Input.touches 学不如做,下面用一个简单的Demo展示的Input.touches各项字段,有图有真相. 本项目已发布到Github,地址在(https ...
- python爬虫 --- 简书评论
某些网站的一些数据是通过js加载的 ,所以爬取下来的数据拿不到, 找到评论的地址 .进行请求获取评论数据 #coding=utf-8 import json import requests def r ...
- 基于Angular和Spring WebFlux做个小Demo
前言 随着Spring Boot2.0正式发布,Spring WebFlux正式来到了Spring Boot大家族里面.由于Spring WebFlux可以通过更少的线程去实现更高的并发和使用更少的硬 ...
- pyqt5 做的小程序,可以用来UI做个小demo
#!/usr/bin/python3# -*- coding: utf-8 -*- """ZetCode PyQt5 tutorial This program crea ...
- python爬虫学习(8) —— 关于4399的一个小Demo
堂弟喜欢各种游戏,在没有网络的情况下,上4399显得很无力. 另外,4399广告好多,,而且加载慢.. 怎么办,,写个爬虫吧,,把4399上的"好玩"游戏爬下来. 1. 分析阶段 ...
- 简书全站爬取 mysql异步保存
# 简书网 # 数据保存在mysql中; 将selenium+chromedriver集成到scrapy; 整个网站数据爬取 # 抓取ajax数据 #爬虫文件 # -*- coding: utf-8 ...
- Python爬取简书主页信息
主要学习如何通过抓包工具分析简书的Ajax加载,有时间再写一个Multithread proxy spider提升效率. 1. 关键点: 使用单线程爬取,未登录,爬取简书主页Ajax加载的内容.主要有 ...
随机推荐
- (十)MySQL日志
1)日志种类 error log:错误日志 拍错 /var/log/mysqld.log \这是yum安装mysqld生成error默认目录 bin blog 二进制日志 备份 增量备份,记录DDL, ...
- BZOJ 3223: Tyvj 1729 文艺平衡树-Splay树(区间翻转)模板题
3223: Tyvj 1729 文艺平衡树 Time Limit: 10 Sec Memory Limit: 128 MBSubmit: 6881 Solved: 4213[Submit][Sta ...
- Codeforces 1059E. Split the Tree
题目:http://codeforces.com/problemset/problem/1059/E 用倍增可以在nlog内求出每个节点占用一个sequence 时最远可以向父节点延伸到的节点,对每个 ...
- Node 入门<1>
1. Node JavaScript web服务器框架,主要特点:事件驱动,异步 I/O,强制不共享任何资源的单线程,单进程系统. 每一个node进程都构成网络应用中的一个节点. ...
- 在MYSQL中插入当前时间,就象SQLSERVER的GETDATE()一样,以及对mysql中的时间日期操作。
在看sql教程的时候,我学的是mysql,但是教程上面的一点在mysql里面是不支持的,所以就找了其他的替代的办法 sql教程上面是这样的: 通过使用类似 GETDATE() 这样的函数,DEFAUL ...
- 5.5(java学习笔记)TreeSet和TreeMap
1.TreeMap TreeMap是可排序的Map类,使用这个类时,TreeMap会对存放的数据进行排序. 排序是根据key来排序的,排序规则是key实现comparable接口中的compareTo ...
- xcode编译项目Permission denied错误
打开终端,输入命令 sudo chmod -R 777 工作目录
- 数据访问与sql语句的管理(一)
在开发过程中数据访问是必不可少的.每个框架都会有自己数据访问机制.大家在一般的情况下会为自己的框架配备2套数据访问机制,ORM和DataHelper.当然,根据项目的需要有时候也可能只一种. 其实这2 ...
- 使用Ant项目打包
一.前沿 前段时间公司为了做一个新闻发布系统,就使用了开源的JEECMS系统,(非人类啊,泪~~~),项目不是maven构建的,项目的打包部署非常的麻烦,没办法只能使用Ant,Ant是比较古老的打包部 ...
- [Android Memory] Android 的 StrictMode
android的2.3 之后引入的StrictMode 对网络的访问做了限制啊. public void onCreate() { if (DEVELOPER_MODE) { StrictMode.s ...