
python实例:导入会员数据后,读取数据文件,检查导入正确性(整列取excel值、合并列、response取值)
场景描述:某系统新上线,老系统的会员数据要导入新系统中,包含手机号,上级信息和会员余额。有1万多条数据,手工对比过于繁琐,用python自动化处理
思路:系统导入数据后,脚本读取文件,先把会员数据取出来,合并成一个数列,然后传入查询函数,把查询结果和读取的数据进行比对,判断导入情况
数据文件内容如下图

系统查询接口信息如下:
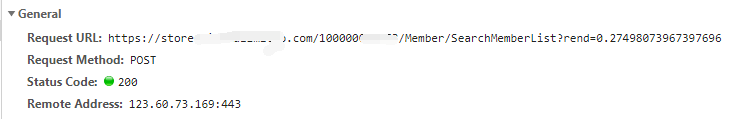
第一步,读取数据文件,合并成新的数列。这一部分脚本主要包含取excel中任意一列数据、循环读取列数据传到数列中、合并多个数列生成新数列
def phone():

    wb = xlrd.open_workbook(path+'\\2021.xlsx')# 打开Excel文件

    data = wb.sheet_by_name('sheet1')#通过excel表格名称(rank)获取工作表

    data_1=data.col_values(0)#获取第一列数据(数组)#查询号码

    data_2=data.col_values(1)#获取第二列数据(数组)#上级

    data_3=data.col_values(2)#获取第三列数据(数组)#余额

    list1=[]

    list2=[]

    list3=[]

    for i in data_1[1:10]:#循环读取列数据传到数列中,[1:10]代表只读取第2行到第10行数据

        list1.append(i)

    for h in data_2[1:10]:

        list2.append(h)

    for j in data_3[1:10]:

        list3.append(j)

    name_tulpe = list(zip(list1,list2,list3))#合并多个数列生成新数列

    return(name_tulpe)

code=phone()
打印输出结果

第二步,合并后的新数列传到请求函数中,逐一查询匹配结果。这一部分脚本主要用到数列的取值、数据拼接、request返回值json化后提取参数值
def data(params,headers,phone):

    for num in code:

        #分割数据,取出手机、上级、余额(数列的取值)

        手机 = int(num[0])

        上级 = str(num[1])

        余额 = str(num[2])

        print("查询" + '  ' + str(手机))

        print("导入上级"+'  '+上级)

        print("导入余额"+'  '+余额)

        #通过手机号查询上级(数据拼接)

        data = '{"PageIndex":1,"PageSize":10,"KeyWord":'+ str(手机) +',"MemberType":"","CardIds":[],"MinLastBuyDate":"","MaxLastBuyDate":"","TagIds":[],"MinPoints":"","MaxPoints":"","MinCreateDate":"","MaxCreateDate":"","SortName":"CreateTime","Sort":"Desc","Source":0,"topAgentId":-1,"CustomProvId":0,"WorkFriendType":0,"ConcernGzhType":0,"p":0.6919700775737443}'

        response = requests.post('https://storeapi.xxx.com/xxx/Member/SearchMemberList', headers=headers, params=params, data=data)

        response =  response.json()

        Id = response['Data']['DataList'][0]['Id']#客户id

        FirstTwitterName = response['Data']['DataList'][0]['FirstTwitterName']#上级昵称

        #通过id查询余额(request返回值json化)

        res = requests.get('https://storeapi.xxx.com/xxx/Member/FindMemberInfoById?Id='+str(Id), headers=headers)

        res = res.json()

        Balance = res['Data']['Balance']#余额(提取参数值)

        #打印上级和余额信息

        print("查询上级"+'  '+FirstTwitterName)

        print("查询余额"+'  '+str(Balance))

        #判断结果

        if 上级 == FirstTwitterName and str(Balance) == 余额:

            print("匹配成功")

        else:

            print("匹配失败")

        print("---------------")

data(params,headers,phone)
执行后的结果

有个问题,如果数据太多,第一步合并新数列会花费很多时间,这里还需要寻找更好的方案,或者用jmeter实现
全部脚本
# -*-coding:utf8-*-

# encoding:utf-8

import requests

import os

import sys

import xlrd

path = os.path.abspath(os.path.dirname(sys.argv[0]))

headers = {

    'authority': 'storeapi.xxxxx.com',

    'pragma': 'no-cache',

    'cache-control': 'no-cache',

    'access-control-request-method': 'POST',

    'origin': 'https://adminstore.xxxx.com',

    'user-agent': 'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/78.0.3904.108 Safari/537.36',

    'access-control-request-headers': 'authorization,content-type,req-host',

    'accept': 'application/json',

    'sec-fetch-site': 'same-site',

    'sec-fetch-mode': 'cors',

    'referer': 'https://adminstore.xxxx.com/',

    'accept-encoding': 'gzip, deflate, br',

    'accept-language': 'zh-CN,zh;q=0.9',

    'req-host': 'adminstore.smallmitao.com',

    'authorization': 'Bearer xxxx.xxxxx.eKlCnRt8PCC8qdfjS3rOuhAywaulFc3Ad2ujrmNo8uQ',

    'content-type': 'application/json; charset=utf-8',

}

params = (

    ('rend', '0.4068877130021684'),

)

#读取表格内的会员数据

def phone():

    wb = xlrd.open_workbook(path+'\\2021.xlsx')# 打开Excel文件

    data = wb.sheet_by_name('sheet1')#通过excel表格名称(rank)获取工作表

    data_1=data.col_values(0)#获取第一列数据(数组)#查询号码

    data_2=data.col_values(1)#获取第二列数据(数组)#上级

    data_3=data.col_values(2)#获取第三列数据(数组)#余额

    list1=[]

    list2=[]

    list3=[]

    for i in data_1[1:10]:#循环读取列数据传到数列中,[1:10]代表只读取第2行到第10行数据

        list1.append(i)

    for h in data_2[1:10]:

        list2.append(h)

    for j in data_3[1:10]:

        list3.append(j)

    name_tulpe = list(zip(list1,list2,list3))#合并多个数列生成新数列

    return(name_tulpe)

code=phone()

def data(params,headers,phone):

    for num in code:

        #分割数据,取出手机、上级、余额

        手机 = int(num[0])

        上级 = str(num[1])

        余额 = str(num[2])

        print("查询" + '  ' + str(手机))

        print("导入上级"+'  '+上级)

        print("导入余额"+'  '+余额)

        #通过手机号查询上级

        data = '{"PageIndex":1,"PageSize":10,"KeyWord":'+ str(手机) +',"MemberType":"","CardIds":[],"MinLastBuyDate":"","MaxLastBuyDate":"","TagIds":[],"MinPoints":"","MaxPoints":"","MinCreateDate":"","MaxCreateDate":"","SortName":"CreateTime","Sort":"Desc","Source":0,"topAgentId":-1,"CustomProvId":0,"WorkFriendType":0,"ConcernGzhType":0,"p":0.6919700775737443}'

        response = requests.post('https://storeapi.xxx.com/xxxx/Member/SearchMemberList', headers=headers, params=params, data=data)

        response =  response.json()

        Id = response['Data']['DataList'][0]['Id']#客户id

        FirstTwitterName = response['Data']['DataList'][0]['FirstTwitterName']#上级昵称

        #通过id查询余额

        res = requests.get('https://storeapi.xxxx.com/xxxx/Member/FindMemberInfoById?Id='+str(Id), headers=headers)

        res = res.json()

        Balance = res['Data']['Balance']#余额

        #打印上级和余额信息

        print("查询上级"+'  '+FirstTwitterName)

        print("查询余额"+'  '+str(Balance))

        #判断结果

        if 上级 == FirstTwitterName and str(Balance) == 余额:

            print("匹配成功")

        else:

            print("匹配失败")

        print("---------------")

data(params,headers,phone)
python实例:导入会员数据后,读取数据文件,检查导入正确性(整列取excel值、合并列、response取值)的更多相关文章
- 【Python实例一】使用minidom读取xml文件
前言:最近刚在廖雪峰老师的网站里学习了Python的基础内容,想着循序渐进地找点实例练练手,网上看到有很多相关资料,决定针对感兴趣的内容实际编码实践一下,昨天刚好看到有关使用Python来读取XML文 ...
- 其它课程中的python---5、Pandas处理数据和读取数据
其它课程中的python---5.Pandas处理数据和读取数据 一.总结 一句话总结: 记常用和特例:慢慢慢慢的就熟了,不用太着急,慢慢来 库的使用都很简单:就是库的常用函数就这几个,后面用的时候学 ...
- shell脚本实现读取一个文件中的某一列,并进行循环处理
shell脚本实现读取一个文件中的某一列,并进行循环处理 1) for循环 #!bin/bash if [ ! -f "userlist.txt" ]; then echo &qu ...
- python 数据可视化 -- 读取数据
从 CSV 文件中读取数据(CSV) import sys import csv # python 内置该模块 支持各种CSV文件 file_name = r"..\ch02_data\ch ...
- CSV文件导入到数据库中读取数据详解(接着上个帖子)
一.controller层 二.SERVICE层 @Overridepublic Result importJinjiangAssessResult(MultipartFile file) throw ...
- Python从MongoDB中按天读取数据并格式化日志
#$cat SpeechMongoHandle.py from pymongo import Connection import time import datetime # CTRL_A='\x01 ...
- Vue导出模板、使用前端js办法导出表格数据、导入表格前端读取表格数据、导入表格发送后端读取数据
以下是几种用的较多的函数方法,可以参考使用. // 導出1 myExport() { // post請求文件寫法1 const url = 'http://XXXX/XXXX/XXXX/XXXX' c ...
- Python学习笔记_从CSV读取数据写入Excel文件中
本示例特点: 1.读取CSV,写入Excel 2.读取CSV里具体行.具体列,具体行列的值 一.系统环境 1. OS:Win10 64位英文版 2. Python 3.7 3. 使用第三方库:csv. ...
- Oracle 删除数据后释放数据文件所占磁盘空间
测试的时候向数据库中插入了大量的数据,测试完成后删除了测试用户以及其全部数据,但是数据文件却没有缩小.经查阅资料之后发现这是 Oracle “高水位”所致,那么怎么把这些数据文件的大小降下来呢?解决办 ...
- 万水千山ABP - 单租户时,成功保存数据后,数据不显示
问题描述: ABP 禁用了多租户,在编辑一个实体记录后,能成功地保存数据,但数据列表中看不到这条记录.打开数据表查看,发现该实体记录的 TenantId 字段值成了 Null , 而不是预期的默认租户 ...
随机推荐
- 用脚本采用wget方式直接下载谷歌云盘里面的文件实操
今天在工作中遇到了一个挑战,在这里和大家分享一下我的解决过程.突然接到一个紧急需求,需要在服务器上部署一个模型文件,而这个文件存储在谷歌云盘里.摆在面前有两个选择: 方案一:先在本地下载,然后再上传到 ...
- DeepSeek模型技术动态引行业关注,企业生产系统API迁移需审慎评估
在当今数字化浪潮中,人工智能技术迅猛发展,各类模型如雨后春笋般涌现,而 DeepSeek 模型凭借其独特的优势,在人工智能领域迅速崭露头角,成为备受瞩目的新星. DeepSeek 模型由杭州深度求索人 ...
- RabbitMQ(一)——简介
RabbitMQ系列 RabbitMQ(一)--简介 RabbitMQ(二)--模式类型 RabbitMQ(三)--简单模式 RabbitMQ(四)--工作队列模式 RabbitMQ(五)--发布订阅 ...
- 使用 Git 命令和 Github 前须了解的知识
本文不包括 Git 命令的介绍与使用,只分享 Git 的关键概念与 Github 项目的基本工作流程.作者相信先了解它们对后续的学习和工作大有裨益.(如有错误和建议请大家评论告知) 版本控制系统 VC ...
- ((GPIO_TypeDef ) GPIOB_BASE)或((GPIO_TypeDef ) xxxx)
///////////////((GPIO_TypeDef ) GPIOB_BASE)或((GPIO_TypeDef ) xxxx)//////////////////// #define GPIOA ...
- spring-boot配置slf4j日志
SLF4J,即简单日志门面(Simple Logging Facade for Java),不是具体的日志解决方案,它只服务于各种各样的日志系统.按照官方的说法,SLF4J 是一个用于日志系统的简单 ...
- QQ/微信域名防红方法,打开网站跳转浏览器打开
简单通用QQ/微信跳转浏览器打开代码 使用方法: 将代码全部复制 粘贴到 网站根目录下index.php文件的顶端 注意:不要覆盖了 index.php里面的原代码,原代码保留(请尽快把样式以及图片本 ...
- ABC393F题解
大概评级:绿. 一看到这种题目,就知道肯定是数据结构题,我们首先用一个众所周知的二分来求出 \(pos\) 数组,\(pos_i\) 表示以 \(i\) 结尾的最长上升子序列的大小,然后将询问离线,弄 ...
- AI与.NET技术实操系列 - 开篇
引言 在当今技术飞速发展的时代,人工智能(Artificial Intelligence, AI)已成为推动创新和变革的核心力量.从智能助手到自动化决策系统,AI的应用无处不在,深刻影响着我们的生活和 ...
- typora编辑数学公式
最后,需要补充两点: 1.如果要导出为docx,需要安装pandoc https://github.com/jgm/pandoc/releases/tag/3.6.3 2.如果要自己写代码,比如输入\ ...