
G1垃圾收集器深度理论讲解【纯理论】
在上三次中对于G1官方解读之后,接下来还得回到G1的理论化知识的了解阶段。。确实G1是概念比较复杂,而且它也是未来JDK的垃圾回收的主流,所以花再多的时间在这上面也是值得的,先来回顾一下上次过过的理论在哪打止了:https://www.cnblogs.com/webor2006/p/11129572.html
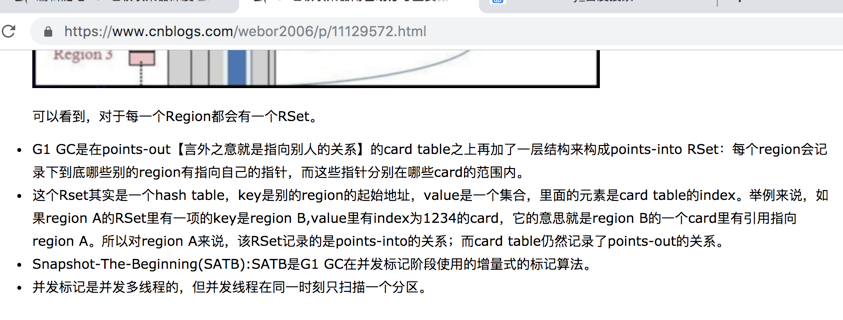
下面继续:
G1相对于CMS的的优势:
- G1在压缩空间方面有优势。
对于CMS是采用标记清除算法,不带压缩功能的,所以肯定会有内存碎片的产生,而G1采用的是拷贝复制算法,所以肯定不会产生内存碎片问题,所以压缩起来空间利用率也大大提升了。 - G1通过将内存空间分成区域(Region)的方式避免内存碎片问题。
- Eden、Survivor、Old区不再固定,在内存使用率上来说更灵活。
因为G1的Eden、Survivor、Old的个数是可以动态伸缩的,而不像CMS,这些区域就已经定好大小了不能被调整。 - G1可以通过设置预期停顿时间(Pause Time)来控制垃圾收集时间,避免应用雪崩现象。
- G1在回收内存后会马上同时做合并空闲内存的工作,而CMS默认是在STW(stop the world)的时候做。
- G1会在Young GC中使用,而CMS只能在Old区使用。
G1的适合场景:
- 服务端多核CPU、JVM内存占用较大的应用。
- 应用在运行过程中会产生大量内存碎片、需要经常压缩空间。
- 想要更可控、可预期的GC停顿周期;防止高并发下应用的雪崩现象。
G1 GC模式:
- G1提供了两种GC模式,Young GC和Mixed GC,两种都是完全Stop The World的。
- Young GC:选定所有年轻代里的Region。通过控制年轻代的Region个数,既年轻代内存大小,来控制Young GC的时间开销。
- Mixed GC:选定所有年轻代里的Region,外加根据global concurrent marking【在之后有单独介绍】统计得出收集收益高的若干老年代Region。在用户指定的开销目标范围内尽可能选择收益高的老年代Region。
- Mixed GC不是Full GC,它只能回收部分老年代的Region,如果Mixed GC实在无法跟上程序分配内存的速度,导致老年代填满无法继续进行Mixed GC,就会使用serial old GC(Full GC)来收集整个GC heap。所以本质上,G1是不提供Full GC的。
global concurrent marking:
- global concurrent marking的执行过程类似于CMS,但是不同的是,在G1 GC中,它主要是为Mixed GC提供标记服务的,并不是一次GC过程的一个必须环节。
- global concurrent marking的执行过程分为四个步骤。
- 初始标记(inital mark,STW):它标记了从GC Root开始直接可达的对象。
- 并发标记(Concurrent Marking):这个阶段从GC Root开始对heap中的对象进行标记,标记线程与应用程序线程并发执行,并且收集各个Region的存活对象信息。
- 重新标记(Remark,STW):标记那些在并发标记阶段发生变化的对象,将被回收。
- 清理(Cleanup):清除空Region(没有存活对象的),加入到free list。
- 第一阶段inital mark是共用了Young GC的暂停,这是因为他们可以复用root scan操作,所以可以说global concurrent marking是伴随Young GC而发生的。
- 第四阶段Cleanup只是回收了没有存活对象的Region,所以它并不需要STW。
G1在运行过程中的主要模式:
- YGC(不同于CMS)
- 并发阶段
- 混合模式
- Full GC(一般是G1出现问题时发生)
- G1 YGC在Eden充满时触发,在回收之后所有之前属于Eden的区域全部变成空白,既不属于任何一个分区(Eden、Survivor、Old)。
Mixed GC:
- 什么时候发生Mixed GC?
- 由一些参数控制,另外也控制着哪些老年代Region会被选入CSet(收集集合)。
- G1HeapWastePercent:在global concurrent marking结束之后,我们可以知道old gen regions中有多少空间要被回收,在每次YGC之后和再次发生Mixed GC之前,会检查垃圾占比是否达到此参数,只有达到了,下次才会发生Mixed GC。
- G1MixedGCLiveThresholdPercent:old generation region中的存活对象的占比,只有在此参数之下,才会被选入CSet。
- G1MixedGCCountTarget:一次global concurrent marking之后,最多执行Mixed GC的次数。
- G1OldCSetRegionThresholdPercent:一次Mixed GC中能被选入CSet的最多old generation region数量。
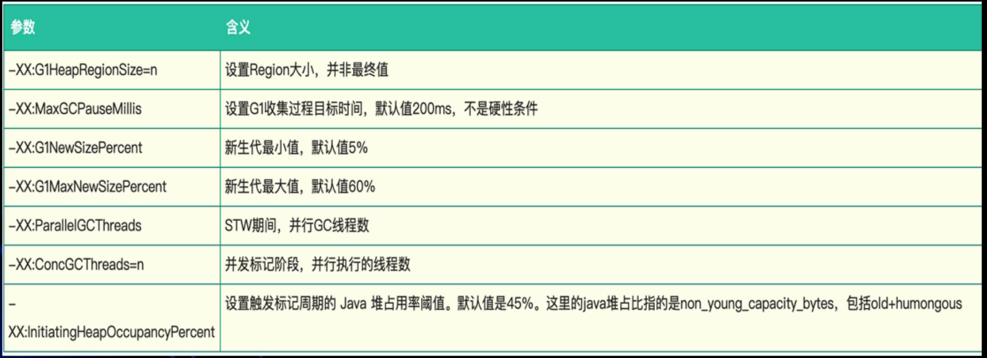
G1 GC其他参数:
G1垃圾收集器深度理论讲解【纯理论】的更多相关文章
- G1垃圾收集器设计目标与改良手段【纯理论】
在之前已经详细对CMS垃圾回收器进行了学习,今天准备要学习另一个全新的垃圾收集器---G1(Garbage First Collector 垃圾优先的收集器),说是一种全新的,其实G1垃圾收集器已经出 ...
- G1垃圾收集器系统化说明【官方解读】
还是继续G1官网解读,上一次已经将这三节的东东读完了,如下: 所以接一来则继续往下读: Reviewing Generational GC and CMS[回顾一下CMS收集器] The Concur ...
- 深入理解 Java G1 垃圾收集器--转
原文地址:http://blog.jobbole.com/109170/?utm_source=hao.jobbole.com&utm_medium=relatedArticle 本文首先简单 ...
- G1 垃圾收集器
概念先知 什么是垃圾回收 简单的说垃圾回收就是回收内存中不再使用的对象. 垃圾回收的基本步骤: 查找内存中不再使用的对象 释放这些对象占用的内存 查找内存中不再使用的对象 如何判断哪些对象不再被使用呢 ...
- G1垃圾收集器和CMS垃圾收集器 (http://mm.fancymore.com/reading/G1-CMS%E5%9E%83%E5%9C%BE%E7%AE%97%E6%B3%95.html#toc_8)
参考来源 JVM 体系架构 堆/栈的内存分配 静态和非静态方法的内存分配 CMS 回收算法 应用场景 CMS 垃圾收集阶段划分(Collection Phases) CMS什么时候启动 CMS缺点 G ...
- 【JVM】7、深入理解Java G1垃圾收集器
本文首先简单介绍了垃圾收集的常见方式,然后再分析了G1收集器的收集原理,相比其他垃圾收集器的优势,最后给出了一些调优实践. 一,什么是垃圾回收 首先,在了解G1之前,我们需要清楚的知道,垃圾回收是什么 ...
- G1 垃圾收集器入门
最近在复习Java GC,因为G1比较新,JDK1.7才正式引入,比较艰难的找到一篇写的很棒的文章,粘过来mark下.总结这篇文章和其他的资料,G1可以基本稳定在0.5s到1s左右的延迟,但是并不能保 ...
- 转 G1垃圾收集器入门
转自:http://blog.csdn.net/zhanggang807/article/details/45956325 最近在复习Java GC,因为G1比较新,JDK1.7才正式引入,比较艰难的 ...
- G1垃圾收集器的实现原理
(G1垃圾收集器的实现原理.G1和CMS经常被单独拎出来问) https://tech.meituan.com/g1.html G1太复杂,说下CMS吧
随机推荐
- CentOS8安装docker
参考:https://www.cnblogs.com/ding2016/p/11592999.html 一,安装环境查看 二,下载docker-ce的repo curl https://downloa ...
- linux 大量time_wait的解决方法
通过调整内核参数解决vi /etc/sysctl.conf 编辑文件,加入以下内容:net.ipv4.tcp_syncookies = 1net.ipv4.tcp_tw_reuse = 1net.ip ...
- Eureka&Zookeeper&Consul 原理与对比
CAP 定理CAP定理:CAP定理又称CAP原则,指的是在一个分布式系统中,一致性(Consistency).可用性(Availability).分区容错性(Partition tolerance). ...
- linu SSH 不在同一网段的两台机器如何通过ssh通信,SSH限制特定网段登陆的方法
1. linu SSH 不在同一网段的两台机器如何通过ssh通信 https://blog.csdn.net/lhf19891003/article/details/39895763 https:// ...
- Apache Flink SQL
本篇核心目标是让大家概要了解一个完整的 Apache Flink SQL Job 的组成部分,以及 Apache Flink SQL 所提供的核心算子的语义,最后会应用 TumbleWindow 编写 ...
- LeetCode 1022. 从根到叶的二进制数之和(Sum of Root To Leaf Binary Numbers)
1022. 从根到叶的二进制数之和 1022. Sum of Root To Leaf Binary Numbers 题目描述 Given a binary tree, each node has v ...
- Quartz.Net—JobBuilder
JobBuilder JobBuilder是一个建造者模式,链式建造.通过静态方法构建一个JobBuilder实例,然后再调用类方法Build()创建一个IJobDetail的实现. 1.静态方法 p ...
- [ERROR] /D:/IDEA文件/travel/src/main/java/cn/itcast/travel/util/MailUtils.java:[1,1] 非法字符: '\ufeff'
报错: [ERROR] Failed to execute goal org.apache.maven.plugins:maven-compiler-plugin:3.1:compile (defau ...
- Django开发常用方法及面试题
目录 1.对Django的认识? 2.Django .Flask.Tornado的对比 3.什么是wsgi,uwsgi,uWSGI? 4. django请求的生命周期? 5. 简述什么是FBV和CBV ...
- 网页修改<title ></title >标签内容
document.title = 'xxxxxx';