
CHD-5.3.6集群安装
我是基于Apache-hadoop2.7.3版本安装成功后,已有的环境进行安装chd-5..6
已用的环境:
JDK版本:
java version "1.8.0_191"

Java(TM) SE Runtime Environment (build 1.8.0_191-b12)

Java HotSpot(TM) -Bit Server VM (build 25.191-b12, mixed mode)
三台机器已经免秘钥:
192.168.1.30 master

192.168.1.40 saver1

192.168.1.50 saver2
现有的安装包:
cdh5.3.6-snappy-lib-natirve.tar.gz

hadoop-2.5.-cdh5.3.6.tar.gz

hive-0.13.-cdh5.3.6.tar.gz

sqoop-1.4.-cdh5.3.6.tar.gz
开始安装:
1.上传上面的四个安装包到soft 目录
2.赋权
[hadoop@master soft]$ chmod *
3.解压到指定目录
[hadoop@master soft]$ tar -xvf hadoop-2.5.-cdh5.3.6.tar.gz -C /home/hadoop/CDH5.3.6

tar -xvf hive-0.13.-cdh5.3.6.tar.gz -C /home/hadoop/CDH5.3.6
4.配置hadoop-env.sh
export JAVA_HOME=/usr/local/jdk1.
5.配置mapred-env.sh
export JAVA_HOME=/usr/local/jdk1.
6.配置core-sit.xml
<configuration>

        <!-- 指定hdfs的nameservice为ns1 -->

        <property>

          <name>fs.defaultFS</name>

          <value>hdfs://192.168.1.30:9000</value>

        </property>

        <!-- Size of read/write buffer used in SequenceFiles. -->

        <property>

          <name>io.file.buffer.size</name>

                <value></value>

                </property>

        <!-- 指定hadoop临时目录,自行创建 -->

        <property>

                <name>hadoop.tmp.dir</name>

                <value>//home/hadoop/CDH5.3.6/hadoop-2.5.0-cdh5.3.6/data/tmp</value>

        </property>

<property>

  <name>hadoop.proxyuser.hadoop.groups</name>

    <value>*</value>

    </property>

    <property>

      <name>hadoop.proxyuser.hadoop.hosts</name>

        <value>*</value>

        </property>

</configuration>
7.配置hdfs-site.xml
<configuration>

     <property>

       <name>dfs.namenode.secondary.http-address</name>

       <value>192.168.1.30:</value>

     </property>

     <property>

         <name>dfs.replication</name>

         <value></value>

     </property>

     <property>

       <name>dfs.namenode.name.dir</name>

       <value>file:/home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/hdfs/name</value>

     </property>

     <property>

        <name>dfs.datanode.data.dir</name>

        <value>file:/home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/hdfs/data</value>

    </property>

    <property>

      <name>dfs.webhdfs.enabled</name>

      <value>true</value>

     </property>

 </configuration>
8.配置slaves
master

saver1

saver2
9.拷贝到其他节点
scp -r /home/hadoop/CDH5.3.6 hadoop@saver1:/home/hadoop/

scp -r /home/hadoop/CDH5.3.6 hadoop@saver2:/home/hadoop/
10.格式化hadoop
[hadoop@master hadoop-2.5.-cdh5.3.6]$ bin/hdfs namenode -format
出现错误:
Error: Could not find or load main class org.apache.hadoop.hdfs.server.namenode.NameNode
解决方法:
因为没有HADOOP_HOME/share/hadoop/hdfs/× 这个路径,所以我在hadoop-XX\libexec\hadoop-config.sh最后自己加上
## 因为它的classpath中没有hdfs的路径,所以手动添加
CLASSPATH=${CLASSPATH}:$HADOOP_HDFS_HOME'/share/hadoop/hdfs/*'
成功格式化:
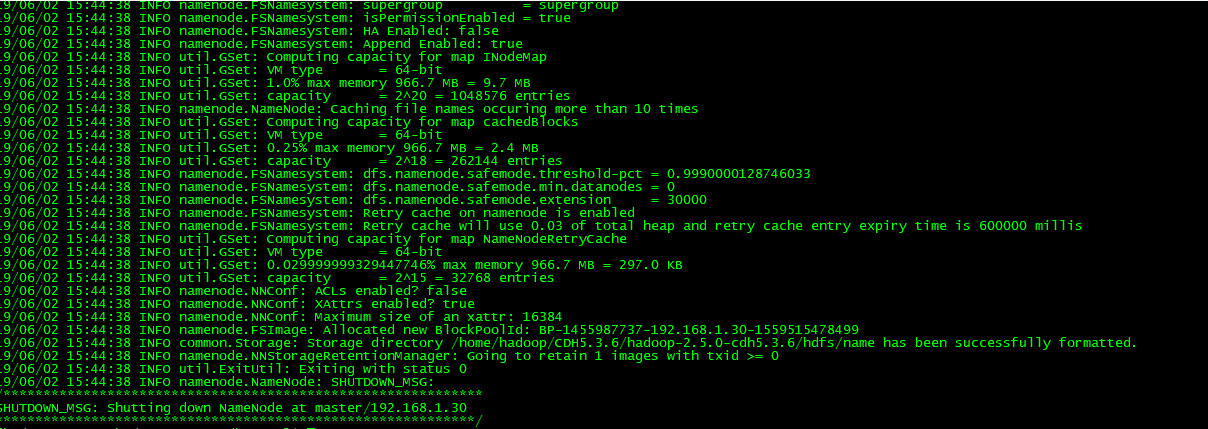
11.配置yarn-site.xml
<configuration>

  <property>

      <name>yarn.nodemanager.aux-services</name>

      <value>mapreduce_shuffle</value>

  </property>

  <property>

       <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name>

       <value>org.apache.hadoop.mapred.ShuffleHandler</value>

  </property>

  <property>

      <name>yarn.resourcemanager.address</name>

      <value>192.168.1.30:</value>

   </property>

   <property>

      <name>yarn.resourcemanager.scheduler.address</name>

      <value>192.168.1.30:</value>

    </property>

    <property>

       <name>yarn.resourcemanager.resource-tracker.address</name>

       <value>192.168.1.30:</value>

    </property>

    <property>

         <name>yarn.resourcemanager.admin.address</name>

         <value>192.168.1.30:</value>

   </property>

    <property>

        <name>yarn.resourcemanager.webapp.address</name>

        <value>192.168.1.30:</value>

    </property>

</configuration>
12.配置mapred-site.xml
<configuration>

        <property>

          <name>mapreduce.framework.name</name>

           <value>yarn</value>

         </property>

         <property>

             <name>mapreduce.jobhistory.address</name>

             <value>192.168.1.30:</value>

          </property>

        <property>

           <name>mapreduce.jobhistory.webapp.address</name>

           <value>192.168.1.30:</value>

        </property>

</configuration>
13,重启系统
14.启动服务:
[hadoop@master hadoop-2.5.-cdh5.3.6]$ sbin/hadoop-daemon.sh start namenode

starting namenode, logging to /home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/logs/hadoop-hadoop-namenode-master.out

[hadoop@master hadoop-2.5.-cdh5.3.6]$ sbin/hadoop-daemon.sh start datanode

starting datanode, logging to /home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/logs/hadoop-hadoop-datanode-master.out

[hadoop@master hadoop-2.5.-cdh5.3.6]$ sbin/yarn-daemon.sh start resourcemanager

starting resourcemanager, logging to /home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/logs/yarn-hadoop-resourcemanager-master.out

[hadoop@master hadoop-2.5.-cdh5.3.6]$ sbin/yarn-daemon.sh start nodemanager

starting nodemanager, logging to /home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/logs/yarn-hadoop-nodemanager-master.out

[hadoop@master hadoop-2.5.-cdh5.3.6]$ sbin/mr-jobhistory-daemon.sh start historyserver

starting historyserver, logging to /home/hadoop/CDH5.3.6/hadoop-2.5.-cdh5.3.6/logs/mapred-hadoop-historyserver-master.out
15.查看服务
[hadoop@master hadoop-2.5.-cdh5.3.6]$ jps

 NodeManager

 JobHistoryServer

 Jps

 DataNode

 ResourceManager

 NameNode
CHD-5.3.6集群安装的更多相关文章
- 【Oracle 集群】Oracle 11G RAC教程之集群安装(七)
Oracle 11G RAC集群安装(七) 概述:写下本文档的初衷和动力,来源于上篇的<oracle基本操作手册>.oracle基本操作手册是作者研一假期对oracle基础知识学习的汇总. ...
- kafka集群安装部署
kafka集群安装 使用的版本 系统:centos6.5 centos6.7 jdk:1.7.0_79 zookeeper:3.4.9 kafka:2.10-0.10.1.0 一.环境准备[只列,不具 ...
- CentOS下Hadoop-2.2.0集群安装配置
对于一个刚开始学习Spark的人来说,当然首先需要把环境搭建好,再跑几个例子,目前比较流行的部署是Spark On Yarn,作为新手,我觉得有必要走一遍Hadoop的集群安装配置,而不仅仅停留在本地 ...
- Hadoop多节点集群安装配置
目录: 1.集群部署介绍 1.1 Hadoop简介 1.2 环境说明 1.3 环境配置 1.4 所需软件 2.SSH无密码验证配置 2.1 SSH基本原理和用法 2.2 配置Master无密码登录所有 ...
- codis集群安装
在网上找了很多codis的集群安装方法,看起来都是大同小异,本人结合了大多种方法完成了一套自己使用的codis的集群安装,可以供大家学习使用,如果有什么问题或者不懂的地方欢迎指正 1.集群规划: 三台 ...
- [bigdata] spark集群安装及测试
在spark安装之前,应该已经安装了hadoop原生版或者cdh,因为spark基本要基于hdfs来进行计算. 1. 下载 spark: http://mirrors.cnnic.cn/apache ...
- (原) 1.2 Zookeeper伪集群安装
本文为原创文章,转载请注明出处,谢谢 Zookeeper伪集群安装 zookeeper单机安装配置可以查看 1.1 zookeeper单机安装 1.复制三份zookeeper,分别为zookeeper ...
- 一步步教你Hadoop多节点集群安装配置
1.集群部署介绍 1.1 Hadoop简介 Hadoop是Apache软件基金会旗下的一个开源分布式计算平台.以Hadoop分布式文件系统HDFS(Hadoop Distributed Filesys ...
- kafka 集群安装与安装测试
一.集群安装 1. Kafka下载:wget https://archive.apache.org/dist/kafka/0.8.1/kafka_2.9.2-0.8.1.tgz 解压 tar zxvf ...
- k8s入门系列之集群安装篇
关于kubernetes组件的详解介绍,请阅读上一篇文章<k8s入门系列之介绍篇> Kubernetes集群安装部署 •Kubernetes集群组件: - etcd 一个高可用的K/V键值 ...
随机推荐
- Git Command之Code Review
原文链接 准备 Step 1. Create a team and add a teammate Step 2. Create a repository with some content 应用 Cl ...
- 阶段5 3.微服务项目【学成在线】_day05 消息中间件RabbitMQ_2.RabbitMQ研究-RabbitMQ介绍
开发中消息队列通常有如下应用场景: 1.任务异步处理. 将不需要同步处理的并且耗时长的操作由消息队列通知消息接收方进行异步处理.提高了应用程序的响应时间. 2.应用程序解耦合 MQ相当于一个中介,生产 ...
- BSD process name correspondlng to current thread: knernel_task Mac OS version Not yet set
网上查了一大堆,没有一个靠谱的, 百度,以说黑苹果装系统最容易出现这个,这个让我开始怀疑公司给我们的所谓外观的iMac是黑苹果了,因为一直很卡,比上家公司的真黑苹果还卡. 谷歌,有说重置BIOS电池的 ...
- ProbCog mlnlearn的探索
which mlnlearn: /home/panjinbo/Desktop/MLN/probcog/Toolbox/ProbCog-1.1/apps/mlnlearn ==> /home/pa ...
- Java工程师学习指南第4部分:Java并发编程指南
本文整理了微信公众号[Java技术江湖]发表和转载过的Java并发编程相关优质文章,想看到更多Java技术文章,就赶紧关注本公众号吧吧. [纯干货]Java 并发进阶常见面试题总结 [Java基本功] ...
- Vuetify Warning: Unable to locate target [data-app]
今天在大改 nuxt 项目 layout 的时候,将 Vuetify 的 side nav 换成 Element 的折叠式 nav 后,发现了一个 Warning,虽然不影响使用,但是控制台输出一堆, ...
- 《精通并发与Netty》学习笔记(06 - Apache Thrift使用简介)
一.概述 Apache Thrift 是 Facebook 实现的一种高效的.支持多种编程语言的远程服务调用的框架.Thrift是由Facebook开发的,并在2008年捐给了Apache基金会,成为 ...
- Map对象,Set对象使用(1)
Map对象:包含所有类型.可以是对象,函数,或字符串等,本质上是键值对的集合 let m = new Map(); let keyarr = [1,23,"发广告"]; let k ...
- 除了 UCAN 发布的鹿班和普惠体,这些设计工具也来自阿里
在 4 月 27 日的 UCAN 2019 设计大会上,阿里巴巴对外发布了一款全新免费字体——阿里巴巴普惠体.其实,作为经济体的阿里巴巴,这些年早已默默推出了很多实用的设计工具,比如大名鼎鼎的 Ico ...
- java知识随笔整理-数据库的临时表
1.创建临时表的方法 方法一.select * into #临时表名 from 你的表; 方法二. create table #临时表名(字段1 约束条件,字段2 约束条件,.....)create ...